À quelle question répond ce calculateur
Faut-il louer des GPU et faire tourner soi-même un modèle à poids ouverts, ou payer une API au token ? Tout dépend de trois chiffres : le nombre de tokens par seconde que vos GPU produisent réellement, leur taux d’occupation et le nombre de tokens dont vous avez besoin chaque mois. Le calculateur estime le premier à partir de la fiche technique du GPU et de l’architecture du modèle, le convertit en coût par million de tokens et le compare au tarif d’une API pour la même répartition entre tokens de prompt et de sortie.
Comment le débit est estimé
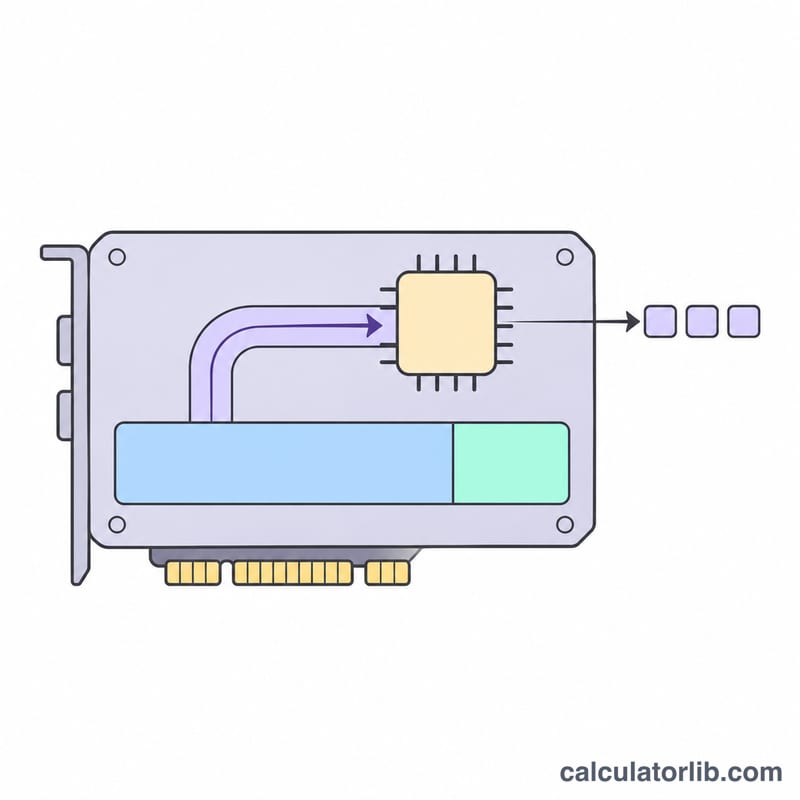
Générer un token pour chaque séquence du batch (une étape de décodage) impose de lire une fois tous les poids du modèle dans la mémoire du GPU, plus le cache clé/valeur (KV) de chaque séquence. Cela coûte aussi environ \( 2N \) opérations en virgule flottante par token pour un modèle de \( N \) paramètres, plus un terme d’attention qui croît avec le contexte (Kaplan et al., 2020, éq. 2.2). D’après le modèle roofline de Williams, Waterman et Patterson, une étape dure autant que la plus lente des deux limites :
$$ t_{\text{step}} = \max\left( \frac{N b + B \bar{S} k}{\eta \, G \, BW},\; \frac{B \, (2N + 2 \, n_{\text{layer}} \bar{S} d)}{m \, G \, F} \right) $$\( b \) est le nombre d’octets par poids, \( B \) le nombre de séquences simultanées, \( \bar{S} \) le contexte moyen pendant le décodage (prompt plus la moitié de la sortie), \( k \) les octets de cache KV par token, \( G \) le nombre de GPU, \( BW \) la bande passante mémoire, \( F \) les FLOPS denses de crête pour la précision, \( \eta \) l’efficacité de la bande passante et \( m \) l’utilisation du calcul (MFU). Le cache KV par token vaut \( k = 2 \, n_{\text{layer}} \, n_{\text{kv}} \, (d / n_{\text{head}}) \, b_{\text{kv}} \).
Le prompt est traité d’abord et en parallèle (prefill), si bien qu’il est en général limité par le calcul. Comme chez Pope et al. (2022), un batch dure le temps du prefill plus une étape de décodage par token de sortie, et le débit en tokens de sortie vaut \( B \) fois les tokens de sortie par requête divisé par cette durée.
Avec de petits batchs, le terme mémoire domine et la vitesse par utilisateur avoisine la bande passante divisée par la taille du modèle. De plus grands batchs partagent chaque lecture des poids entre davantage de séquences : le débit total augmente jusqu’à ce que le cache KV ou le calcul devienne la limite.
Des tokens par seconde au coût par million de tokens
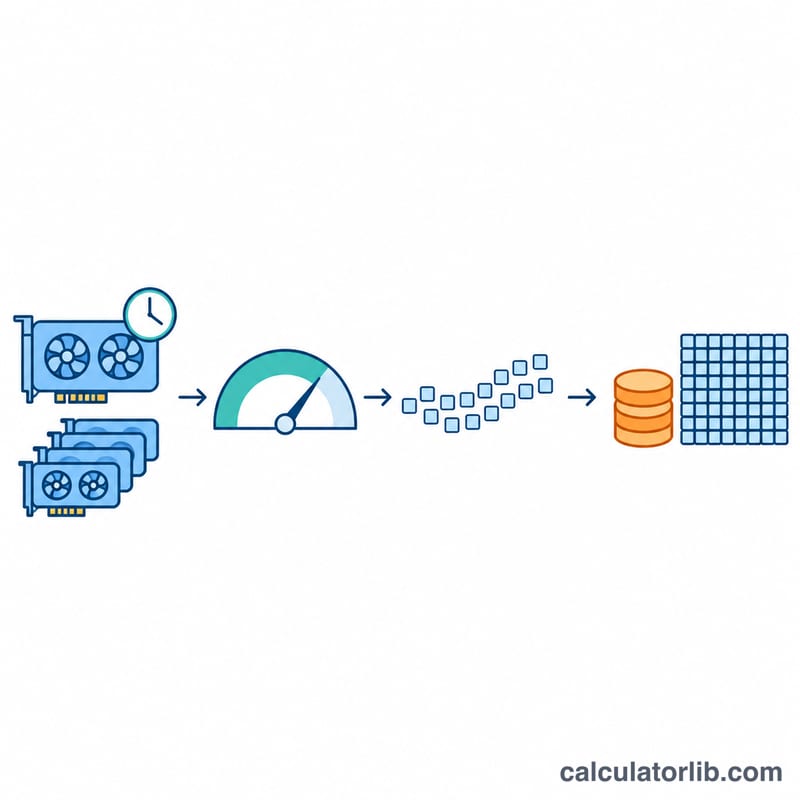
$$ \text{Coût par million de tokens} = \frac{p_{\text{GPU}} \times G}{\text{tokens/s} \times 3600 \times u} \times 10^{6} $$\( p_{\text{GPU}} \) est le prix par heure-GPU et \( u \) le taux d’utilisation moyen : la part des heures payées pendant laquelle les GPU servent au rythme modélisé. Un déploiement occupé la moitié du temps paie deux fois plus cher chaque token. Côté API, les prix d’entrée et de sortie sont pondérés par vos tokens de prompt et de sortie par requête, pour que les deux options soient chiffrées sur les mêmes tokens.
Volume de rentabilité
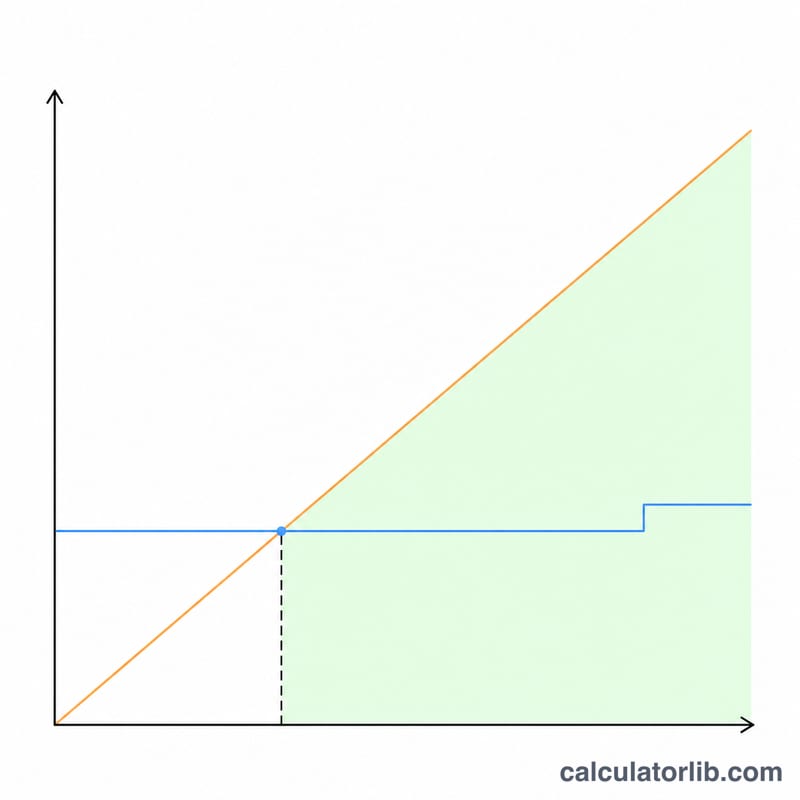
Un déploiement en continu coûte la même somme chaque mois : prix par heure-GPU × nombre de GPU × 730 heures. La facture d’API, elle, augmente avec le volume. Le seuil de rentabilité est le volume mensuel où les deux s’égalisent : le coût mensuel fixe divisé par le prix de l’API par token. Il n’a de sens que si un déploiement peut absorber ce volume ; au-delà de sa capacité, il faut un déploiement de plus, d’où la courbe auto-hébergée en paliers sur le graphique.
Avec les valeurs par défaut (Llama 3 70B en BF16 sur deux GPU H100 SXM à 2,50 USD l’heure-GPU à titre d’exemple, 16 séquences simultanées, 1 500 tokens de prompt et 500 de sortie par requête), l’estimation donne environ 397 tokens de sortie par seconde et 1,75 USD par million de tokens à 50 % d’utilisation. Face à un tarif d’API d’exemple de 1 USD en entrée et 5 USD en sortie par million de tokens, la rentabilité est atteinte vers 1 825 millions de tokens par mois.
Caractéristiques GPU utilisées
Les préréglages reprennent la fiche technique de chaque fabricant. Le débit des tensor cores est souvent annoncé avec sparsité structurée, soit le double du débit dense ; l’inférence courante est dense, donc le tableau et le calculateur utilisent les valeurs denses.
| GPU | Mémoire (Go) | Bande passante (Go/s) | TFLOPS FP16/BF16 denses | TFLOPS FP8 denses |
|---|---|---|---|---|
| NVIDIA H100 SXM5 | 80 | 3,352 | 989.4 | 1,978.9 |
| NVIDIA H100 PCIe | 80 | 2,039 | 756 | 1,513 |
| NVIDIA H200 SXM | 141 | 4,800 | 989.5 | 1,979 |
| NVIDIA A100 80GB SXM | 80 | 2,039 | 312 | — |
| NVIDIA A100 80GB PCIe | 80 | 1,935 | 312 | — |
| NVIDIA L40S | 48 | 864 | 362.05 | 733 |
| NVIDIA L4 | 24 | 300 | 121 | 242.5 |
| AMD Instinct MI300X | 192 | 5,300 | 1,307.45 | 2,614.9 |
Pour un GPU absent de la liste, choisissez « GPU personnalisé » et saisissez sa mémoire, sa bande passante et ses TFLOPS denses.
Ce que l’estimation ne couvre pas
- Les moteurs de service diffèrent : batching continu, cache KV paginé, décodage spéculatif et kernels optimisés peuvent changer fortement le débit. Mesurez votre propre pile et saisissez le résultat.
- Répartir un modèle sur plusieurs GPU ajoute un temps de communication que l’estimation ignore.
- Un modèle mixture-of-experts ne lit que ses experts actifs pour chaque token : saisissez les paramètres actifs pour la vitesse, mais vérifiez la mémoire avec le total.
- Les modèles n’utilisent pas le même tokenizer : un même texte peut donner un nombre de tokens différent.
- L’électricité, le personnel, la capacité de réserve pour les pics et le trafic sortant ne sont pas inclus, sauf si vous les ajoutez au prix horaire.
Pour dimensionner la mémoire GPU plus finement, utilisez le calculateur de VRAM GPU nécessaire.