

Bu hesaplayıcı neyi yanıtlar
GPU kiralayıp açık ağırlıklı bir modeli kendiniz mi çalıştırmalısınız, yoksa token başına ödeme yaptığınız bir API mi kullanmalısınız? Yanıt üç sayıya bağlıdır: GPU’larınızın saniyede gerçekten kaç token ürettiği, onları ne kadar meşgul tuttuğunuz ve ayda kaç tokene ihtiyacınız olduğu. Hesaplayıcı ilk sayıyı GPU veri sayfasından ve modelin yapısından tahmin eder, bunu 1 milyon token maliyetine çevirir ve aynı istem/çıktı token karışımı için bir API fiyatıyla karşılaştırır.
Verim nasıl tahmin edilir
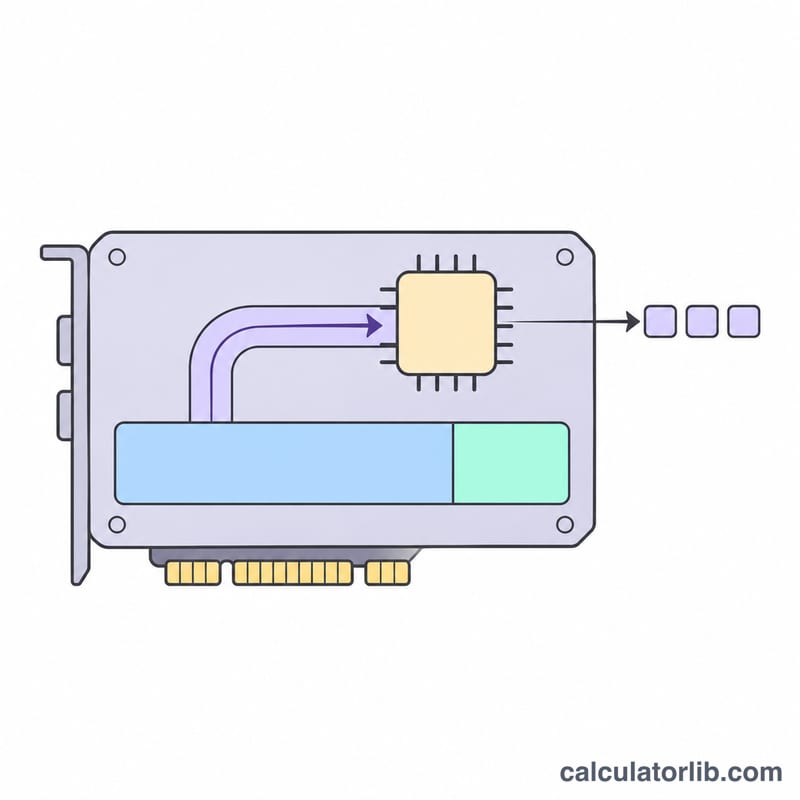
Batch’teki her dizi için birer token üretmek (bir decode adımı), modelin tüm ağırlıklarını GPU belleğinden bir kez okumayı ve her dizinin anahtar/değer (KV) önbelleğini okumayı gerektirir. Ayrıca \( N \) parametreli bir model için token başına yaklaşık \( 2N \) kayan nokta işlemi ve bağlamla büyüyen bir dikkat terimi gerekir (Kaplan vd., 2020, denklem 2.2). Williams, Waterman ve Patterson’ın roofline modeline göre bir adım, iki sınırdan yavaş olanı kadar sürer:
$$ t_{\text{step}} = \max\left( \frac{N b + B \bar{S} k}{\eta \, G \, BW},\; \frac{B \, (2N + 2 \, n_{\text{layer}} \bar{S} d)}{m \, G \, F} \right) $$\( b \) ağırlık başına bayt, \( B \) eşzamanlı dizi sayısı, \( \bar{S} \) decode sırasında ortalama bağlam (istem artı çıktının yarısı), \( k \) token başına KV önbelleği baytı, \( G \) GPU sayısı, \( BW \) bellek bant genişliği, \( F \) seçilen hassasiyette yoğun tepe FLOPS, \( \eta \) bant genişliği verimi ve \( m \) hesaplama kullanım oranıdır (MFU). Token başına KV önbelleği \( k = 2 \, n_{\text{layer}} \, n_{\text{kv}} \, (d / n_{\text{head}}) \, b_{\text{kv}} \) olur.
İstem önce ve paralel olarak işlenir (prefill), bu yüzden genellikle hesaplama gücüyle sınırlıdır. Pope vd. (2022) ile aynı şekilde, bir batch prefill süresi artı her çıktı tokeni için bir decode adımı kadar sürer; saniye başına çıktı token sayısı \( B \) ile istek başına çıktı tokeninin çarpımının bu süreye bölünmesidir.
Küçük batch’lerde bellek terimi baskındır ve kullanıcı başına hız yaklaşık bant genişliği bölü model boyutudur. Daha büyük batch’ler her ağırlık okumasını daha çok diziye paylaştırır; toplam verim, KV önbelleği ya da hesaplama gücü sınır olana kadar artar.
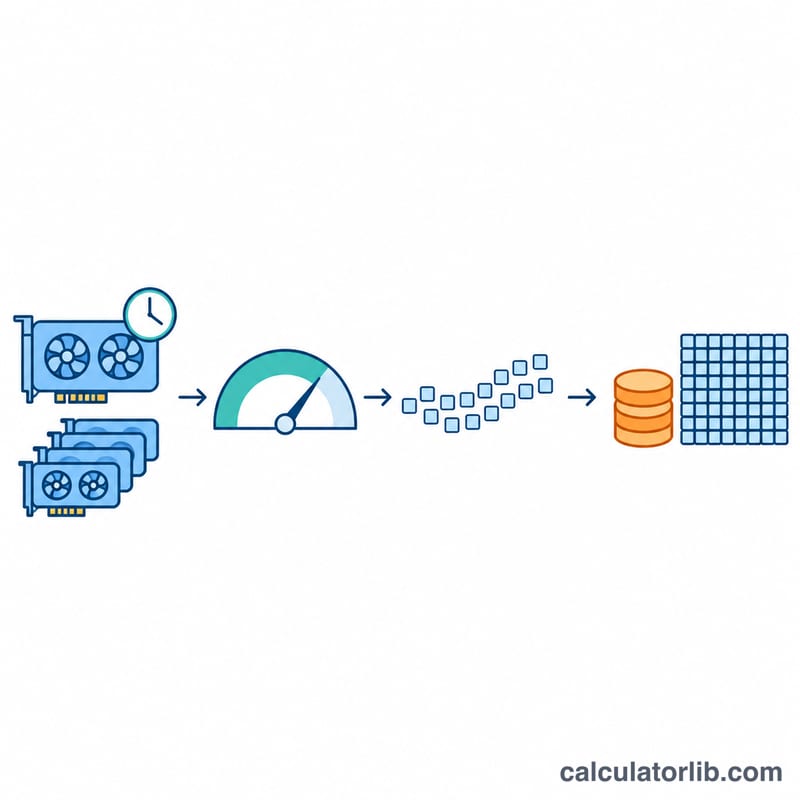
Saniye başına tokenden 1 milyon token maliyetine
$$ \text{1 milyon token maliyeti} = \frac{p_{\text{GPU}} \times G}{\text{token/sn} \times 3600 \times u} \times 10^{6} $$\( p_{\text{GPU}} \) GPU-saat fiyatı, \( u \) ise ortalama kullanım oranıdır: ödenen saatlerin GPU’ların modellenen hızda hizmet verdiği kısmı. Zamanın yarısında meşgul olan bir yapılandırma token başına iki kat öder. API tarafında girdi ve çıktı fiyatları, istek başına istem ve çıktı tokenlerinizle ağırlıklandırılır; böylece iki seçenek aynı tokenler üzerinden fiyatlanır.
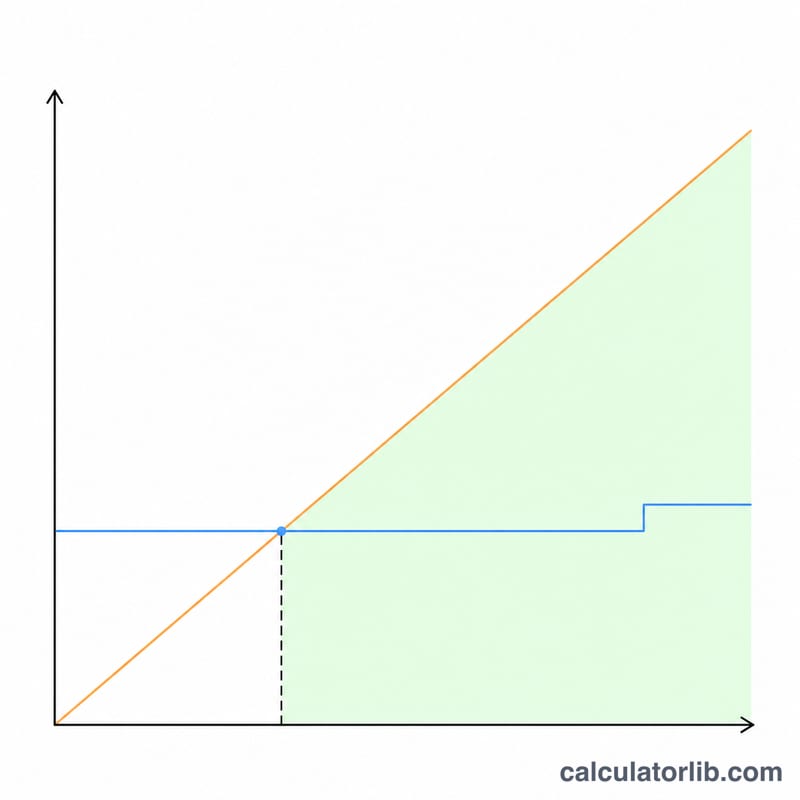
Başa baş hacmi
Sürekli açık bir yapılandırma her ay aynı tutardadır: GPU-saat fiyatı × GPU sayısı × 730 saat. API faturası ise hacimle birlikte büyür. Başa baş noktası ikisinin eşitlendiği aylık hacimdir, yani sabit aylık maliyetin API token fiyatına bölümü. Bu ancak tek bir yapılandırma o hacmi karşılayabiliyorsa geçerlidir; kapasite aşılınca yeni bir yapılandırma gerekir, grafikteki kendi sunucu çizgisinin basamak basamak yükselmesinin nedeni budur.
Varsayılan değerlerle (Llama 3 70B, BF16, iki H100 SXM GPU, örnek fiyat GPU-saat başına 2,50 USD, 16 eşzamanlı dizi, istek başına 1.500 istem ve 500 çıktı tokeni) tahmin saniyede yaklaşık 397 çıktı tokeni ve %50 kullanım oranında 1 milyon token başına 1,75 USD’dir. 1 milyon token başına 1 USD girdi ve 5 USD çıktı olan örnek bir API fiyatına karşı başa baş noktası ayda yaklaşık 1.825 milyon tokendir.
Kullanılan GPU değerleri
Hazır ayarlar her üreticinin kendi veri sayfasından alınmıştır. Tensör verimi çoğu zaman yapısal seyreklikle verilir; bu, yoğun (dense) hızın iki katıdır. Olağan çıkarım yoğun çalıştığından tablo ve hesaplayıcı yoğun değerleri kullanır.
| GPU | Bellek (GB) | Bant genişliği (GB/s) | Yoğun FP16/BF16 TFLOPS | Yoğun FP8 TFLOPS |
|---|---|---|---|---|
| NVIDIA H100 SXM5 | 80 | 3,352 | 989.4 | 1,978.9 |
| NVIDIA H100 PCIe | 80 | 2,039 | 756 | 1,513 |
| NVIDIA H200 SXM | 141 | 4,800 | 989.5 | 1,979 |
| NVIDIA A100 80GB SXM | 80 | 2,039 | 312 | — |
| NVIDIA A100 80GB PCIe | 80 | 1,935 | 312 | — |
| NVIDIA L40S | 48 | 864 | 362.05 | 733 |
| NVIDIA L4 | 24 | 300 | 121 | 242.5 |
| AMD Instinct MI300X | 192 | 5,300 | 1,307.45 | 2,614.9 |
Listede olmayan bir GPU için “Özel GPU”yu seçip belleğini, bant genişliğini ve yoğun TFLOPS değerini girin.
Tahminin kapsamadıkları
- Sunum motorları farklıdır: continuous batching, sayfalı KV önbelleği, spekülatif decode ve optimize çekirdekler verimi büyük ölçüde değiştirebilir. Kendi altyapınızı ölçüp sonucu girin.
- Bir modeli birden çok GPU’ya bölmek, tahminin hesaba katmadığı iletişim süresi ekler.
- Mixture-of-experts modeli her tokende yalnızca etkin uzmanları okur: hız için etkin parametreleri girin, belleği ise toplamla kontrol edin.
- Modeller farklı tokenizer kullanır; aynı metin farklı sayıda tokene karşılık gelebilir.
- Elektrik, personel, yoğun saatler için yedek kapasite ve dışa veri aktarımı, saatlik fiyata eklemediğiniz sürece dahil değildir.
GPU belleğini daha ayrıntılı hesaplamak için GPU VRAM ihtiyacı hesaplayıcısını kullanın.
















