
LLM セルフホスト vs API コスト計算ツール

LLM セルフホスト vs API コスト計算ツール

新興 AI Skill PRO

計算を入力してください

GPU 構成

時間単価は例です。クラウドの見積もり単価、または自社ハードウェアの償却コストを入力してください。

モデル

初期値は Llama 3 70B(80 レイヤー、次元 8,192、ヘッド 64、キー/バリューヘッド 8)です。使うモデルの値は設定ファイルや論文から転記してください。

GPU の必要 VRAM 計算ツール

ワークロード

効率

2 つの効率は変更可能な仮定値で、実測値ではありません。実際のバッチサイズで自社のサービング環境をベンチマークした値が最も確かな入力です。

比較する API

公式

100 万トークンあたりコスト=GPU 時間単価×Gトークン/秒×3600×u×106\text{100 万トークンあたりコスト} = \dfrac{\text{GPU 時間単価} \times G}{\text{トークン/秒} \times 3600 \times u} \times 10^{6}
計算手順を表示 (3)
  1. デコード 1 ステップの時間(ルーフライン)

    tstep=max⁡(Nb+BS‾kηGBW,B(2N+2nlayerS‾d)mGF)t_{\text{step}} = \max\left(\dfrac{N b + B \bar{S} k}{\eta\, G\, BW},\; \dfrac{B (2N + 2\, n_{\text{layer}} \bar{S} d)}{m\, G\, F}\right)

    1 回のデコードでは重み(N·b バイト)と全シーケンスの KV キャッシュ(B·S̄·k バイト)を実効帯域 η·G·BW で読み、B·(2N + 2·n_layer·S̄·d) FLOP を m·G·F で計算します。遅い方がステップ時間を決めます(Williams・Waterman・Patterson、Kaplan ほか 2020 式 2.2)。

  2. トークンあたりの KV キャッシュ

    k=2nlayernkvdnheadbkvk = 2\, {{n_{\text{layer}}}}\, {{n_{\text{kv}}}}\, \dfrac{d}{{{n_{\text{head}}}}}\, b_{\text{kv}}

    全レイヤーのキーとバリュー:サイズ d ÷ n_head のキー/バリューヘッドが n_kv 個、1 値あたり b_kv バイト。

  3. 月間の損益分岐量

    V∗=pGPU×G×730pAPI/106V^{*} = \dfrac{{{p_{\text{GPU}}}} \times G \times 730}{p_{\text{API}} / 10^{6}}

    常時稼働する構成の月額固定費(GPU 時間単価 × G × 730 時間)を、プロンプト/出力比率で加重した API のトークン単価で割った値。1 構成の処理能力を下回るときだけ到達できます。

利用統計

広告

結果

セルフホストの 100 万トークンあたりコスト
$1.75
入力+出力トークン、指定した稼働率で
API の 100 万トークンあたりコスト
$2.00
Claude Haiku 4.5
あなたの月間量で安いのは: API
月額の差: $1,650
損益分岐の月間量(常時稼働): 1,825 百万トークン/月
出力トークン/秒
397
推定値、構成全体
ユーザーあたりの速度(デコード)
31.5
トークン/秒(1 シーケンス)
全トークン/秒
1,587
プロンプト+出力
セルフホストの出力 100 万トークンあたりコスト
$7.00
プロンプト処理を含む
API の出力 100 万トークンあたりコスト
$8.00
対応するプロンプト分を含む
1 構成あたりの処理能力
2,085
百万トークン/月

あなたの月間量での月額コスト

月間量(100 万トークン) 1,000
GPU の時間コスト(全 GPU) $5.00
必要な構成数 1
セルフホスト、常時稼働(730 時間) $3,650.00
API $2,000.00

コスト曲線

月間トークン量ごとの月額コスト 02,0004,0006,000 01,0002,000
セルフホスト(段差 = 構成の追加) API あなたの月間量 損益分岐点

横軸:月間 100 万トークン。縦軸:月額(米ドル)。

スループットの推定

GPU NVIDIA H100 SXM5 80GB × 2
デコードのボトルネック メモリ帯域
デコード 1 ステップのメモリ時間(ms)
31.79
デコード 1 ステップの演算時間(ms)
2.88
1 バッチのプリフィル時間(ms) 4,275
推定出力トークン/秒 397
使用したピーク TFLOPS(密、GPU 1 台) 989.4

メモリの確認

モデルの重み(GB) 140.0
トークンあたりの KV キャッシュ(MB) 0.328
KV キャッシュ(全シーケンスが最大長のとき、GB) 10.5
必要量 / 搭載量(GB)
150.5 / 160
GPU メモリに収まるか はい
収まる最大シーケンス数 30

ランタイムのバッファ、アクティベーション、断片化にもメモリが必要なので、余裕を持たせてください。

使用した API 料金

入力 100 万トークンあたりの料金 $1.00
出力 100 万トークンあたりの料金 $5.00
出力 1 トークンあたりのプロンプトトークン 3

定価の出典: BerriAI (LiteLLM), 2026-11-02

同じプロンプト/出力比率でのほかの API モデル

モデル 100 万トークンあたり 月額
Gemini 2.5 Flash-Lite $0.17 $175
Claude Haiku 5.5 $0.20 $200
gpt-6-luna $0.20 $200
DeepSeek Flash (off-peak) $0.26 $263
deepseek-flash $0.53 $525
Mistral Large $0.75 $750
Gemini 3.5 Flash-Lite $0.85 $850
Gemini 2.5 Flash $0.85 $850
DeepSeek V4 Pro (off-peak) $0.99 $990
Gemini 3.8 Flash $1.50 $1,500
deepseek-v4-pro $1.98 $1,980
Claude Haiku 4.5 $2.00 $2,000
gpt-6.1-terra $2.00 $2,000
Gemini 2.5 Pro $3.44 $3,438
Claude Sonnet 5.5 $4.00 $4,000
gpt-6.1-sol $4.00 $4,000
Gemini 4 Argon $4.00 $4,000
Gemini 3.1 Pro Preview $4.50 $4,500
Claude Sonnet 4.6 $6.00 $6,000
Claude Opus 5.5 $8.00 $8,000
Claude Opus 5 $10.00 $10,000
Claude Fable 5.1 $20.00 $20,000
gpt-6-astra $20.00 $20,000

青:あなたの月間量ではセルフホストより安い。オレンジ:セルフホストの方が安い。

データシートのピーク値(密、スパース性なし)と効率の仮定に基づく推定です。実際のスループットはサービングエンジン、カーネル、トラフィックで変わるため、判断には実測値を入力してください。

このページの誤りを報告

この計算ツールでわかること

GPU を借りてオープンウェイトのモデルを自分で動かすべきか、それともトークン課金の API を使うべきか。答えを左右するのは 3 つの数字です。GPU が実際に何トークン/秒を生成するか、どれだけ稼働させ続けられるか、そして毎月何トークン必要か。このツールは 1 つ目を GPU のデータシートとモデルの構造から推定し、100 万トークンあたりのコストに換算して、同じプロンプト/出力トークン比率での API 料金と比べます。

スループットの推定方法

バッチ内のすべてのシーケンスについて 1 トークンずつ生成する処理(デコード 1 ステップ)では、モデルの全重みを GPU メモリから 1 回読み、さらに各シーケンスのキー/バリュー(KV)キャッシュを読みます。演算量は \( N \) パラメータのモデルで 1 トークンあたり約 \( 2N \) 回の浮動小数点演算に、文脈長に比例するアテンション項を加えたものです(Kaplan ほか、2020、式 2.2)。Williams・Waterman・Patterson のルーフラインモデルによれば、1 ステップの時間は 2 つの上限のうち遅い方で決まります。

$$ t_{\text{step}} = \max\left( \frac{N b + B \bar{S} k}{\eta \, G \, BW},\; \frac{B \, (2N + 2 \, n_{\text{layer}} \bar{S} d)}{m \, G \, F} \right) $$

\( b \) は重み 1 つあたりのバイト数、\( B \) は同時実行シーケンス数、\( \bar{S} \) はデコード中の平均文脈長(プロンプト+出力の半分)、\( k \) はトークンあたりの KV キャッシュのバイト数、\( G \) は GPU 台数、\( BW \) はメモリ帯域幅、\( F \) はその精度での密なピーク FLOPS、\( \eta \) は帯域の実効率、\( m \) は演算効率(MFU)です。トークンあたりの KV キャッシュは \( k = 2 \, n_{\text{layer}} \, n_{\text{kv}} \, (d / n_{\text{head}}) \, b_{\text{kv}} \) です。

プロンプトは先にまとめて並列処理(プリフィル)されるため、通常は演算性能が律速になります。Pope ほか(2022)と同じく、1 バッチの時間はプリフィル時間に出力トークン数ぶんのデコードステップを足したもので、出力トークン/秒は \( B \) × リクエストあたりの出力トークン数 ÷ バッチ時間です。

バッチが小さいとメモリ項が支配的で、ユーザーあたりの速度はおおよそ帯域幅 ÷ モデルサイズになります。バッチを大きくすると 1 回の重み読み込みを多くのシーケンスで共有できるため、KV キャッシュか演算性能が上限になるまで合計スループットが伸びます。
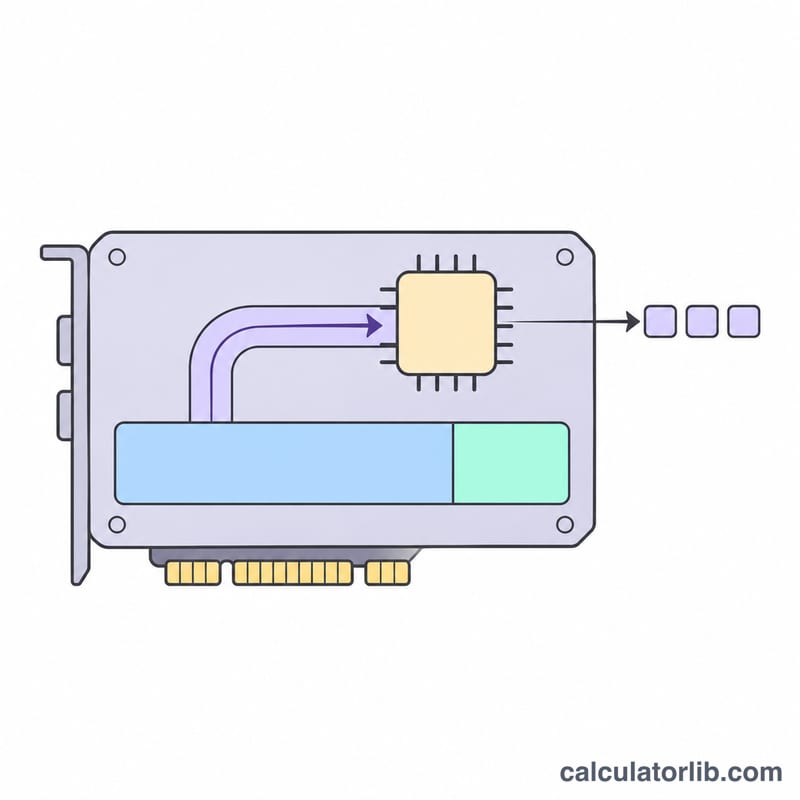
メモリがモデルの重みとKVキャッシュに分かれ、帯域幅のパイプが演算チップにデータを送るGPUのイラスト
デコード速度は主にGPUがメモリからモデルの重みをどれだけ速く読み出せるかで決まるため、メモリ帯域幅がスループットの上限を決めます。

トークン/秒から 100 万トークンあたりコストへ

$$ \text{100 万トークンあたりコスト} = \frac{p_{\text{GPU}} \times G}{\text{トークン/秒} \times 3600 \times u} \times 10^{6} $$

\( p_{\text{GPU}} \) は GPU 1 時間あたりの料金、\( u \) は平均稼働率で、支払った時間のうち GPU がモデル化した速度で処理している割合です。半分の時間しか稼働しない構成では、トークン単価が 2 倍になります。API 側は入力と出力の料金をリクエストあたりのプロンプト/出力トークン数で加重するので、両者を同じトークン量で比べられます。
広告
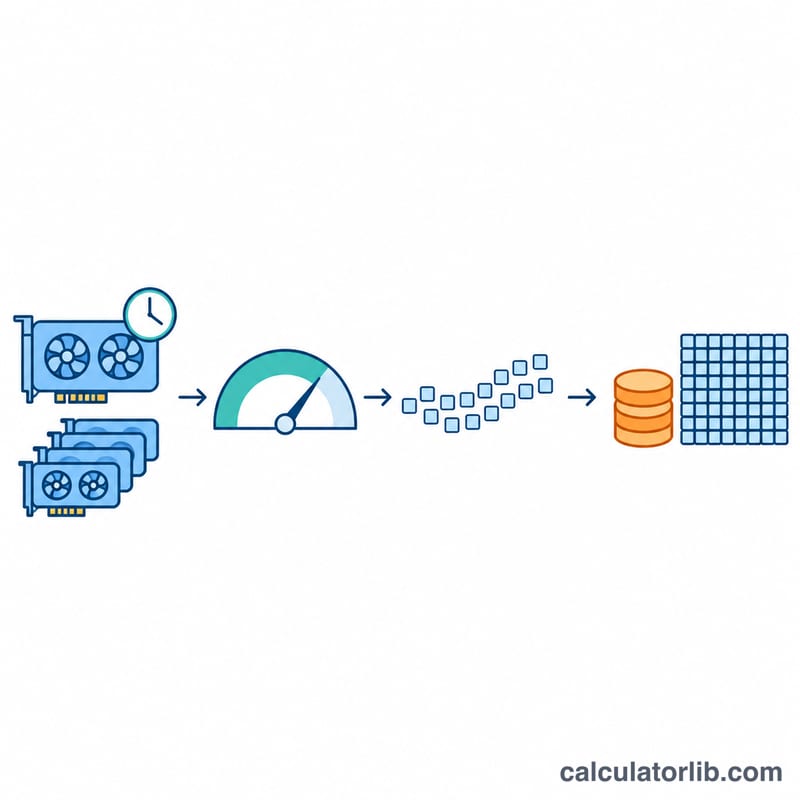
GPU時間単価とGPU台数を稼働率とスループットで調整し、100万トークンあたりのコストに変換するフロー図
自己ホスト時の100万トークンあたりのコスト:GPU時間あたりのコストを、実際の稼働率で1時間に生成されたトークン数で割った値です。

損益分岐量

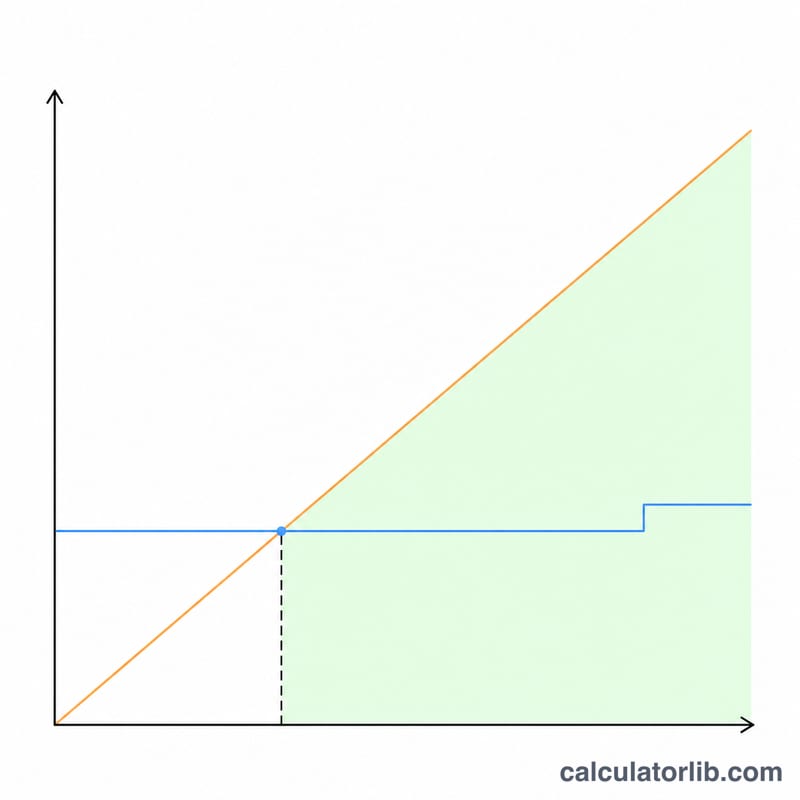
常時稼働する構成の月額は一定で、GPU 時間単価 × GPU 台数 × 730 時間です。一方、API の請求額は量に比例して増えます。損益分岐点は両者が等しくなる月間量、つまり月額固定費 ÷ API のトークン単価です。ただし 1 つの構成でその量を処理できる場合に限ります。処理能力を超えると構成を追加する必要があるため、グラフのセルフホストの線は階段状に上がります。

初期値(Llama 3 70B を BF16 で H100 SXM 2 台に載せ、例として GPU 1 時間 2.50 USD、同時 16 シーケンス、リクエストあたりプロンプト 1,500・出力 500 トークン)では、出力は約 397 トークン/秒、稼働率 50% で 100 万トークンあたり 1.75 USD と推定されます。例として入力 1 USD・出力 5 USD(100 万トークンあたり)の API と比べると、損益分岐は月約 18 億 2,500 万トークンです。
広告
右肩上がりのAPIコスト線が、水平な自己ホストコスト線と損益分岐点の処理量で交わる折れ線グラフ
損益分岐点:月間の処理量が交差点を超えると、固定費のGPUの方がトークン課金のAPIより安くなります。

使用している GPU の数値

プリセットは各メーカーのデータシートの値です。Tensor 演算性能は構造化スパース性込みで公表されることが多く、その値は密な演算の 2 倍です。通常の推論は密な演算なので、表と計算には密な値を使っています。

GPU メモリ(GB) 帯域幅(GB/s) FP16/BF16 TFLOPS(密) FP8 TFLOPS(密)
NVIDIA H100 SXM5 80 3,352 989.4 1,978.9
NVIDIA H100 PCIe 80 2,039 756 1,513
NVIDIA H200 SXM 141 4,800 989.5 1,979
NVIDIA A100 80GB SXM 80 2,039 312 —
NVIDIA A100 80GB PCIe 80 1,935 312 —
NVIDIA L40S 48 864 362.05 733
NVIDIA L4 24 300 121 242.5
AMD Instinct MI300X 192 5,300 1,307.45 2,614.9

一覧にない GPU は「カスタム GPU」を選び、メモリ、帯域幅、密な TFLOPS を入力してください。

推定に含まれないもの

  • サービングエンジンによって差があります。continuous batching、paged KV キャッシュ、投機的デコード、最適化カーネルでスループットは大きく変わるので、自社環境で測って入力してください。
  • モデルを複数 GPU に分割すると通信時間が増えますが、推定には含めていません。
  • Mixture-of-Experts モデルはトークンごとにアクティブなエキスパートだけを読みます。速度にはアクティブパラメータ数を入れ、メモリは総パラメータ数で確認してください。
  • モデルごとにトークナイザーが異なるため、同じ文章でもトークン数が変わります。
  • 電力、人件費、ピーク用の予備容量、外向き通信費は、時間単価に上乗せしない限り含まれません。

GPU メモリをより詳しく見積もるには GPU の必要 VRAM 計算ツールをお使いください。

出典・参考資料

最終更新:

業界固有で人気の電卓

業界固有の電卓をすべて見る















