
Калькулятор стоимости: свой LLM-сервер или API

Калькулятор стоимости: свой LLM-сервер или API

Развивающийся AI Skill PRO

Введите расчет

Конфигурация GPU

Почасовая цена указана для примера. Введите ставку из предложения облачного провайдера или амортизированную стоимость своего оборудования.

Модель

По умолчанию — Llama 3 70B (80 слоёв, размерность 8192, 64 головы, 8 голов key/value). Значения для своей модели возьмите из её конфигурационного файла или статьи.

Калькулятор требуемой видеопамяти GPU

Нагрузка

Эффективность

Оба значения эффективности — изменяемые допущения, а не измерения. Лучшие исходные данные дают замеры вашего собственного стека инференса при вашем размере батча.

API для сравнения

Математическая формула

Стоимость 1 млн токенов=Цена GPU-часа×Gтокенов/с×3600×u×106\text{Стоимость 1 млн токенов} = \dfrac{\text{Цена GPU-часа} \times G}{\text{токенов/с} \times 3600 \times u} \times 10^{6}
Показать шаги расчёта (3)
  1. Время шага декодирования (roofline)

    tstep=max⁡(Nb+BS‾kηGBW,B(2N+2nlayerS‾d)mGF)t_{\text{step}} = \max\left(\dfrac{N b + B \bar{S} k}{\eta\, G\, BW},\; \dfrac{B (2N + 2\, n_{\text{layer}} \bar{S} d)}{m\, G\, F}\right)

    Шаг декодирования читает веса (N·b байт) и KV-кэш всех последовательностей (B·S̄·k байт) с фактической ПСП η·G·BW и выполняет B·(2N + 2·n_layer·S̄·d) FLOP со скоростью m·G·F. Более медленное из двух задаёт время шага (Williams, Waterman и Patterson; Kaplan и др. 2020, ур. 2.2).

  2. KV-кэш на токен

    k=2nlayernkvdnheadbkvk = 2\, {{n_{\text{layer}}}}\, {{n_{\text{kv}}}}\, \dfrac{d}{{{n_{\text{head}}}}}\, b_{\text{kv}}

    Ключи и значения всех слоёв: n_kv голов key/value размером d ÷ n_head, по b_kv байт на значение.

  3. Месячный объём безубыточности

    V∗=pGPU×G×730pAPI/106V^{*} = \dfrac{{{p_{\text{GPU}}}} \times G \times 730}{p_{\text{API}} / 10^{6}}

    Фиксированные месячные затраты круглосуточной конфигурации (цена GPU-часа × G × 730 ч), делённые на цену API за токен при вашем соотношении промпта и выхода. Достижим, только если меньше мощности одной конфигурации.

Статистика использования

Реклама

Результаты

Своя инфраструктура: стоимость 1 млн токенов
$1,75
входные + выходные токены, при вашей загрузке
API: стоимость 1 млн токенов
$2,00
Claude Haiku 4.5
Дешевле при вашем месячном объёме: API
Разница в месяц: $1 650
Объём безубыточности (круглосуточно): 1 825 млн токенов в месяц
Выходных токенов в секунду
397
оценка, вся конфигурация
Скорость на пользователя (декодирование)
31,5
токенов/с на последовательность
Всего токенов в секунду
1 587
промпт + выход
Своя инфраструктура: 1 млн выходных токенов
$7,00
с учётом обработки промпта
API: 1 млн выходных токенов
$8,00
вместе с нужными промптами
Мощность одной конфигурации
2 085
млн токенов в месяц

Месячные затраты при вашем объёме

Месячный объём (млн токенов) 1 000
Стоимость GPU в час (все GPU) $5,00
Нужно конфигураций 1
Своя инфраструктура, круглосуточно (730 ч) $3 650,00
API $2 000,00

Кривая затрат

Месячные затраты в зависимости от объёма токенов 02 0004 0006 000 01 0002 000
Своя инфраструктура (ступень = ещё одна конфигурация) API Ваш объём Точка безубыточности

По горизонтали — млн токенов в месяц, по вертикали — доллары США в месяц.

Оценка производительности

GPU NVIDIA H100 SXM5 80GB × 2
Декодирование ограничено пропускной способностью памяти
Время памяти на шаг декодирования (мс)
31,79
Время вычислений на шаг декодирования (мс)
2,88
Время prefill для одного батча (мс) 4 275
Оценка выходных токенов в секунду 397
Пиковые TFLOPS (dense) в расчёте (на GPU) 989,4

Проверка памяти

Веса модели (ГБ) 140,0
KV-кэш на токен (МБ) 0,328
KV-кэш, все последовательности полной длины (ГБ) 10,5
Нужно / доступно (ГБ)
150,5 / 160
Помещается в память GPU да
Максимум последовательностей 30

Буферы среды выполнения, активации и фрагментация тоже занимают память, поэтому оставьте запас.

Использованная цена API

Цена входа за 1 млн токенов $1,00
Цена выхода за 1 млн токенов $5,00
Токенов промпта на выходной токен 3

Прейскурантная цена: BerriAI (LiteLLM), 2026-11-02

Другие модели API при том же соотношении промпта и выхода

Модель За 1 млн токенов В месяц
Gemini 2.5 Flash-Lite $0,17 $175
Claude Haiku 5.5 $0,20 $200
gpt-6-luna $0,20 $200
DeepSeek Flash (off-peak) $0,26 $263
deepseek-flash $0,53 $525
Mistral Large $0,75 $750
Gemini 3.5 Flash-Lite $0,85 $850
Gemini 2.5 Flash $0,85 $850
DeepSeek V4 Pro (off-peak) $0,99 $990
Gemini 3.8 Flash $1,50 $1 500
deepseek-v4-pro $1,98 $1 980
Claude Haiku 4.5 $2,00 $2 000
gpt-6.1-terra $2,00 $2 000
Gemini 2.5 Pro $3,44 $3 438
Claude Sonnet 5.5 $4,00 $4 000
gpt-6.1-sol $4,00 $4 000
Gemini 4 Argon $4,00 $4 000
Gemini 3.1 Pro Preview $4,50 $4 500
Claude Sonnet 4.6 $6,00 $6 000
Claude Opus 5.5 $8,00 $8 000
Claude Opus 5 $10,00 $10 000
Claude Fable 5.1 $20,00 $20 000
gpt-6-astra $20,00 $20 000

Синий — дешевле своей инфраструктуры при вашем объёме. Оранжевый — своя инфраструктура дешевле.

Оценка по пиковым значениям из спецификаций (dense, без разреженности) и вашим допущениям об эффективности. Реальная производительность зависит от движка инференса, ядер и трафика; для решения введите измеренное значение.

Сообщить об ошибке на этой странице

На какой вопрос отвечает калькулятор

Арендовать GPU и запускать модель с открытыми весами самому или платить API за каждый токен? Ответ зависит от трёх чисел: сколько токенов в секунду реально выдают ваши GPU, насколько плотно они загружены и сколько токенов нужно в месяц. Калькулятор оценивает первое число по спецификации GPU и устройству модели, переводит его в стоимость 1 млн токенов и сравнивает с ценой API при том же соотношении токенов промпта и выхода.

Как оценивается производительность

Чтобы сгенерировать по одному токену для каждой последовательности батча (шаг декодирования), нужно один раз прочитать из памяти GPU все веса модели и KV-кэш (ключи и значения) каждой последовательности. Кроме того, на токен приходится около \( 2N \) операций с плавающей точкой для модели с \( N \) параметрами плюс слагаемое внимания, растущее с длиной контекста (Kaplan и др., 2020, ур. 2.2). Согласно модели roofline Уильямса, Уотермана и Паттерсона, шаг длится столько, сколько более медленное из двух ограничений:

$$ t_{\text{step}} = \max\left( \frac{N b + B \bar{S} k}{\eta \, G \, BW},\; \frac{B \, (2N + 2 \, n_{\text{layer}} \bar{S} d)}{m \, G \, F} \right) $$

Здесь \( b \) — байт на вес, \( B \) — число одновременных последовательностей, \( \bar{S} \) — средний контекст при декодировании (промпт плюс половина выхода), \( k \) — байт KV-кэша на токен, \( G \) — число GPU, \( BW \) — пропускная способность памяти, \( F \) — пиковые FLOPS (dense) для выбранной точности, \( \eta \) — эффективность использования ПСП, \( m \) — загрузка вычислений (MFU). KV-кэш на токен равен \( k = 2 \, n_{\text{layer}} \, n_{\text{kv}} \, (d / n_{\text{head}}) \, b_{\text{kv}} \).

Промпт обрабатывается сначала и параллельно (prefill), поэтому обычно упирается в вычисления. Как у Pope и др. (2022), батч занимает время prefill плюс один шаг декодирования на каждый выходной токен, а выходные токены в секунду равны \( B \), умноженному на выходные токены запроса и делённому на время батча.

При малых батчах доминирует слагаемое памяти, и скорость на пользователя близка к ПСП, делённой на размер модели. Большие батчи делят каждое чтение весов между большим числом последовательностей, поэтому общая производительность растёт, пока пределом не станут KV-кэш или вычисления.
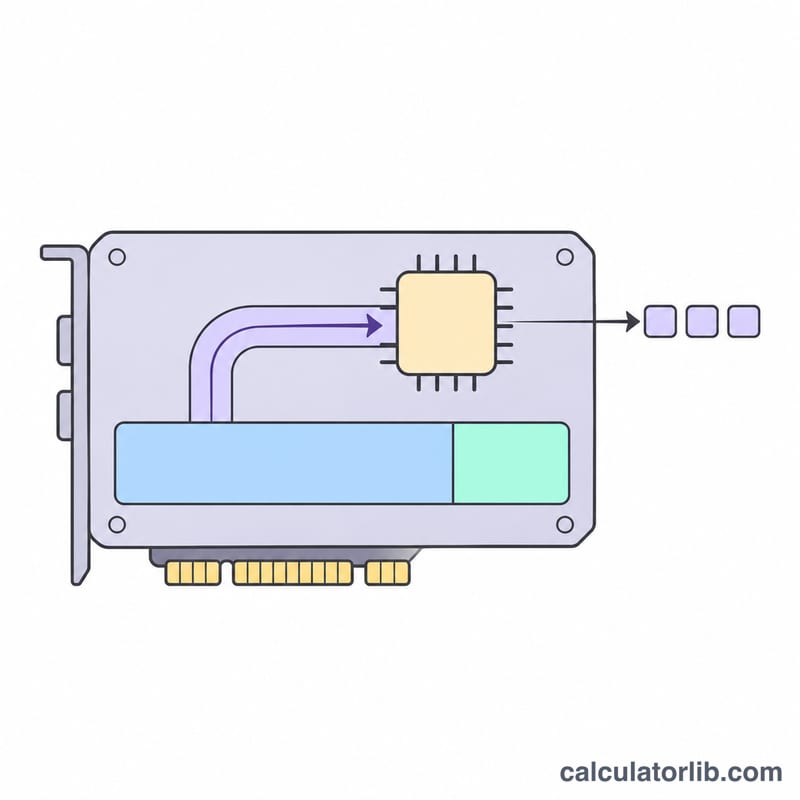
Иллюстрация GPU, где память разделена между весами модели и KV-кэшем, а канал пропускной способности питает вычислительный чип
Скорость декодирования в основном зависит от того, как быстро GPU считывает веса модели из памяти, поэтому потолок пропускной способности задаёт именно полоса памяти.

От токенов в секунду к стоимости 1 млн токенов

$$ \text{Стоимость 1 млн токенов} = \frac{p_{\text{GPU}} \times G}{\text{токенов/с} \times 3600 \times u} \times 10^{6} $$

\( p_{\text{GPU}} \) — цена GPU-часа, \( u \) — средняя загрузка, то есть доля оплаченных часов, в которые GPU обслуживают запросы с расчётной скоростью. Конфигурация, занятая половину времени, платит за токен вдвое больше. Для API цены входа и выхода взвешиваются по вашим токенам промпта и выхода на запрос, так что обе стороны считаются по одним и тем же токенам.
Реклама
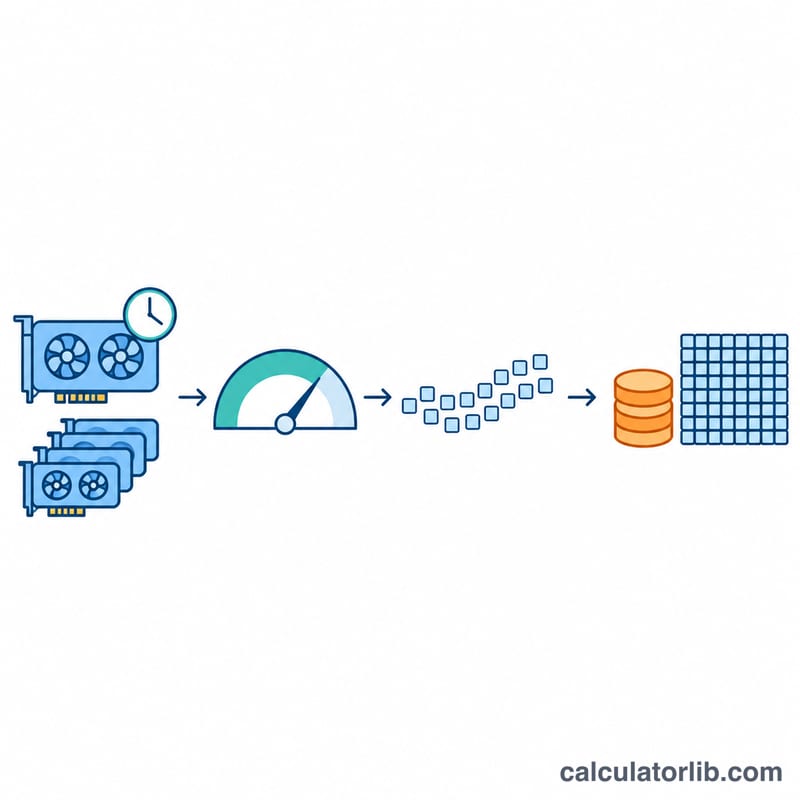
Блок-схема, где цена GPU-часа и число GPU, скорректированные на загрузку и пропускную способность, превращаются в стоимость за миллион токенов
Стоимость self-hosted за 1 млн токенов: цена GPU-часа, делённая на число токенов, реально сгенерированных за час при вашей загрузке.

Объём безубыточности

Круглосуточная конфигурация каждый месяц стоит одинаково: цена GPU-часа × число GPU × 730 часов. Счёт за API растёт вместе с объёмом. Точка безубыточности — месячный объём, при котором затраты равны: фиксированные месячные затраты, делённые на цену API за токен. Она имеет смысл, только если одна конфигурация способна обслужить такой объём; сверх её мощности нужна ещё одна конфигурация, поэтому линия своей инфраструктуры на графике растёт ступенями.

При значениях по умолчанию (Llama 3 70B в BF16 на двух H100 SXM по примерной цене 2,50 USD за GPU-час, 16 одновременных последовательностей, 1500 токенов промпта и 500 выходных токенов на запрос) оценка — около 397 выходных токенов в секунду и 1,75 USD за 1 млн токенов при загрузке 50 %. По сравнению с примерной ценой API 1 USD за вход и 5 USD за выход на 1 млн токенов безубыточность наступает примерно при 1825 млн токенов в месяц.
Реклама
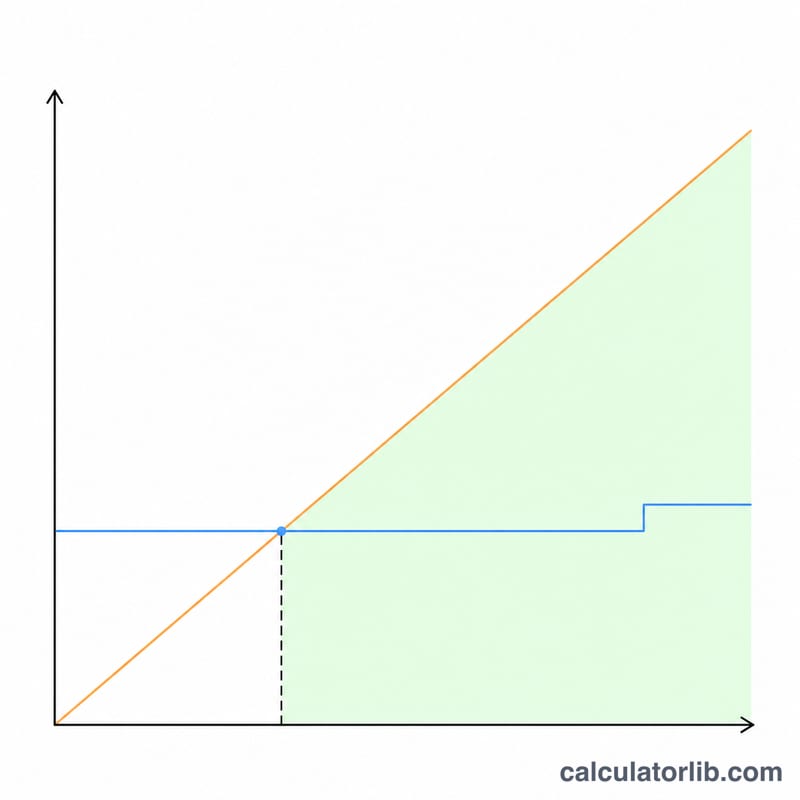
Линейный график, где растущая линия стоимости API пересекает горизонтальную линию стоимости self-hosted в точке безубыточности
Точка безубыточности: как только месячный объём превышает точку пересечения, GPU с фиксированной стоимостью оказывается дешевле оплаты API за токен.

Какие данные GPU используются

Предустановки взяты из спецификаций самих производителей. Производительность тензорных ядер часто указывают со структурированной разреженностью — это вдвое больше плотного режима; обычный инференс идёт в плотном режиме, поэтому таблица и калькулятор используют значения dense.

GPU Память (ГБ) ПСП (ГБ/с) TFLOPS FP16/BF16 (dense) TFLOPS FP8 (dense)
NVIDIA H100 SXM5 80 3,352 989.4 1,978.9
NVIDIA H100 PCIe 80 2,039 756 1,513
NVIDIA H200 SXM 141 4,800 989.5 1,979
NVIDIA A100 80GB SXM 80 2,039 312 —
NVIDIA A100 80GB PCIe 80 1,935 312 —
NVIDIA L40S 48 864 362.05 733
NVIDIA L4 24 300 121 242.5
AMD Instinct MI300X 192 5,300 1,307.45 2,614.9

Если вашего GPU нет в списке, выберите «Свой GPU» и введите его память, ПСП и TFLOPS (dense).

Что оценка не учитывает

  • Движки инференса различаются: continuous batching, страничный KV-кэш, спекулятивное декодирование и оптимизированные ядра заметно меняют производительность. Измерьте свой стек и введите результат.
  • Разбиение модели на несколько GPU добавляет время на обмен данными, которое оценка не учитывает.
  • Модель mixture-of-experts на каждом токене читает только активных экспертов: для скорости вводите активные параметры, а память проверяйте по общему числу.
  • У моделей разные токенизаторы, поэтому один и тот же текст может давать разное число токенов.
  • Электроэнергия, работа персонала, резерв под пики и исходящий трафик не учтены, если вы не добавите их к почасовой цене.

Чтобы подробнее рассчитать память GPU, воспользуйтесь калькулятором требуемой видеопамяти GPU.

Источники и ссылки

Последнее обновление:

Самые популярные в разделе Отраслевой

Все калькуляторы раздела Отраслевой















