什么是 Token 转字数计算器?
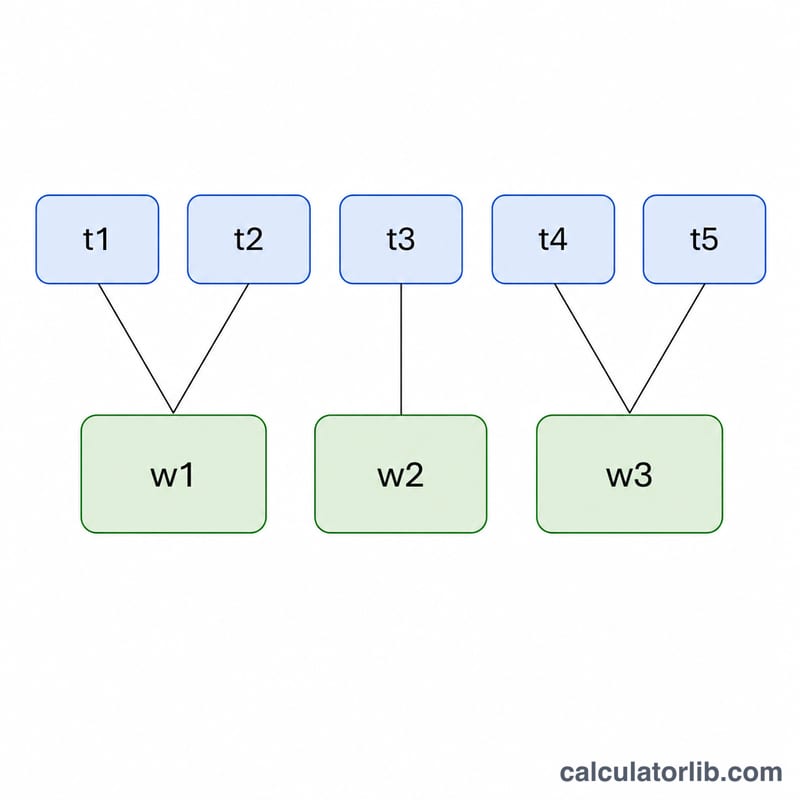
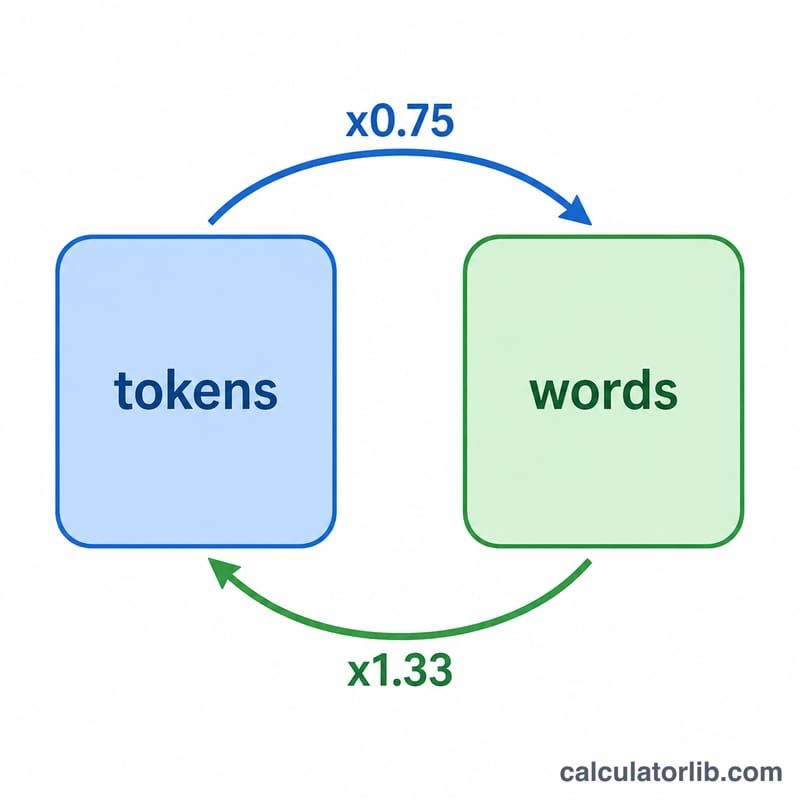
GPT、Claude、Gemini 等大语言模型(LLM)并不是逐字阅读文本,而是把文本拆成一个个 令牌 来处理。一个 Token 可以是一个完整的单词、一个单词的一部分,甚至是一个标点符号。对于常见的英文文本而言,一个 Token 大约对应 0.75 个英文单词(换算下来约为每个单词 1.33 个 Token)。本计算器可以把 Token 数量换算成大致的字数,也可以把字数换算成它大概会消耗多少 Token。需要注意的是,这套比例主要基于英文,中文等其他语言的分词方式不同,实际 Token 用量往往更高。
使用方法
先选择换算方向——Token 转字数 或 字数转 Token,输入数量,并可按需调整 每 Token 词数 比例(默认 0.75)。工具会立即给出换算结果以及所使用的比例。如果处理的是代码或非英文文本(通常会占用更多 Token),可以把比例调低;如果是简单、重复的英文内容,则可适当调高。
公式解析
换算本质上就是一个简单的比例关系。由 Token 估算字数:
$$\text{字数} = \text{Token 数} \times \text{比例}$$由字数估算 Token:
$$\text{Token 数} = \frac{\text{字数}}{\text{比例}}$$以默认比例 0.75 计算,1,000 个 Token ≈ 750 个词,1,000 个词 ≈ 1,333 个 Token。这些都只是估算值——真实的分词结果会因模型、语言和内容而异。
实例演示
假设某次 API 调用显示用掉了 1,000 个 Token。按默认比例计算:
$$1000 \times 0.75 = 750 \text{ 词}$$反过来,如果你写了一篇 1,500 词的文章,想知道它大概要消耗多少 Token:
$$1500 \div 0.75 = 2{,}000 \text{ 个 Token}$$——这对于控制在模型上下文窗口范围内、或者预估 API 费用都很有帮助。
常见的词元与单词换算
下表采用常用的经验法则:每个词元约对应 0.75 个单词(大约相当于 4 个英文字符为一个词元),因此 \(\text{单词数} = \text{词元数} \times 0.75\)。页数按每页约 500 个单词(单倍行距)计算。所有数值均为估算值;实际数量取决于分词器、语言和内容。
| 词元数 | 约合单词数(×0.75) | 约合页数(每页约 500 词) |
|---|---|---|
| 100 | 75 | 0.15 |
| 500 | 375 | 0.75 |
| 1,000 | 750 | 1.5 |
| 4,000 | 3,000 | 6 |
| 8,000 | 6,000 | 12 |
| 32,000 | 24,000 | 48 |
| 128,000 | 96,000 | 192 |
| 200,000 | 150,000 | 300 |
反过来换算,用单词数除以该比率:\(\text{词元数} = \text{单词数} \div 0.75\)。例如,1,500 个单词 ≈ \(1500 \div 0.75 = 2000\) 个词元。
按内容类型划分的每词元单词数
不同类型的文本拆分为词元的方式各不相同。以下比率只是粗略的经验值,会因分词器和模型而异,因此应将结果视为估算值;如需精确结果,请使用服务提供商的官方分词器。
| 内容类型 | 典型的每词元单词数(约) | 1,000 个词元对应的单词数(约) |
|---|---|---|
| 普通英文散文 | ~0.75 | ~750 |
| 技术或法律英文 | ~0.65–0.70 | ~650–700 |
| 源代码 | ~0.5–0.6 | ~500–600 |
| 非英文或非拉丁文字 | ~0.3–0.5 | ~300–500 |
| 数字和特殊字符较多的文本 | 通常低于 ~0.5(差异很大) | 通常低于 ~500 |
为什么会有这些差异?常见的英文单词通常只是一个词元,而生僻词、较长的技术术语、符号、数字以及许多非拉丁字符则会被拆分为若干较小的片段。代码还包含空白、标点和符号,这会降低每个词元对应的单词数。在计算器中,请将比率字段修改为与您的内容类型相符的数值。
关键术语:词元、上下文窗口与分词器
- 词元(Token)
- 语言模型读取和生成的基本文本单位。一个词元可以是一个完整单词、单词的一部分、一个标点符号,或者一个空格加一个单词的组合。
- 分词器(Tokenizer)
- 将文本转换为词元序列(以及反向转换)的组件。每个模型系列都使用自己的分词器和词表,因此同一段文本可能产生不同的词元数量。
- 字节对编码(BPE)
- 一种常见的分词方法,从较小的单位(如字节或字符)开始,反复将最常见的相邻字符对合并为更大的词元,从而构建词表:常见单词为单个词元,生僻词则被拆分为多个片段。
- 上下文窗口
- 模型在一次请求中能够处理的最大词元数,通常包括提示词、对话历史以及生成的回复。
- 输入词元与输出词元
- 输入词元是您发送给模型的内容(提示词、文档、历史记录);输出词元是模型生成的内容。服务提供商通常分别计数,并可能对两者采用不同的计费和限制标准。
- 每词元单词数比率
- 一个词元平均代表的单词数。对于英文散文,约 0.75 是常用的经验法则(大约 1 个词元 ≈ 4 个字符),但这只是近似值,会随语言和内容类型而变化。
常见问题
每 Token 0.75 词这个比例总是准确吗? 不一定——它是针对英文的常用经验法则。代码、数字以及其他语言往往每个词要占用更多 Token,因此遇到这些情况建议把比例调低。
为什么 Token 这么重要? 大模型的计费和上下文长度限制都是按 Token(而不是字数)来计算的,因此换算有助于你预估成本和判断内容是否放得下。
怎样才能得到精确数值? 请使用模型官方的分词器(例如 OpenAI 的 tiktoken)。本计算器提供的是快速近似值,并非精确计数。