Công cụ đổi Token sang Từ là gì?
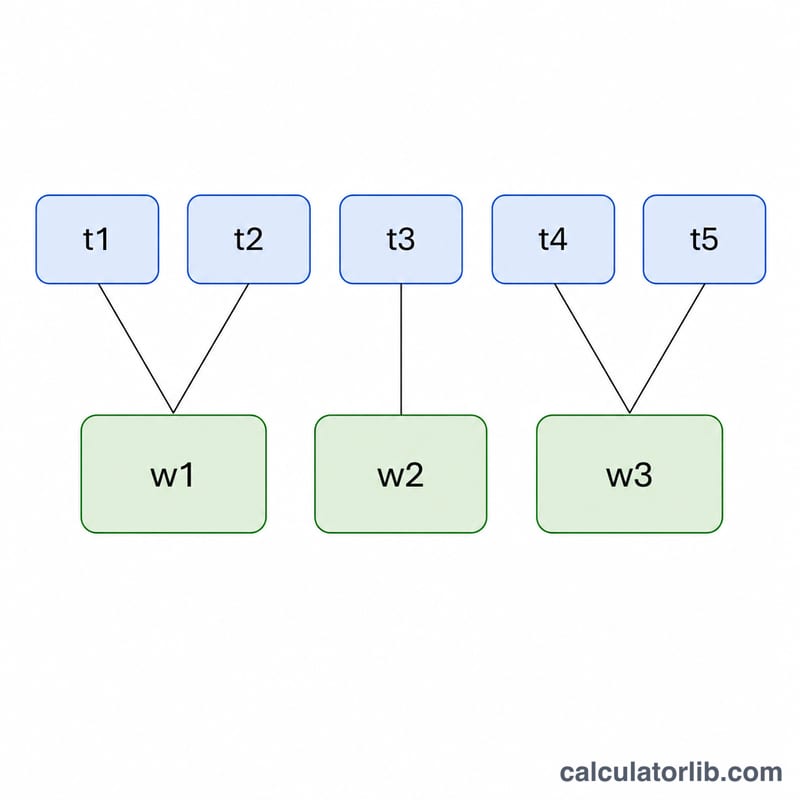
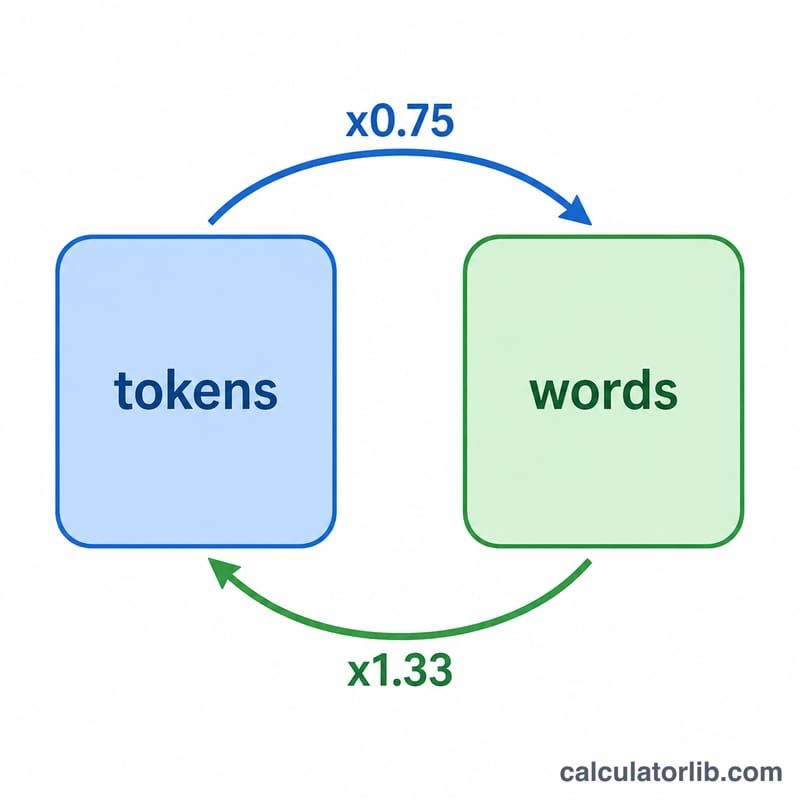
Các mô hình ngôn ngữ lớn (LLM) như GPT, Claude hay Gemini không đọc văn bản theo từng từ — chúng xử lý văn bản dưới dạng token. Một token là một mẩu văn bản, có thể là cả một từ, một phần của từ, hoặc thậm chí là dấu câu. Với văn xuôi tiếng Anh thông thường, một token tương ứng với khoảng 0,75 từ (tức là khoảng 1,33 token cho mỗi từ). Công cụ này giúp bạn đổi số token sang số từ ước tính, hoặc đổi số từ sang lượng token mà nó có thể tiêu tốn. Lưu ý rằng tỷ lệ này dựa trên tiếng Anh; với tiếng Việt, văn bản thường ngốn nhiều token hơn nên bạn nên hạ tỷ lệ xuống.
Cách sử dụng
Hãy chọn chiều chuyển đổi — Token sang Từ hoặc Từ sang Token — nhập con số của bạn, và nếu muốn thì điều chỉnh tỷ lệ từ trên mỗi token (mặc định là 0,75). Công cụ sẽ hiển thị ngay kết quả đã chuyển đổi cùng với tỷ lệ đã dùng. Hãy giảm tỷ lệ khi xử lý mã nguồn hoặc văn bản không phải tiếng Anh (vì những nội dung này thường tốn nhiều token hơn), và tăng tỷ lệ với những đoạn tiếng Anh đơn giản, lặp lại nhiều.
Giải thích công thức
Phép chuyển đổi chỉ là một tỷ lệ đơn giản. Để ước tính số từ từ token: $$\text{số từ} = \text{số token} \times \text{tỷ lệ}$$. Để ước tính số token từ số từ: $$\text{số token} = \frac{\text{số từ}}{\text{tỷ lệ}}$$. Với tỷ lệ mặc định 0,75, thì 1.000 token ≈ 750 từ, và 1.000 từ ≈ 1.333 token. Đây chỉ là ước tính: việc tách token thực tế còn phụ thuộc vào mô hình, ngôn ngữ và nội dung cụ thể.
Ví dụ minh họa
Giả sử một lệnh gọi API báo rằng nó đã dùng 1.000 token. Với tỷ lệ mặc định: $$1000 \times 0{,}75 = 750 \text{ từ}$$. Ngược lại, nếu bạn viết một bài luận 1.500 từ và muốn biết nó tốn bao nhiêu token: $$1500 \div 0{,}75 = 2000 \text{ token}$$ — rất hữu ích khi bạn cần nằm trong giới hạn cửa sổ ngữ cảnh của mô hình hoặc dự trù chi phí dùng API.
Chuyển đổi phổ biến giữa Token và Từ
Bảng dưới đây dùng quy tắc ước lượng thông thường là khoảng 0,75 từ trên mỗi token (tương đương khoảng 4 ký tự tiếng Anh cho mỗi token), vì vậy \(\text{Từ} = \text{Token} \times 0.75\). Các trang được tính giả định khoảng 500 từ trên mỗi trang đơn cách dòng. Tất cả các giá trị đều là ước lượng; số lượng thực tế phụ thuộc vào bộ tokenizer, ngôn ngữ và nội dung.
| Token | Số từ ước chừng (×0.75) | Số trang ước chừng (~500 từ/trang) |
|---|---|---|
| 100 | 75 | 0.15 |
| 500 | 375 | 0.75 |
| 1,000 | 750 | 1.5 |
| 4,000 | 3,000 | 6 |
| 8,000 | 6,000 | 12 |
| 32,000 | 24,000 | 48 |
| 128,000 | 96,000 | 192 |
| 200,000 | 150,000 | 300 |
Để chuyển theo chiều ngược lại, chia số từ cho tỷ lệ: \(\text{Token} = \text{Từ} \div 0.75\). Ví dụ, 1.500 từ ≈ \(1500 \div 0.75 = 2000\) token.
Số từ trên mỗi token theo loại nội dung
Các loại văn bản khác nhau được tách thành token theo cách khác nhau. Các tỷ lệ dưới đây chỉ là quy tắc ước lượng thô và thay đổi theo bộ tokenizer và mô hình, vì vậy hãy coi kết quả là ước tính và dùng bộ tokenizer chính thức của nhà cung cấp khi cần độ chính xác cao.
| Loại nội dung | Số từ trên mỗi token thông thường (ước chừng) | Số từ trong 1.000 token (ước chừng) |
|---|---|---|
| Văn xuôi tiếng Anh thông thường | ~0.75 | ~750 |
| Tiếng Anh kỹ thuật hoặc pháp lý | ~0.65–0.70 | ~650–700 |
| Mã nguồn | ~0.5–0.6 | ~500–600 |
| Ngôn ngữ khác tiếng Anh hoặc chữ viết không phải Latinh | ~0.3–0.5 | ~300–500 |
| Văn bản nhiều số và ký tự đặc biệt | Thường dưới ~0.5 (biến động cao) | Thường dưới ~500 |
Vì sao lại có khác biệt? Các từ tiếng Anh phổ biến thường là một token duy nhất, trong khi các từ hiếm, thuật ngữ kỹ thuật dài, ký hiệu, chữ số và nhiều ký tự không phải Latinh bị tách thành nhiều phần nhỏ hơn. Mã nguồn cũng đếm khoảng trắng, dấu câu và ký hiệu, điều này làm giảm số từ trên mỗi token. Trong máy tính, hãy thay đổi ô tỷ lệ để phù hợp với loại nội dung của bạn.
Thuật ngữ chính: Token, Cửa sổ ngữ cảnh và Tokenizer
- Token
- Đơn vị văn bản cơ bản mà mô hình ngôn ngữ đọc và tạo ra. Một token có thể là một từ nguyên vẹn, một phần của từ, một dấu câu hoặc một đoạn gồm khoảng trắng kèm từ.
- Tokenizer
- Thành phần chuyển văn bản thành chuỗi token (và ngược lại). Mỗi họ mô hình sử dụng bộ tokenizer và từ vựng riêng, vì vậy cùng một văn bản có thể tạo ra số lượng token khác nhau.
- Mã hóa cặp byte (BPE)
- Phương pháp token hóa phổ biến, bắt đầu từ các đơn vị nhỏ (như byte hoặc ký tự) và lặp lại việc gộp các cặp liền kề xuất hiện thường xuyên nhất thành token lớn hơn, xây dựng một từ vựng trong đó các từ phổ biến là token đơn và các từ hiếm bị tách thành nhiều mảnh.
- Cửa sổ ngữ cảnh
- Số token tối đa mà một mô hình có thể xử lý trong một yêu cầu, thường bao gồm cả lời nhắc, lịch sử hội thoại và phần phản hồi được tạo ra.
- Token đầu vào và đầu ra
- Token đầu vào là những token bạn gửi tới mô hình (lời nhắc, tài liệu, lịch sử); token đầu ra là những token mô hình tạo ra. Các nhà cung cấp thường đếm riêng hai loại này và có thể tính phí và giới hạn chúng khác nhau.
- Tỷ lệ từ trên mỗi token
- Số từ trung bình được biểu diễn bởi một token. Khoảng 0,75 là quy tắc ước lượng phổ biến cho văn xuôi tiếng Anh (khoảng 1 token ≈ 4 ký tự), nhưng đây chỉ là một xấp xỉ và thay đổi theo ngôn ngữ và loại nội dung.
Câu hỏi thường gặp
Tỷ lệ 0,75 từ mỗi token có luôn chính xác không? Không — đây chỉ là quy tắc ước lượng phổ biến cho tiếng Anh. Mã nguồn, con số và các ngôn ngữ khác (bao gồm tiếng Việt) thường tốn nhiều token hơn cho mỗi từ, nên hãy dùng tỷ lệ thấp hơn cho những trường hợp đó.
Vì sao token lại quan trọng? Giá dịch vụ và giới hạn ngữ cảnh của LLM đều được tính theo token chứ không phải theo từ, nên việc quy đổi giúp bạn ước tính chi phí và dung lượng phù hợp.
Làm sao để có con số chính xác? Hãy dùng công cụ tách token chính thức của mô hình (ví dụ tiktoken của OpenAI). Công cụ này chỉ đưa ra kết quả ước lượng nhanh, không phải con số chính xác tuyệt đối.