Token-Kelime Çevirici nedir?
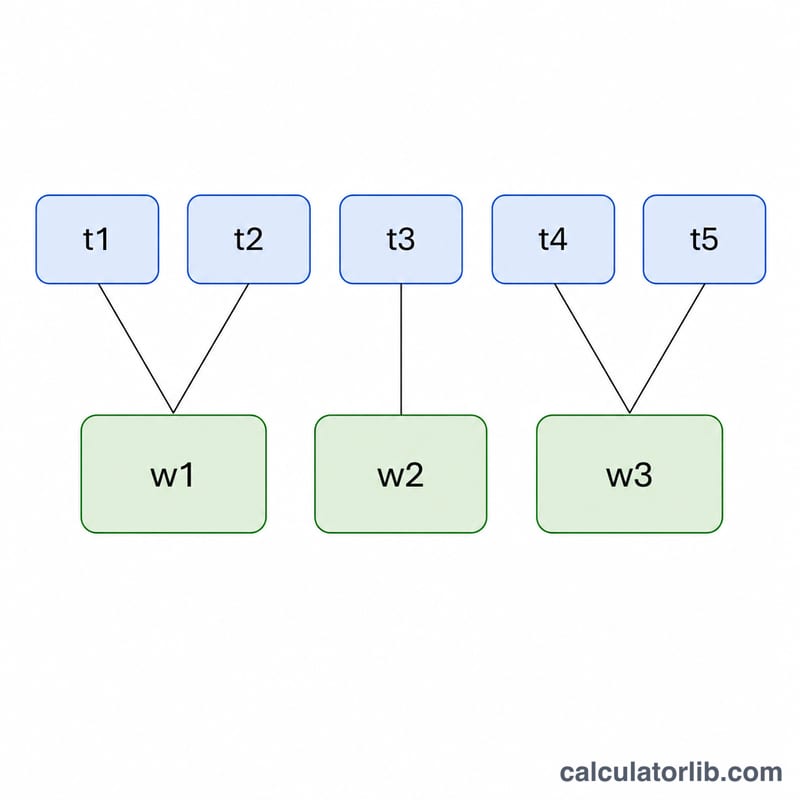
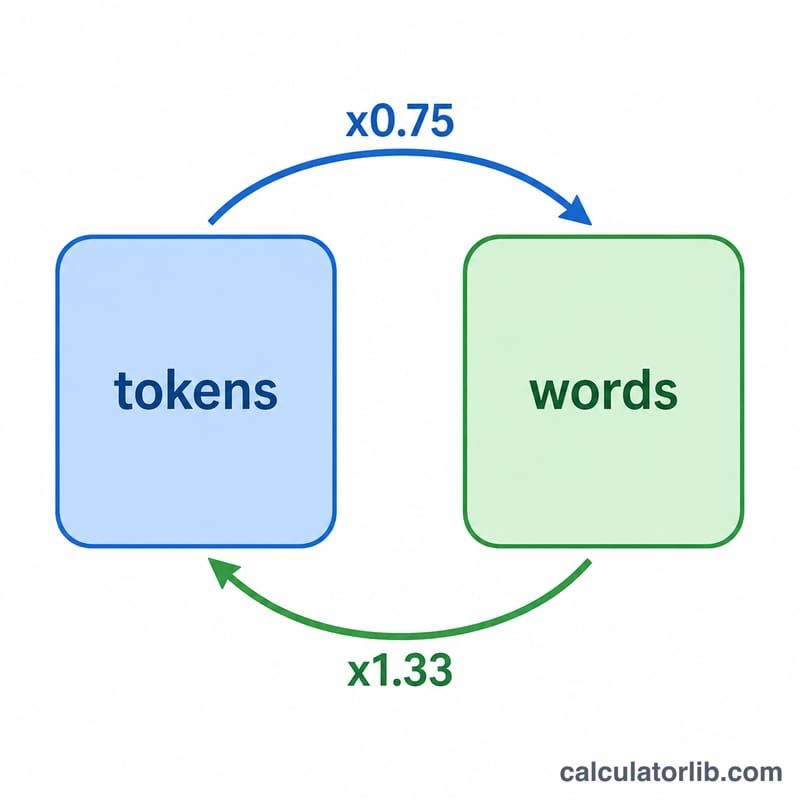
GPT, Claude ve Gemini gibi büyük dil modelleri (LLM'ler) metni kelime kelime okumaz — onu token'lar hâlinde işler. Token, bir metnin bütün bir kelime, kelimenin bir parçası ya da noktalama işareti olabilen küçük bir parçasıdır. Tipik İngilizce metinlerde bir token yaklaşık 0,75 kelimeye karşılık gelir (yani kelime başına yaklaşık 1,33 token). Bu araç, bir token sayısını tahmini kelime sayısına ya da kelime sayısını harcayacağı tahmini token miktarına çevirir.
Nasıl Kullanılır?
Önce bir yön seçin — Token'dan Kelimeye veya Kelimeden Token'a — değerinizi girin ve isterseniz token başına kelime oranını (varsayılan 0,75) ayarlayın. Araç, çevrilen değeri ve kullanılan oranı anında gösterir. Genellikle daha fazla token kullanan kod veya İngilizce dışı metinler için oranı düşürün; basit ve tekrarlı İngilizce metinler için ise yükseltin.
Formül Açıklaması
Çevrim basit bir orantıdır. Token'dan kelime tahmini için: $$\text{kelime} = \text{token} \times \text{oran}$$ Kelimeden token tahmini için: $$\text{token} = \frac{\text{kelime}}{\text{oran}}$$ Varsayılan 0,75 oranıyla 1.000 token ≈ 750 kelime, 1.000 kelime ise ≈ 1.333 token eder. Bunlar tahmini değerlerdir: gerçek tokenleştirme modele, dile ve içeriğe göre değişir.
Örnek Hesaplama
Diyelim ki bir API çağrısı 1.000 token kullandığını bildiriyor. Varsayılan oranla: $$1000 \times 0{,}75 = 750 \text{ kelime}$$ Bunun yerine 1.500 kelimelik bir yazı yazdıysanız ve token maliyetini merak ediyorsanız: $$1500 \div 0{,}75 = 2000 \text{ token}$$ — bu, bir modelin bağlam penceresi (context window) içinde kalmak veya API harcamanızı bütçelemek için oldukça işe yarar.
Yaygın Belirteç-Kelime Dönüşümleri
Aşağıdaki tablo, belirteç başına yaklaşık 0,75 kelime (yaklaşık her belirteç için 4 İngilizce karakter) yaygın pratik kuralını kullanır; buna göre \(\text{Kelimeler} = \text{Belirteçler} \times 0{,}75\). Sayfalar, tek aralıklı sayfa başına yaklaşık 500 kelime varsayılarak hesaplanır. Tüm değerler tahminidir; gerçek sayılar belirteçleyiciye, dile ve içeriğe bağlı olarak değişir.
| Belirteçler | Yaklaşık kelime (×0,75) | Yaklaşık sayfa (sayfa başına ~500 kelime) |
|---|---|---|
| 100 | 75 | 0,15 |
| 500 | 375 | 0,75 |
| 1,000 | 750 | 1,5 |
| 4,000 | 3,000 | 6 |
| 8,000 | 6,000 | 12 |
| 32,000 | 24,000 | 48 |
| 128,000 | 96,000 | 192 |
| 200,000 | 150,000 | 300 |
Tersi yönde hesaplamak için kelime sayısını orana bölün: \(\text{Belirteçler} = \text{Kelimeler} \div 0{,}75\). Örneğin, 1.500 kelime ≈ \(1500 \div 0.75 = 2000\) belirteçtir.
İçerik Türüne Göre Belirteç Başına Kelime
Farklı metin türleri belirteçlere farklı şekilde ayrılır. Aşağıdaki oranlar kaba pratik kurallardır ve belirteçleyiciye ve modele göre değişir; bu nedenle sonuçları tahmin olarak değerlendirin ve kesinlik önemli olduğunda sağlayıcınızın resmi belirteçleyicisini kullanın.
| İçerik türü | Tipik belirteç başına kelime (yaklaşık) | 1.000 belirteçteki kelime (yaklaşık) |
|---|---|---|
| Düz İngilizce metin | ~0,75 | ~750 |
| Teknik veya hukuki İngilizce | ~0,65–0,70 | ~650–700 |
| Kaynak kodu | ~0,5–0,6 | ~500–600 |
| İngilizce olmayan veya Latin olmayan alfabeler | ~0,3–0,5 | ~300–500 |
| Sayı ve özel karakter yoğun metin | Genellikle ~0,5’in altında (büyük değişkenlik) | Genellikle ~500’ün altında |
Farklar neden var? Yaygın İngilizce kelimeler çoğu zaman tek bir belirteçtir; oysa nadir kelimeler, uzun teknik terimler, semboller, rakamlar ve birçok Latin olmayan karakter birkaç daha küçük parçaya bölünür. Kod ayrıca boşlukları, noktalama işaretlerini ve sembolleri de sayar; bu da belirteç başına kelime sayısını azaltır. Hesaplayıcıda, içerik türünüze uyması için oran alanını değiştirin.
Temel Terimler: Belirteçler, Bağlam Penceresi ve Belirteçleyici
- Belirteç
- Bir dil modelinin okuduğu ve yazdığı temel metin birimi. Bir belirteç tam bir kelime, bir kelimenin parçası, bir noktalama işareti veya boşluk artı kelimeden oluşan bir parça olabilir.
- Belirteçleyici
- Metni bir belirteç dizisine (ve tersine) dönüştüren bileşen. Her model ailesi kendi belirteçleyicisini ve kelime dağarcığını kullandığından, aynı metin farklı belirteç sayıları üretebilir.
- Bayt çifti kodlaması (BPE)
- Küçük birimlerden (bayt veya karakter gibi) başlayan ve en sık görülen bitişik çiftleri tekrar tekrar birleştirerek daha büyük belirteçler oluşturan yaygın bir belirteçleme yöntemi. Bu yöntem, yaygın kelimelerin tek belirteç olduğu, nadir kelimelerin ise parçalara bölündüğü bir kelime dağarcığı oluşturur.
- Bağlam penceresi
- Bir modelin tek bir istekte işleyebildiği en fazla belirteç sayısı; genellikle istem, varsa konuşma geçmişi ve üretilen yanıtın birlikte toplamını kapsar.
- Girdi ve çıktı belirteçleri
- Girdi belirteçleri modele gönderdiğiniz belirteçlerdir (istem, belgeler, geçmiş); çıktı belirteçleri ise modelin ürettiği belirteçlerdir. Sağlayıcılar bunları genellikle ayrı sayar ve farklı fiyatlandırabilir veya sınırlayabilir.
- Belirteç başına kelime oranı
- Bir belirteçle temsil edilen ortalama kelime sayısı. İngilizce düz metin için yaklaşık 0,75 yaygın bir pratik kuraldır (yaklaşık 1 belirteç ≈ 4 karakter), ancak bu dile ve içerik türüne göre değişen bir yaklaşımdır.
Sıkça Sorulan Sorular
Token başına 0,75 kelime her zaman doğru mu? Hayır — bu, İngilizce için yaygın olarak kullanılan bir pratik kuraldır. Kod, sayılar ve diğer diller çoğu zaman kelime başına daha fazla token harcadığından, bunlarda daha düşük bir oran kullanın.
Token'lar neden önemli? LLM fiyatlandırması ve bağlam sınırları kelimeyle değil token'la ölçülür; bu yüzden çevrim yapmak maliyeti ve sığma durumunu tahmin etmenize yardımcı olur.
Kesin sayıyı nasıl bulurum? Modelin resmi tokenleştiricisini kullanın (örneğin OpenAI için tiktoken). Bu araç hızlı bir yaklaşım sunar, kesin bir sayı değil.