Что такое калькулятор перевода токенов в слова?
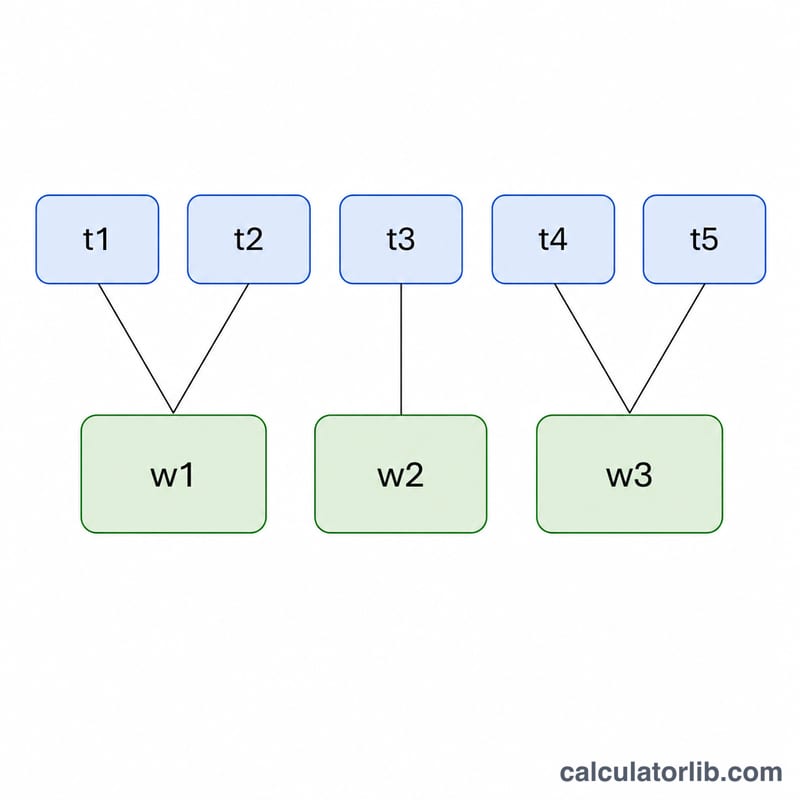
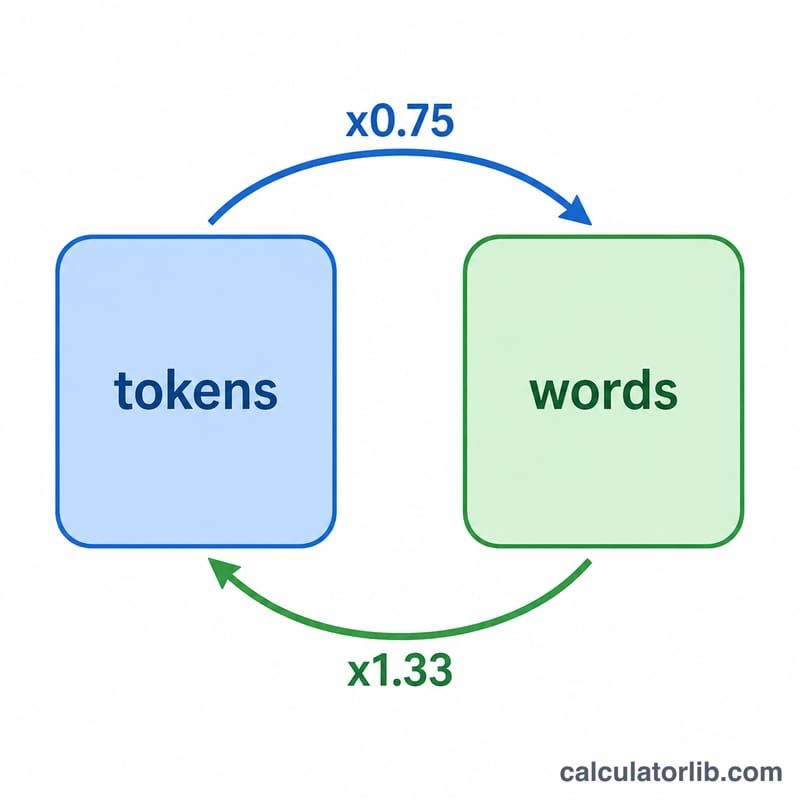
Большие языковые модели (LLM) — такие как GPT, Claude и Gemini — читают текст не по словам, а разбивают его на токены. Токен — это фрагмент текста: им может быть целое слово, часть слова или даже знак препинания. Для обычного текста на английском один токен соответствует примерно 0,75 слова (то есть около 1,33 токена на одно слово). Этот калькулятор переводит число токенов в приблизительное количество слов — или наоборот, показывает, сколько токенов «съест» заданное число слов. Учтите: для русского текста токенов на слово обычно требуется больше, чем для английского, поэтому коэффициент стоит снизить.
Как пользоваться
Выберите направление перевода — из токенов в слова или из слов в токены, — введите нужное значение и при желании измените коэффициент слов на токен (по умолчанию 0,75). Калькулятор сразу покажет результат и использованный коэффициент. Снижайте его для кода или текста не на английском (там токенов уходит больше), а повышайте — для простого, повторяющегося английского текста.
Разбор формулы
Перевод строится на простой пропорции. Чтобы оценить количество слов по токенам:
$$\text{слова} = \text{токены} \times \text{коэффициент}$$Чтобы оценить токены по словам:
$$\text{токены} = \frac{\text{слова}}{\text{коэффициент}}$$При коэффициенте 0,75 по умолчанию 1000 токенов ≈ 750 слов, а 1000 слов ≈ 1333 токена. Это лишь оценка: реальная токенизация зависит от модели, языка и содержания текста.
Пример расчёта
Допустим, после запроса к API вы видите, что было израсходовано 1000 токенов. По коэффициенту по умолчанию:
$$1000 \times 0{,}75 = 750 \text{ слов}$$А если вы написали эссе на 1500 слов и хотите узнать, во сколько токенов оно обойдётся:
$$1500 \div 0{,}75 = 2000 \text{ токенов}$$Это удобно, чтобы не выйти за пределы контекстного окна модели и спланировать расходы на API.
Частые вопросы
Всегда ли точны 0,75 слова на токен? Нет — это распространённое эмпирическое правило для английского языка. Код, числа и другие языки (в том числе русский) часто требуют больше токенов на слово, поэтому для них лучше брать меньший коэффициент.
Почему токены так важны? Стоимость использования LLM и лимиты контекста измеряются в токенах, а не в словах, поэтому перевод помогает прикинуть и затраты, и объём.
Как получить точное число? Воспользуйтесь официальным токенизатором модели (например, tiktoken для OpenAI). Этот калькулятор даёт быструю приблизительную оценку, а не точный подсчёт.
Общие пересчёты токенов в слова
В таблице используется распространённое эмпирическое правило: примерно 0,75 слова на токен (около 4 символов английского текста на токен), поэтому \(\text{Слова} = \text{Токены} \times 0.75\). Страницы рассчитаны примерно на 500 слов на одну страницу с одинарным интервалом. Все значения являются оценочными; фактическое количество зависит от токенизатора, языка и содержания.
| Токены | Примерно слов (×0,75) | Примерно страниц (~500 слов/страница) |
|---|---|---|
| 100 | 75 | 0,15 |
| 500 | 375 | 0,75 |
| 1 000 | 750 | 1,5 |
| 4 000 | 3 000 | 6 |
| 8 000 | 6 000 | 12 |
| 32 000 | 24 000 | 48 |
| 128 000 | 96 000 | 192 |
| 200 000 | 150 000 | 300 |
Чтобы пересчитать в обратном направлении, разделите количество слов на коэффициент: \(\text{Токены} = \text{Слова} \div 0.75\). Например, 1 500 слов ≈ \(1500 \div 0.75 = 2000\) токенов.
Слова на токен по типу содержимого
Разные виды текста делятся на токены по-разному. Приведённые ниже коэффициенты являются приблизительными эмпирическими правилами и зависят от токенизатора и модели, поэтому считайте результаты оценочными и используйте официальный токенизатор вашего провайдера, когда важна точность.
| Тип содержимого | Типичное количество слов на токен (примерно) | Слов в 1 000 токенах (примерно) |
|---|---|---|
| Обычная английская проза | ~0,75 | ~750 |
| Технический или юридический английский | ~0,65–0,70 | ~650–700 |
| Исходный код | ~0,5–0,6 | ~500–600 |
| Неанглийские языки или письменности, не использующие латиницу | ~0,3–0,5 | ~300–500 |
| Текст, насыщенный числами и специальными символами | Часто ниже ~0,5 (сильно варьируется) | Часто ниже ~500 |
Почему такие различия? Распространённые английские слова часто представляют собой один токен, а редкие слова, длинные технические термины, символы, цифры и многие символы нелатинских письменностей разбиваются на несколько более мелких частей. Код также учитывает пробелы, знаки препинания и символы, что уменьшает количество слов на токен. В калькуляторе измените поле коэффициента, чтобы соответствовать типу вашего содержимого.
Ключевые термины: токены, контекстное окно и токенизатор
- Токен
- Базовая единица текста, которую языковая модель читает и генерирует. Токеном может быть целое слово, часть слова, знак препинания или фрагмент из пробела и слова.
- Токенизатор
- Компонент, который преобразует текст в последовательность токенов (и обратно). Каждое семейство моделей использует собственный токенизатор и словарь, поэтому один и тот же текст может давать разное количество токенов.
- Кодирование парами байтов (BPE)
- Распространённый метод токенизации, который начинает с мелких единиц (например, байтов или символов) и последовательно объединяет наиболее часто встречающиеся соседние пары в более крупные токены, формируя словарь, в котором частые слова являются одиночными токенами, а редкие слова разбиваются на части.
- Контекстное окно
- Максимальное количество токенов, которое модель может обработать за один запрос; обычно включает в себя вместе запрос, историю диалога и сгенерированный ответ.
- Входные и выходные токены
- Входные токены — это те, которые вы отправляете модели (запрос, документы, история); выходные токены — те, которые генерирует модель. Провайдеры часто считают их отдельно и могут по-разному тарифицировать и ограничивать.
- Коэффициент слов на токен
- Среднее количество слов, которое представляет один токен. Около 0,75 — распространённое эмпирическое правило для английской прозы (примерно 1 токен ≈ 4 символа), но это приближение, которое меняется в зависимости от языка и типа содержимого.