什麼是 Token 字數換算器?
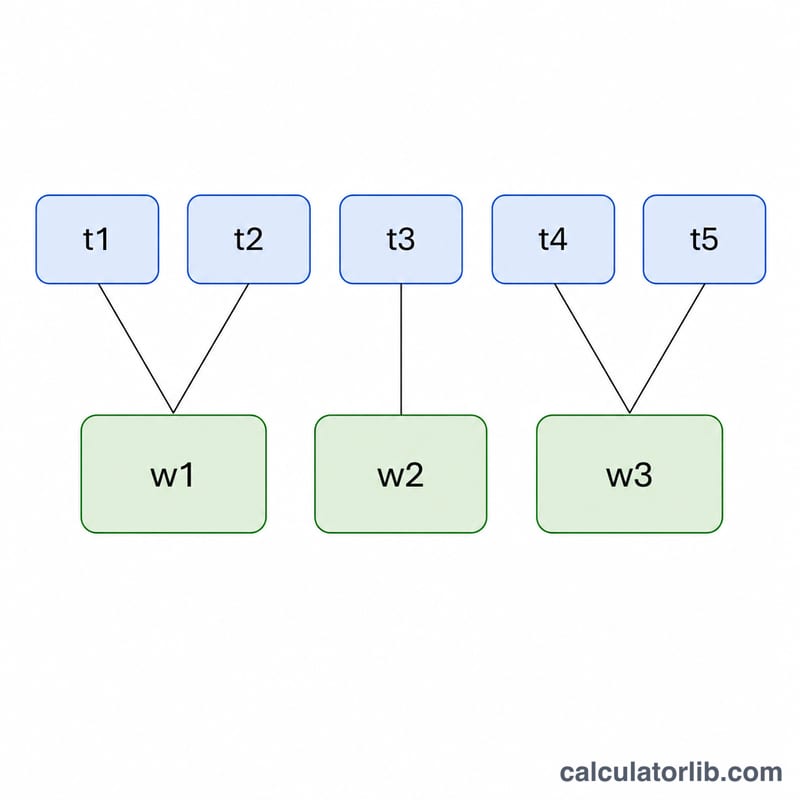
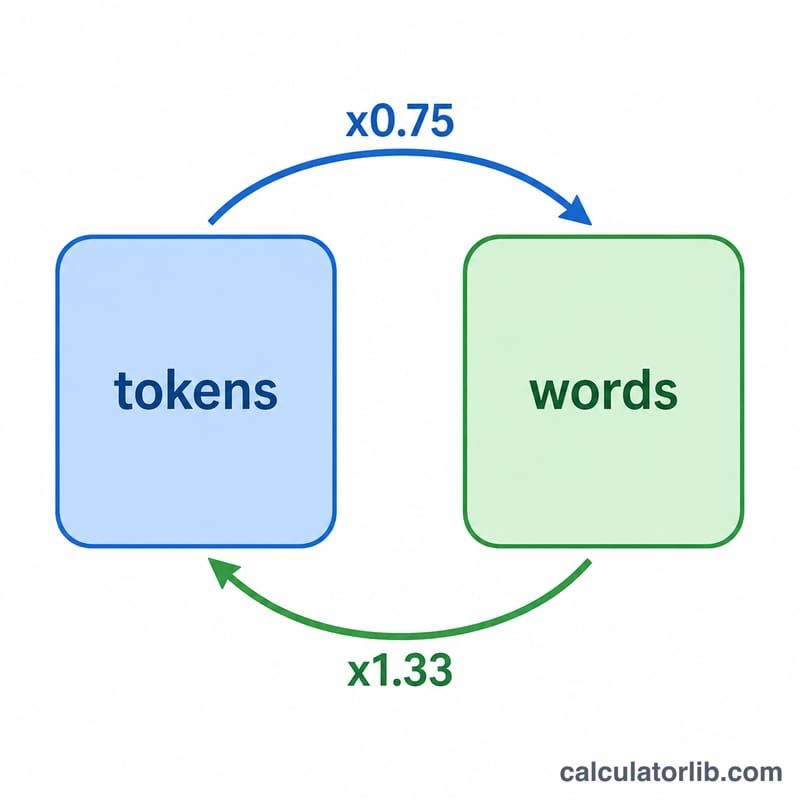
GPT、Claude、Gemini 等大型語言模型(LLM)並非逐字閱讀文字,而是以 Token(詞元)為單位處理。一個 Token 是一段文字片段,可能是一個完整單字、單字的一部分,甚至是標點符號。以一般英文文章來說,1 個 Token 大約對應 0.75 個英文單字(換算過來約為每個單字 1.33 個 Token)。這個換算器能把 Token 數換算成估計的字數,也能把字數換算成可能耗用的 Token 數。要提醒的是,這套比例是以英文為基準;中文的 Token 切分方式不同,實際比例會有所差異。
使用方式
先選擇換算方向──Token 換字數 或 字數換 Token──輸入數量,並可視需要調整 每個 Token 對應的字數比例(預設為 0.75)。工具會立即顯示換算結果以及採用的比例。處理程式碼或非英文內容時(這類文字通常會耗用更多 Token),可把比例調低;若是簡單、重複性高的英文,則可調高。
公式說明
換算其實是單純的比例運算。由 Token 估算字數:$$\text{字數} = \text{Token 數} \times \text{比例}$$由字數估算 Token:$$\text{Token 數} = \frac{\text{字數}}{\text{比例}}$$以預設比例 0.75 計算,1,000 個 Token ≈ 750 字,而 1,000 字 ≈ 1,333 個 Token。這些都是估計值──實際的 Token 切分會因模型、語言與內容而不同。
實際範例
假設某次 API 呼叫顯示用掉了 1,000 個 Token,套用預設比例:$$1000 \times 0.75 = 750 \text{ 字}$$反過來,如果你寫了一篇 1,500 字的英文文章,想知道它大約會耗用多少 Token:$$1500 \div 0.75 = 2{,}000 \text{ 個 Token}$$──這對於控制模型的脈絡視窗(context window)上限、或抓 API 費用預算都很有幫助。
常見的詞元與字詞換算
下表採用常見的經驗法則,即每個詞元約等於 0.75 個字詞(大約 4 個英文字元為一個詞元),因此 \(\text{字詞數} = \text{詞元數} \times 0.75\)。頁數以每頁單行間距約 500 個字詞計算。所有數值均為估計值;實際計數取決於分詞器、語言和內容。
| 詞元數 | 約略字詞數(×0.75) | 約略頁數(每頁約 500 字詞) |
|---|---|---|
| 100 | 75 | 0.15 |
| 500 | 375 | 0.75 |
| 1,000 | 750 | 1.5 |
| 4,000 | 3,000 | 6 |
| 8,000 | 6,000 | 12 |
| 32,000 | 24,000 | 48 |
| 128,000 | 96,000 | 192 |
| 200,000 | 150,000 | 300 |
反過來換算,請將字詞數除以比率:\(\text{詞元數} = \text{字詞數} \div 0.75\)。例如,1,500 個字詞 ≈ \(1500 \div 0.75 = 2000\) 個詞元。
依內容類型劃分的每詞元字詞數
不同類型的文字被切分成詞元的方式各不相同。以下比率僅為粗略的經驗值,會因分詞器和模型而異,因此請將結果視為估計值,並在需要精確數字時使用服務供應商提供的官方分詞器。
| 內容類型 | 每詞元典型字詞數(約略) | 1,000 個詞元中的字詞數(約略) |
|---|---|---|
| 一般英文散文 | ~0.75 | ~750 |
| 技術或法律英文 | ~0.65–0.70 | ~650–700 |
| 原始程式碼 | ~0.5–0.6 | ~500–600 |
| 非英文或非拉丁文字 | ~0.3–0.5 | ~300–500 |
| 大量數字與特殊字元的文字 | 通常低於 ~0.5(變化很大) | 通常低於 ~500 |
為什麼會有這些差異?常見的英文單字通常是單一詞元,而罕見字、較長的技術用語、符號、數字以及許多非拉丁字元則會被切分成數個較小的片段。程式碼還包含空白、標點和符號,這也會降低每詞元的字詞數。在計算機中,請將比率欄位調整為符合您的內容類型。
關鍵術語:詞元、上下文視窗與分詞器
- 詞元(Token)
- 語言模型讀取和生成文字的基本單位。一個詞元可以是完整的單字、單字的一部分、一個標點符號,或是一個空格加單字的組合。
- 分詞器(Tokenizer)
- 將文字轉換為詞元序列(反之亦然)的元件。每個模型系列都使用自己的分詞器和詞彙表,因此相同的文字可能產生不同的詞元數。
- 位元組對編碼(BPE)
- 一種常見的分詞方法,從較小的單位(例如位元組或字元)開始,反覆將最常出現的相鄰配對合併為較大的詞元,建構出一個詞彙表,其中常見字詞為單一詞元,罕見字詞則被切分成數個片段。
- 上下文視窗(Context window)
- 模型在一次請求中能夠處理的詞元數上限,通常同時涵蓋提示、任何對話歷史以及生成的回應。
- 輸入與輸出詞元
- 輸入詞元是您傳送給模型的內容(提示、文件、歷史紀錄);輸出詞元是模型生成的內容。服務供應商通常分別計算這兩者,並可能對其定價和限制有所不同。
- 每詞元字詞數比率
- 一個詞元所代表的平均字詞數。約 0.75 是一般英文散文常用的經驗法則(大約 1 個詞元 ≈ 4 個字元),但這只是近似值,會隨語言和內容類型而改變。
常見問題
0.75 字/Token 的比例一定準嗎?不一定──這是針對英文廣為引用的經驗法則。程式碼、數字以及其他語言(包含中文)往往每個字會用掉更多 Token,因此這類內容建議改用較低的比例。
為什麼 Token 這麼重要?LLM 的計費與脈絡長度上限都是以 Token(而非字數)為單位計算,因此做好換算有助於估算成本與內容是否塞得下。
要怎麼取得精確的 Token 數?請使用模型官方的 Tokenizer(例如 OpenAI 的 tiktoken)。本換算器提供的是快速的近似值,並非精確計數。