什麼是 LLM 顯示記憶體需求計算機?
這個工具能幫你估算載入並執行大型語言模型(LLM)進行推論時,所需的 GPU 顯示記憶體(VRAM)有多少。記憶體用量主要取決於模型的參數量,以及儲存每個權重所用的數值精度。此外,還有一個安全(額外開銷)係數,用來涵蓋 KV 快取、啟用值(activations)與 CUDA 環境等,這些都會在純權重之外額外佔用記憶體。
使用方式
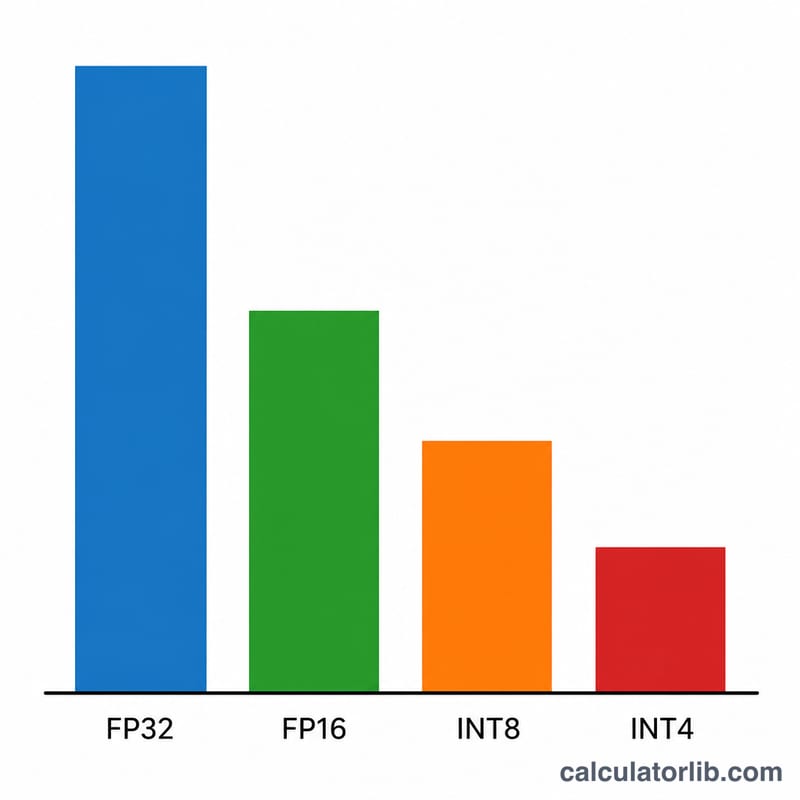
以「十億參數」為單位輸入模型大小(例如 7B 模型輸入 7、Llama-3 70B 輸入 70)。接著選擇精度:FP32 每個權重佔 4 個位元組、FP16/BF16 佔 2 個位元組、INT8 佔 1 個位元組,而 INT4 量化僅佔 0.5 個位元組。最後設定額外開銷係數——對於短上下文的推論,1.2(保留 20% 緩衝)是相當合理的預設值;若是長上下文或需要批次處理,則應調高此數值。
公式解析
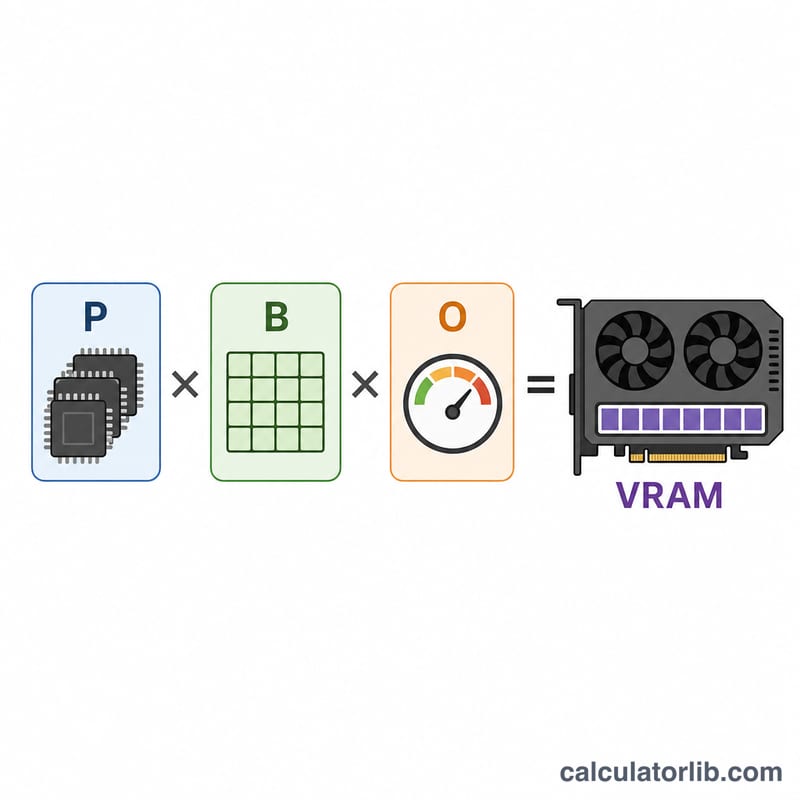
$$\text{VRAM (GB)} = \text{Params (B)} \times \text{Bytes/Param} \times \text{Overhead}$$由於 10 億位元組 ≈ 1 GB,將以「十億」為單位的參數量乘上每個參數的位元組數,便能直接得到 GB 數。再乘上額外開銷係數,就能涵蓋執行階段所需的記憶體。
實際範例
以 7B 模型、採 FP16 精度、額外開銷係數 1.2 為例:$$7 \times 2 \times 1.2 = 16.8 \text{ GB}$$可輕鬆容納於 24 GB 的顯示卡上。同一個模型若改用 INT4:$$7 \times 0.5 \times 1.2 = 4.2 \text{ GB}$$連 8 GB 的 GPU 都能輕鬆執行。
常見模型規模與精度的 VRAM 估算
表格採用計算機的公式,預設額外開銷係數為 1.2:\(\text{VRAM (GB)} = \text{Params (B)} \times \text{Bytes/Param} \times 1.2\)。每個參數的位元組數,FP16 為 2、INT8 為 1、INT4 為 0.5。「適用於」註記將每個結果與單一 GPU 的標稱容量進行比較,而實際可用容量會略低一些。
| 模型規模 | FP16 (GB) | INT8 (GB) | INT4 (GB) |
|---|---|---|---|
| 7B | 16.8 | 8.4 | 4.2 |
| 13B | 31.2 | 15.6 | 7.8 |
| 34B | 81.6 | 40.8 | 20.4 |
| 70B | 168 | 84 | 42 |
| 405B | 972 | 486 | 243 |
各 GPU 等級可容納的估算值
- 7B:FP16 需要 24 GB 的顯示卡(16.8 GB 超過 16 GB)。INT8 可放入 16 GB。INT4 可放入 8 GB。
- 13B:FP16 需要 48 GB。INT8(15.6 GB)剛好能放入 16 GB,因此 24 GB 較為寬裕。INT4(7.8 GB)放入 8 GB 非常勉強,因此實際上建議選擇 16 GB。
- 34B:FP16(81.6 GB)超過單張 80 GB 顯示卡,因此需要多張 GPU。INT8 可放入 48 GB。INT4 可放入 24 GB。
- 70B:FP16(168 GB)至少需要三張 80 GB 的 GPU。INT8(84 GB)超過一張 80 GB 顯示卡,因此需要兩張 GPU,例如 2×48 GB 或 2×80 GB。INT4(42 GB)可放入 48 GB。
- 405B:所有精度都需要多張 GPU。FP16 至少需要十三張 80 GB 顯示卡,INT8 至少七張,INT4 至少四張。
當估算值超過單張顯示卡的記憶體時,模型必須切分到多張 GPU 上(張量並行或管線並行)。此時互連速度與每張 GPU 的額外開銷就很重要,因此除了簡單的除法之外,應預留一些額外餘裕。
各精度格式的每參數位元組數
| 格式 | 每參數位元組數 | 常見用途 |
|---|---|---|
| FP32 | 4 | 訓練基準、研究以及對數值敏感的工作;很少用於提供 LLM 服務 |
| FP16 / BF16 | 2 | 標準的全品質推論,也是已發布檢查點常用的儲存格式 |
| FP8 / INT8 | 1 | 在支援的硬體與軟體上高效提供服務,品質損失很小 |
| INT4 | 0.5 | 為本地推論與消費級 GPU 進行的積極量化,會有一些品質損失 |
關於實際 4 位元格式的說明:實務上的 4 位元方案,例如 GGUF Q4_K_M、GPTQ 與 AWQ,會儲存每組的縮放係數與其他中繼資料。因此每個權重會比 0.5 位元組略多,大約為 0.55 至 0.65 位元組。對於這些格式,可以將額外開銷係數稍微調高,或將 INT4 的結果視為略微低估。
依使用情境的典型額外開銷係數
| 使用情境 | 額外開銷係數 |
|---|---|
| 短上下文、單一使用者 | 約 1.2 |
| 長上下文或中等批次處理 | 約 1.5 至 2.0 |
| 大量批次處理或極長上下文服務 | 2.0 或更高 |
這些是經驗法則,並非固定標準。您的推論引擎、上下文長度與並行數量,決定了實際數值。
解讀您的 VRAM 估算結果
此結果是一個近似、偏向下限的推論估算。它計算模型權重所需的記憶體,並加上一個固定百分比,用於 KV 快取、啟動值、CUDA 上下文以及框架緩衝區。它不是精確的測量,也不涵蓋訓練。訓練還需要儲存梯度與最佳化器狀態,可能需要數倍的記憶體。
KV 快取如何擴展
KV 快取會隨上下文長度、批次大小、層數以及鍵/值投影的隱藏維度呈線性成長:
$$\text{KV cache (bytes)} \approx 2 \times L \times d_{kv} \times T \times B \times b$$
其中 \(L\) 為層數,\(d_{kv}\) 為鍵/值寬度,\(T\) 為以 token 計的上下文長度,\(B\) 為批次大小(並行序列數),\(b\) 為每個快取元素的位元組數。係數 2 代表鍵與值兩者。舉例來說,一個採用標準多頭注意力、具有 32 層、隱藏維度 4096,且在 4096 個 token 下使用 FP16 快取的模型,需要 \(2 \times 32 \times 4096 \times 4096 \times 2 = 2{,}147{,}483{,}648\) 位元組,即每個序列約 2.1 GB。採用分組查詢注意力的模型,其 \(d_{kv}\) 較小,因此快取也小得多。在長上下文或大量並行使用者的情況下,快取可能與權重相當或更大,此時應調高額外開銷係數。
與可用記憶體比較
請將估算值與 GPU 的可用記憶體比較,而非標稱數字。驅動程式、CUDA 上下文與顯示輸出(若該 GPU 同時驅動顯示器)都會佔用一些記憶體,推論引擎通常也會保留其餘部分的一部分。標示為 24 GB 的顯示卡,對模型而言通常可用的容量明顯較少。如果您的估算值與顯示卡容量相差在百分之幾以內,應假設它無法放入。
多張 GPU
使用張量並行時,權重與 KV 快取會分散到各張 GPU 上,因此每張顯示卡大約只承載其所佔的份額。每張 GPU 仍需負擔自己的 CUDA 上下文與緩衝區,而通訊緩衝區又會增加額外用量,因此所有 GPU 的總用量會比單張 GPU 的估算值略高。
混合專家模型
對於混合專家(MoE)模型,請輸入總參數量,而非啟用參數量。每個 token 只會執行部分專家,這可減少運算量,但通常所有專家權重都必須常駐於 VRAM 中,因為路由器可能選擇其中任何一個。
以上僅為規劃用途的一般資訊。請以您自己的軟體與工作負載檢查實際用量。
常見問題
為什麼實際用量會比純權重高?KV 快取會隨上下文長度與批次大小而增加,框架本身也會為啟用值與緩衝區保留記憶體——這正是額外開銷係數所要近似估算的部分。
這有包含訓練所需的記憶體嗎?沒有。訓練因為要儲存最佳化器狀態與梯度,大約需要 3~4 倍的記憶體;本估算僅針對推論(inference)。
我該用多少的額外開銷係數?短提示詞約用 1.2;長上下文或大量批次處理則建議使用 1.5~2.0 以上。