¿Qué es la calculadora de VRAM para un LLM?
Esta herramienta estima cuánta memoria de vídeo de la GPU (VRAM) necesitas para cargar y ejecutar un modelo de lenguaje grande (LLM) durante la inferencia. La cantidad de memoria depende sobre todo del número de parámetros del modelo y de la precisión numérica con la que se almacena cada peso. Un factor de margen (o de seguridad) tiene en cuenta la caché KV, las activaciones y el contexto de CUDA, que consumen memoria más allá del peso bruto del modelo.
Cómo utilizarla
Introduce el tamaño del modelo en miles de millones de parámetros (por ejemplo, 7 para un modelo de 7B o 70 para Llama-3 70B). Elige la precisión: FP32 usa 4 bytes por peso, FP16/BF16 usa 2 bytes, INT8 usa 1 byte y la cuantización INT4 usa 0,5 bytes. Por último, ajusta el factor de margen: 1,2 (un colchón del 20 %) es un valor por defecto razonable para inferencia con contextos cortos; auméntalo si trabajas con contextos largos o por lotes (batching).
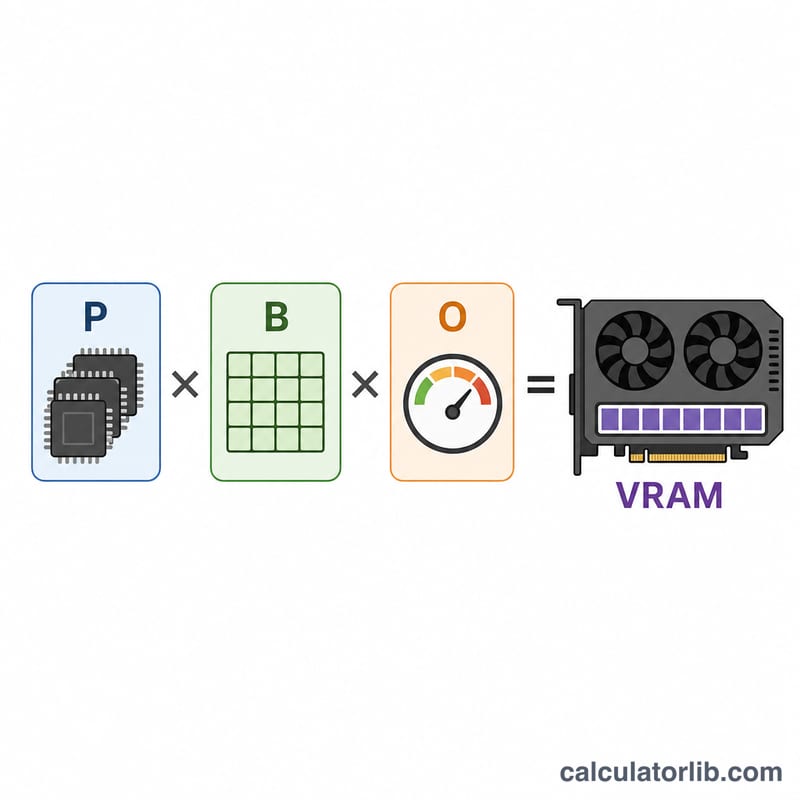
La fórmula explicada
$$\text{VRAM (GB)} = \text{Par\'ametros (miles de millones)} \times \text{Bytes por par\'ametro} \times \text{Margen}$$ Como 1000 millones de bytes ≈ 1 GB, multiplicar los parámetros en miles de millones por los bytes por parámetro da directamente el resultado en gigabytes. El factor de margen amplía después esa cifra para cubrir la memoria de ejecución.
Ejemplo práctico
Para un modelo de 7B en FP16 con un factor de margen de 1,2: $$7 \times 2 \times 1{,}2 = 16{,}8 \text{ GB}$$ Cabe sin problemas en una tarjeta de 24 GB. El mismo modelo en INT4: $$7 \times 0{,}5 \times 1{,}2 = 4{,}2 \text{ GB}$$ y se ejecuta fácilmente en una GPU de 8 GB.
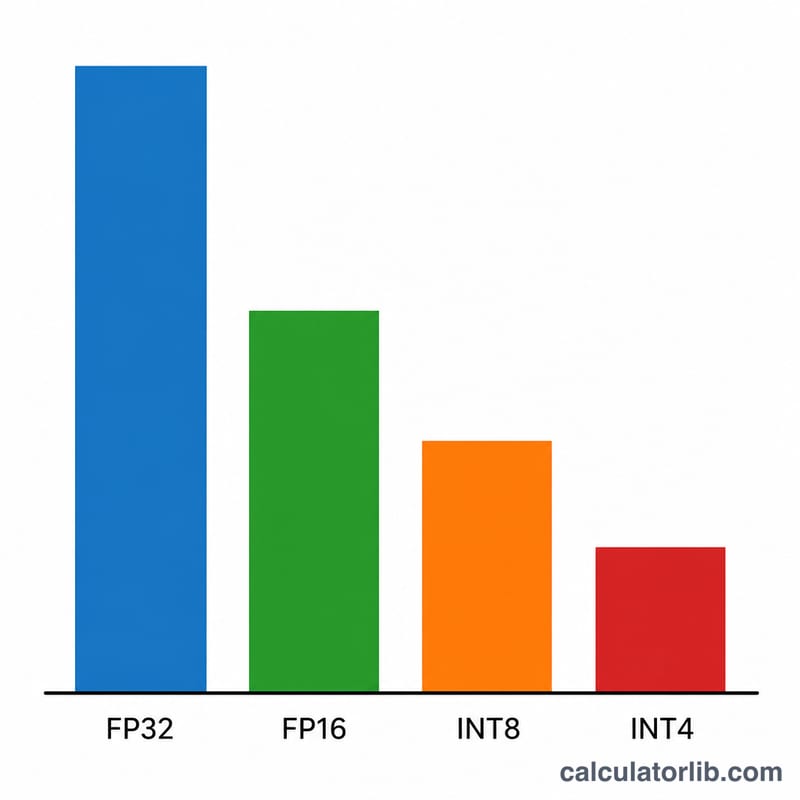
Estimaciones de VRAM para tamaños de modelo y precisiones comunes
La tabla usa la fórmula de la calculadora con el margen por defecto de 1.2: \(\text{VRAM (GB)} = \text{Parámetros (B)} \times \text{Bytes/Parámetro} \times 1.2\). Los bytes por parámetro son 2 para FP16, 1 para INT8 y 0.5 para INT4. Las notas de "Cabe en" comparan cada resultado con la capacidad nominal de una sola GPU, y la cantidad realmente utilizable es un poco menor.
| Tamaño del modelo | FP16 (GB) | INT8 (GB) | INT4 (GB) |
|---|---|---|---|
| 7B | 16.8 | 8.4 | 4.2 |
| 13B | 31.2 | 15.6 | 7.8 |
| 34B | 81.6 | 40.8 | 20.4 |
| 70B | 168 | 84 | 42 |
| 405B | 972 | 486 | 243 |
Qué nivel de GPU puede albergar cada estimación
- 7B: FP16 necesita una tarjeta de 24 GB (16.8 GB es demasiado para 16 GB). INT8 cabe en 16 GB. INT4 cabe en 8 GB.
- 13B: FP16 necesita 48 GB. INT8 (15.6 GB) apenas cabe en 16 GB, así que 24 GB es más cómodo. INT4 (7.8 GB) está muy justo en 8 GB, por lo que 16 GB es la opción práctica.
- 34B: FP16 (81.6 GB) supera una sola tarjeta de 80 GB, así que necesita varias GPU. INT8 cabe en 48 GB. INT4 cabe en 24 GB.
- 70B: FP16 (168 GB) necesita al menos tres GPU de 80 GB. INT8 (84 GB) supera una tarjeta de 80 GB, así que necesita dos GPU, por ejemplo 2×48 GB o 2×80 GB. INT4 (42 GB) cabe en 48 GB.
- 405B: todas las precisiones necesitan varias GPU. FP16 necesita al menos trece tarjetas de 80 GB, INT8 al menos siete e INT4 al menos cuatro.
Cuando la estimación supera la memoria de una tarjeta, el modelo debe dividirse entre varias GPU (paralelismo de tensores o de canalización). La velocidad de interconexión y la sobrecarga por GPU pasan a ser importantes, así que conviene dejar un margen adicional por encima de la simple división.
Bytes por parámetro según el formato de precisión
| Formato | Bytes por parámetro | Uso típico |
|---|---|---|
| FP32 | 4 | Líneas base de entrenamiento, investigación y trabajo sensible a la precisión numérica; rara vez se usa para servir LLM |
| FP16 / BF16 | 2 | Inferencia estándar de calidad completa y el formato de almacenamiento habitual de los checkpoints publicados |
| FP8 / INT8 | 1 | Servicio eficiente con poca pérdida de calidad en hardware y software compatibles |
| INT4 | 0.5 | Cuantización agresiva para inferencia local y GPU de consumo, con cierta pérdida de calidad |
Nota sobre los formatos reales de 4 bits: los esquemas prácticos de 4 bits, como GGUF Q4_K_M, GPTQ y AWQ, almacenan escalas por grupo y otros metadatos. Por ello usan algo más de 0.5 bytes por peso, aproximadamente entre 0.55 y 0.65. En estos formatos, conviene aumentar ligeramente el factor de margen o considerar que el resultado de INT4 es una ligera subestimación.
Factores de margen típicos según el caso de uso
| Caso de uso | Factor de margen |
|---|---|
| Contexto corto, un solo usuario | alrededor de 1.2 |
| Contexto largo o agrupación moderada de peticiones | alrededor de 1.5 a 2.0 |
| Agrupación intensa o servicio con contexto muy largo | 2.0 o más |
Son reglas orientativas, no estándares fijos. El motor de inferencia, la longitud del contexto y la concurrencia determinan el valor real.
Interpretación de tu estimación de VRAM
El resultado es una estimación aproximada, de tipo cota inferior, para la inferencia. Toma la memoria de los pesos y añade un porcentaje fijo para la caché KV, las activaciones, el contexto de CUDA y los búferes del framework. No es una medición exacta y no cubre el entrenamiento. El entrenamiento también almacena gradientes y estados del optimizador, que pueden requerir varias veces más memoria.
Cómo escala la caché KV
La caché KV crece linealmente con la longitud del contexto, el tamaño del lote, el número de capas y el tamaño oculto de las proyecciones de clave/valor:
$$\text{Caché KV (bytes)} \approx 2 \times L \times d_{kv} \times T \times B \times b$$
Aquí \(L\) es el número de capas, \(d_{kv}\) es el ancho de clave/valor, \(T\) es la longitud del contexto en tokens, \(B\) es el tamaño del lote (secuencias concurrentes) y \(b\) son los bytes por elemento de la caché. El factor 2 corresponde a claves y valores. Como ejemplo, un modelo con atención multicabezal estándar, 32 capas, tamaño oculto 4096 y caché FP16 con 4096 tokens necesita \(2 \times 32 \times 4096 \times 4096 \times 2 = 2{,}147{,}483{,}648\) bytes, unos 2.1 GB por secuencia. Los modelos que usan atención de consultas agrupadas tienen un \(d_{kv}\) menor y, por tanto, una caché mucho más pequeña. Con contextos largos o muchos usuarios concurrentes, la caché puede igualar o superar a los pesos, así que en esos casos conviene aumentar el factor de margen.
Comparación con la memoria utilizable
Compara la estimación con la memoria utilizable de la GPU, no con la cifra nominal. El controlador, el contexto de CUDA y la pantalla (si la GPU también controla un monitor) ocupan memoria, y los motores de inferencia suelen reservar una fracción del resto. Una tarjeta vendida como de 24 GB ofrece normalmente bastante menos para el modelo. Si tu estimación está a menos de unos pocos puntos porcentuales del tamaño de la tarjeta, supón que no cabrá.
Varias GPU
Con paralelismo de tensores, los pesos y la caché KV se reparten entre las GPU, de modo que cada tarjeta contiene aproximadamente su parte del total. Cada GPU sigue teniendo su propio contexto de CUDA y búferes, y los búferes de comunicación añaden más, por lo que el total de todas las GPU resulta algo mayor que la estimación de una sola GPU.
Modelos de mezcla de expertos
Para los modelos de mezcla de expertos (MoE), introduce el recuento total de parámetros, no el de parámetros activos. Solo algunos expertos se ejecutan para cada token, lo que reduce el cálculo, pero todos los pesos de los expertos normalmente deben permanecer residentes en la VRAM para que el enrutador pueda elegir cualquiera de ellos.
Esta es información general con fines de planificación. Comprueba el uso real con tu propio software y carga de trabajo.
Preguntas frecuentes
¿Por qué el uso real es mayor que el peso bruto del modelo? La caché KV crece con la longitud del contexto y el tamaño del lote, y el framework reserva memoria para las activaciones y los búferes: eso es lo que aproxima el factor de margen.
¿Incluye el entrenamiento? No. El entrenamiento necesita aproximadamente entre 3 y 4 veces más memoria para los estados del optimizador y los gradientes; esta estimación está pensada para la inferencia.
¿Qué margen debería usar? Usa alrededor de 1,2 para prompts cortos y entre 1,5 y 2,0 o más para contextos largos o un batching intensivo.