Что такое калькулятор требований к VRAM для LLM?
Этот инструмент помогает прикинуть, сколько видеопамяти GPU (VRAM) понадобится, чтобы загрузить и запустить большую языковую модель (LLM) в режиме инференса. Основной вес здесь имеют два фактора: количество параметров модели и точность, с которой хранится каждый вес. Дополнительно учитывается коэффициент запаса — он отражает память под KV-кэш, активации и контекст CUDA, которые «съедают» ресурсы сверх самих весов.
Как пользоваться калькулятором
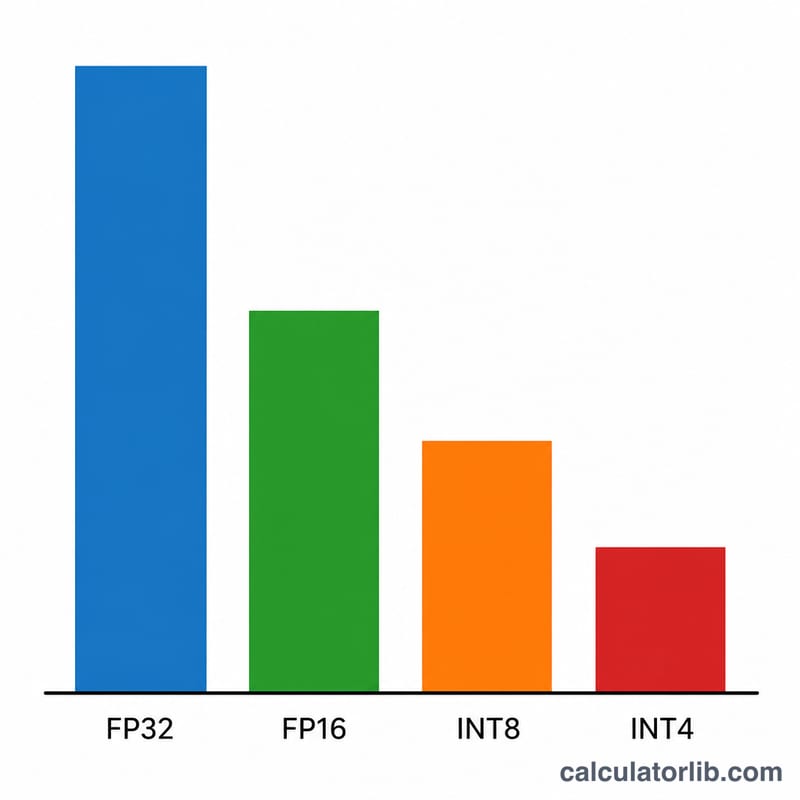
Укажите размер модели в миллиардах параметров (например, 7 для модели 7B или 70 для Llama-3 70B). Выберите точность: FP32 занимает 4 байта на вес, FP16/BF16 — 2 байта, INT8 — 1 байт, а квантизация INT4 — всего 0,5 байта. Наконец, задайте коэффициент запаса: значение 1,2 (запас 20%) — разумный вариант по умолчанию для инференса с коротким контекстом, а для длинных контекстов или батчинга его стоит увеличить.
Разбор формулы
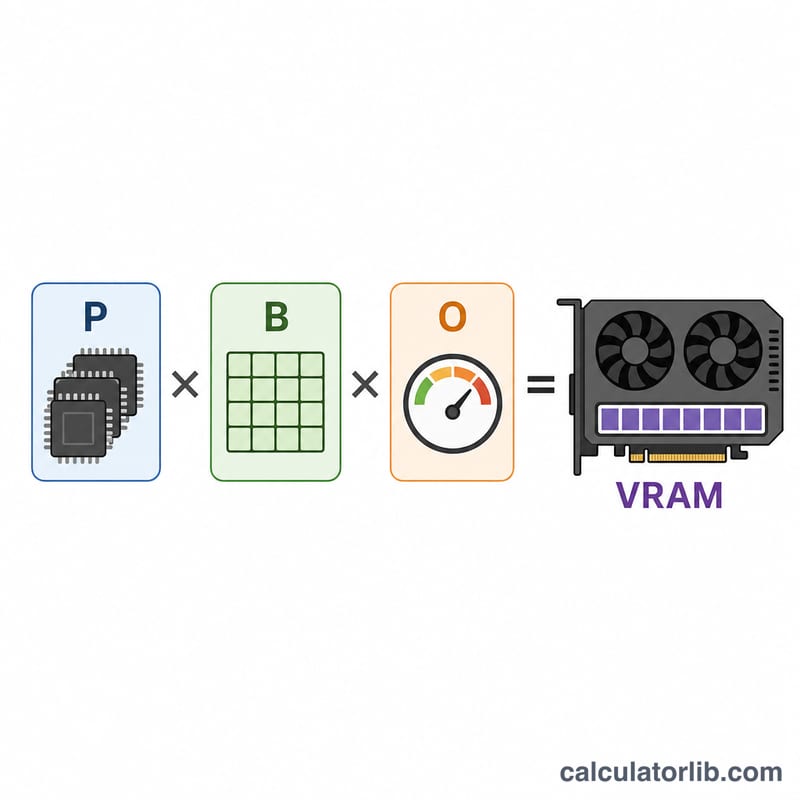
$$\text{VRAM (ГБ)} = \text{Параметры (млрд)} \times \text{Байт на параметр} \times \text{Коэффициент запаса}$$ Поскольку 1 миллиард байт ≈ 1 ГБ, умножение количества параметров в миллиардах на число байт на параметр сразу даёт результат в гигабайтах. Коэффициент запаса затем увеличивает эту цифру, чтобы покрыть память, расходуемую во время работы.
Пример расчёта
Для модели 7B в формате FP16 с коэффициентом запаса 1,2: $$7 \times 2 \times 1{,}2 = 16{,}8 \text{ ГБ}$$ Это спокойно помещается на карте с 24 ГБ. Та же модель в INT4: $$7 \times 0{,}5 \times 1{,}2 = 4{,}2 \text{ ГБ}$$ — легко работает даже на видеокарте с 8 ГБ.
Частые вопросы
Почему реальное потребление выше, чем вес самих весов? KV-кэш растёт вместе с длиной контекста и размером батча, а фреймворк резервирует память под активации и буферы — именно это и учитывает коэффициент запаса.
Учитывает ли расчёт обучение? Нет. Для обучения нужно примерно в 3–4 раза больше памяти под состояния оптимизатора и градиенты; эта оценка рассчитана на инференс.
Какой коэффициент запаса выбрать? Используйте около 1,2 для коротких запросов и 1,5–2,0 и выше — для длинных контекстов или интенсивного батчинга.
Оценки VRAM для распространённых размеров моделей и точностей
В таблице используется формула калькулятора со значением накладных расходов по умолчанию 1,2: \(\text{VRAM (GB)} = \text{Params (B)} \times \text{Bytes/Param} \times 1.2\). Количество байт на параметр: 2 для FP16, 1 для INT8 и 0,5 для INT4. Примечания «Помещается на» сравнивают каждый результат с номинальной ёмкостью одного GPU, а реально доступный объём немного меньше.
| Размер модели | FP16 (GB) | INT8 (GB) | INT4 (GB) |
|---|---|---|---|
| 7B | 16.8 | 8.4 | 4.2 |
| 13B | 31.2 | 15.6 | 7.8 |
| 34B | 81.6 | 40.8 | 20.4 |
| 70B | 168 | 84 | 42 |
| 405B | 972 | 486 | 243 |
Какой класс GPU может вместить каждую оценку
- 7B: FP16 требует карту на 24 GB (16,8 GB слишком много для 16 GB). INT8 помещается в 16 GB. INT4 помещается в 8 GB.
- 13B: FP16 требует 48 GB. INT8 (15,6 GB) едва помещается в 16 GB, поэтому 24 GB предпочтительнее. INT4 (7,8 GB) на 8 GB помещается с очень малым запасом, поэтому практичный выбор — 16 GB.
- 34B: FP16 (81,6 GB) превышает одну карту на 80 GB, поэтому нужно несколько GPU. INT8 помещается в 48 GB. INT4 помещается в 24 GB.
- 70B: FP16 (168 GB) требует минимум три GPU по 80 GB. INT8 (84 GB) превышает одну карту на 80 GB, поэтому нужны два GPU, например 2×48 GB или 2×80 GB. INT4 (42 GB) помещается в 48 GB.
- 405B: каждая точность требует нескольких GPU. FP16 требует минимум тринадцать карт по 80 GB, INT8 — минимум семь, а INT4 — минимум четыре.
Когда оценка превышает память одной карты, модель нужно разделить между несколькими GPU (тензорный или конвейерный параллелизм). Тогда важны скорость межсоединений и накладные расходы на каждый GPU, поэтому заложите запас сверх простого деления.
Количество байт на параметр по формату точности
| Формат | Байт на параметр | Типичное применение |
|---|---|---|
| FP32 | 4 | Базовые линии обучения, исследования и вычислительно чувствительные задачи; для обслуживания LLM почти не используется |
| FP16 / BF16 | 2 | Стандартный инференс полного качества и обычный формат хранения опубликованных контрольных точек |
| FP8 / INT8 | 1 | Эффективное обслуживание с небольшой потерей качества на поддерживаемом оборудовании и программном обеспечении |
| INT4 | 0,5 | Агрессивная квантизация для локального инференса и потребительских GPU, с некоторой потерей качества |
Примечание о реальных 4-битных форматах: практические 4-битные схемы, такие как GGUF Q4_K_M, GPTQ и AWQ, хранят масштабы для групп и другие метаданные. Поэтому они используют немного больше 0,5 байта на вес, примерно 0,55–0,65. Для этих форматов либо немного увеличьте коэффициент накладных расходов, либо считайте результат INT4 слегка заниженным.
Типичные коэффициенты накладных расходов по сценариям использования
| Сценарий использования | Коэффициент накладных расходов |
|---|---|
| Короткий контекст, один пользователь | около 1,2 |
| Длинный контекст или умеренный батчинг | около 1,5–2,0 |
| Интенсивный батчинг или обслуживание очень длинного контекста | 2,0 и более |
Это эмпирические правила, а не фиксированные стандарты. Истинное значение определяют ваш движок инференса, длина контекста и число одновременных запросов.
Интерпретация вашей оценки VRAM
Результат — приблизительная оценка нижнего порядка для инференса. Она учитывает память под веса и добавляет фиксированный процент на KV-кэш, активации, контекст CUDA и буферы фреймворка. Это не точное измерение, и она не охватывает обучение. Обучение также хранит градиенты и состояния оптимизатора, которые могут требовать в несколько раз больше памяти.
Как масштабируется KV-кэш
KV-кэш растёт линейно с длиной контекста, размером батча, числом слоёв и размерностью скрытого слоя проекций ключей/значений:
$$\text{KV cache (bytes)} \approx 2 \times L \times d_{kv} \times T \times B \times b$$
Здесь \(L\) — число слоёв, \(d_{kv}\) — ширина ключей/значений, \(T\) — длина контекста в токенах, \(B\) — размер батча (одновременные последовательности), а \(b\) — количество байт на элемент кэша. Множитель 2 учитывает ключи и значения. Например, модель со стандартным многоголовым вниманием, 32 слоями, скрытым размером 4096 и кэшем FP16 при 4096 токенах требует \(2 \times 32 \times 4096 \times 4096 \times 2 = 2{,}147{,}483{,}648\) байт, примерно 2,1 GB на последовательность. Модели с групповым вниманием (grouped-query attention) имеют меньшее \(d_{kv}\) и, следовательно, гораздо меньший кэш. При длинных контекстах или большом числе одновременных пользователей кэш может сравняться с весами или превысить их, поэтому в таких случаях повышайте коэффициент накладных расходов.
Сравнение с доступной памятью
Сравнивайте оценку с доступной памятью GPU, а не с номинальным значением. Драйвер, контекст CUDA и дисплей (если GPU также выводит изображение на монитор) занимают часть памяти, а движки инференса обычно резервируют часть оставшейся. Карта, продаваемая как 24 GB, обычно предоставляет для модели заметно меньше. Если оценка находится в пределах нескольких процентов от объёма карты, считайте, что она не поместится.
Несколько GPU
При тензорном параллелизме веса и KV-кэш делятся между GPU, поэтому каждая карта содержит примерно свою долю общего объёма. Каждый GPU по-прежнему несёт собственный контекст CUDA и буферы, а буферы обмена добавляют ещё, поэтому суммарный объём по всем GPU оказывается несколько выше оценки для одного GPU.
Модели «смеси экспертов»
Для моделей «смеси экспертов» (Mixture-of-Experts, MoE) вводите общее число параметров, а не число активных. Для каждого токена работает лишь часть экспертов, что снижает вычислительную нагрузку, но все веса экспертов обычно должны постоянно находиться в VRAM, чтобы маршрутизатор мог выбрать любого из них.
Это общая информация для целей планирования. Проверяйте реальное потребление с помощью собственного программного обеспечения и вашей нагрузки.