Qu'est-ce que le convertisseur tokens-mots ?
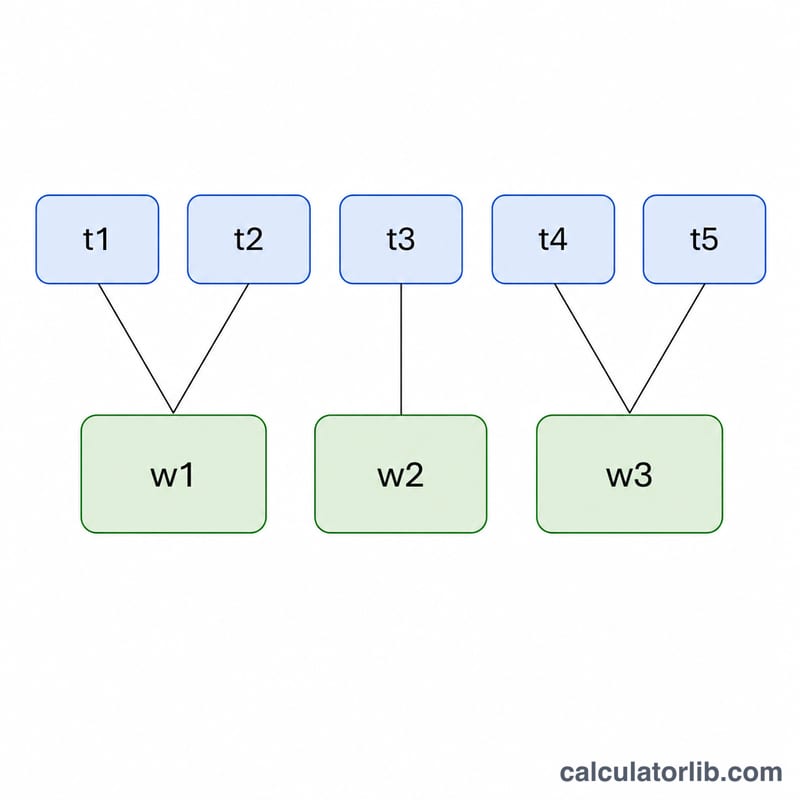
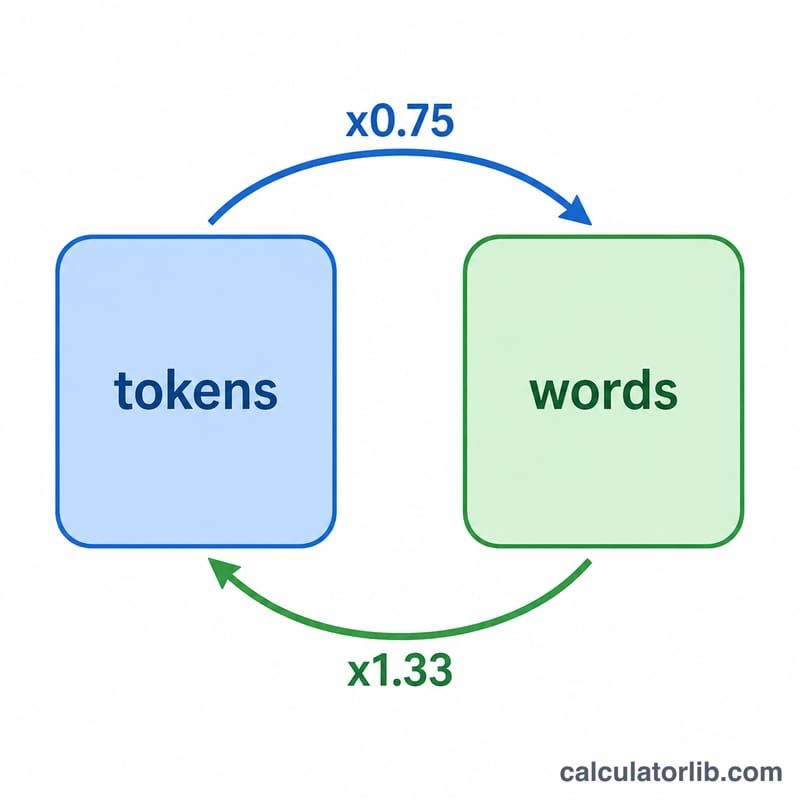
Les grands modèles de langage (LLM) tels que GPT, Claude ou Gemini ne lisent pas le texte mot à mot : ils le traitent sous forme de tokens. Un token est un fragment de texte qui peut correspondre à un mot entier, à une partie de mot, voire à un signe de ponctuation. Pour un texte courant en anglais, un token équivaut à environ 0,75 mot (soit à peu près 1,33 token par mot). Cet outil transforme un nombre de tokens en une estimation de mots, ou un nombre de mots en tokens qu'ils consommeront probablement.
Comment l'utiliser
Choisissez un sens de conversion — Tokens vers mots ou Mots vers tokens —, saisissez votre valeur et, si vous le souhaitez, ajustez le ratio de mots par token (0,75 par défaut). Le résultat s'affiche immédiatement, accompagné du ratio appliqué. Baissez le ratio pour du code ou des textes en langue autre que l'anglais (qui mobilisent davantage de tokens), et augmentez-le pour de l'anglais simple et répétitif.
La formule expliquée
La conversion repose sur une simple règle de trois. Pour estimer les mots à partir des tokens :
$$\text{mots} = \text{tokens} \times \text{ratio}$$Pour estimer les tokens à partir des mots :
$$\text{tokens} = \frac{\text{mots}}{\text{ratio}}$$Avec le ratio par défaut de 0,75, \(1\,000\) tokens \(\approx 750\) mots, et \(1\,000\) mots \(\approx 1\,333\) tokens. Ce ne sont que des estimations : la tokenisation réelle dépend du modèle, de la langue et du contenu.
Exemple concret
Imaginons qu'un appel d'API indique avoir consommé 1 000 tokens. Avec le ratio par défaut :
$$1000 \times 0{,}75 = 750 \text{ mots}$$À l'inverse, si vous avez rédigé un essai de 1 500 mots et souhaitez connaître son coût en tokens :
$$\frac{1500}{0{,}75} = 2\,000 \text{ tokens}$$— pratique pour rester dans la fenêtre de contexte d'un modèle ou maîtriser votre budget d'API.
Conversions courantes entre jetons et mots
Le tableau ci-dessous utilise la règle empirique courante d'environ 0,75 mot par jeton (soit environ 4 caractères de texte anglais par jeton), donc \(\text{Mots} = \text{Jetons} \times 0.75\). Les pages supposent environ 500 mots par page simple interligne. Toutes les valeurs sont des estimations ; les décomptes réels dépendent du tokenizer, de la langue et du contenu.
| Jetons | Mots approx. (×0,75) | Pages approx. (~500 mots/page) |
|---|---|---|
| 100 | 75 | 0,15 |
| 500 | 375 | 0,75 |
| 1 000 | 750 | 1,5 |
| 4 000 | 3 000 | 6 |
| 8 000 | 6 000 | 12 |
| 32 000 | 24 000 | 48 |
| 128 000 | 96 000 | 192 |
| 200 000 | 150 000 | 300 |
Pour faire le chemin inverse, divisez les mots par le ratio : \(\text{Jetons} = \text{Mots} \div 0.75\). Par exemple, 1 500 mots ≈ \(1500 \div 0.75 = 2000\) jetons.
Mots par jeton selon le type de contenu
Différents types de texte se découpent en jetons de manière différente. Les ratios ci-dessous sont des règles empiriques approximatives qui varient selon le tokenizer et le modèle ; traitez donc les résultats comme des estimations et utilisez le tokenizer officiel de votre fournisseur lorsque la précision est importante.
| Type de contenu | Mots par jeton typiques (approx.) | Mots dans 1 000 jetons (approx.) |
|---|---|---|
| Prose anglaise courante | ~0,75 | ~750 |
| Anglais technique ou juridique | ~0,65–0,70 | ~650–700 |
| Code source | ~0,5–0,6 | ~500–600 |
| Textes non anglais ou écritures non latines | ~0,3–0,5 | ~300–500 |
| Texte riche en chiffres et caractères spéciaux | Souvent inférieur à ~0,5 (très variable) | Souvent inférieur à ~500 |
Pourquoi ces différences ? Les mots anglais courants forment souvent un seul jeton, tandis que les mots rares, les termes techniques longs, les symboles, les chiffres et de nombreux caractères non latins sont découpés en plusieurs morceaux plus petits. Le code compte aussi les espaces, la ponctuation et les symboles, ce qui réduit le nombre de mots par jeton. Dans le calculateur, modifiez le champ du ratio pour correspondre à votre type de contenu.
Termes clés : jetons, fenêtre de contexte et tokenizer
- Jeton
- L'unité de base du texte qu'un modèle de langage lit et écrit. Un jeton peut être un mot entier, une partie de mot, un signe de ponctuation ou un bloc espace-plus-mot.
- Tokenizer
- Le composant qui convertit un texte en une séquence de jetons (et inversement). Chaque famille de modèles utilise son propre tokenizer et son propre vocabulaire, si bien que le même texte peut produire des nombres de jetons différents.
- Codage par paires d'octets (BPE)
- Une méthode de tokenisation courante qui part de petites unités (comme des octets ou des caractères) et fusionne de façon répétée les paires adjacentes les plus fréquentes en jetons plus grands, construisant un vocabulaire où les mots courants sont des jetons uniques et les mots rares sont découpés en morceaux.
- Fenêtre de contexte
- Le nombre maximal de jetons qu'un modèle peut traiter en une seule requête, couvrant généralement ensemble l'invite, l'historique de la conversation et la réponse générée.
- Jetons d'entrée et de sortie
- Les jetons d'entrée sont ceux que vous envoyez au modèle (invite, documents, historique) ; les jetons de sortie sont ceux que le modèle génère. Les fournisseurs les comptent souvent séparément et peuvent les facturer et les limiter différemment.
- Ratio mots par jeton
- Le nombre moyen de mots représentés par un jeton. Environ 0,75 est une règle empirique courante pour la prose anglaise (environ 1 jeton ≈ 4 caractères), mais il s'agit d'une approximation qui varie selon la langue et le type de contenu.
FAQ
La valeur de 0,75 mot par token est-elle toujours exacte ? Non : il s'agit d'une règle empirique largement citée pour l'anglais. Le code, les chiffres et les autres langues consomment souvent plus de tokens par mot ; appliquez alors un ratio plus faible.
Pourquoi les tokens sont-ils importants ? La tarification des LLM et les limites de contexte se mesurent en tokens, et non en mots. La conversion vous aide donc à estimer le coût et la capacité disponible.
Comment obtenir un décompte exact ? Utilisez le tokeniseur officiel du modèle (par exemple tiktoken pour OpenAI). Ce calculateur fournit une approximation rapide, et non un décompte exact.