什么是F1分数?
F1分数是一项把精确率(Precision)和召回率(Recall)融合为单一数值的综合指标,因此在机器学习、信息检索和统计学领域被广泛用于评估分类模型的好坏。它本质上是精确率与召回率的调和平均数,会奖励两者兼顾、整体均衡的分类器,而不是只在某一项上表现突出的模型。
如何使用本计算器
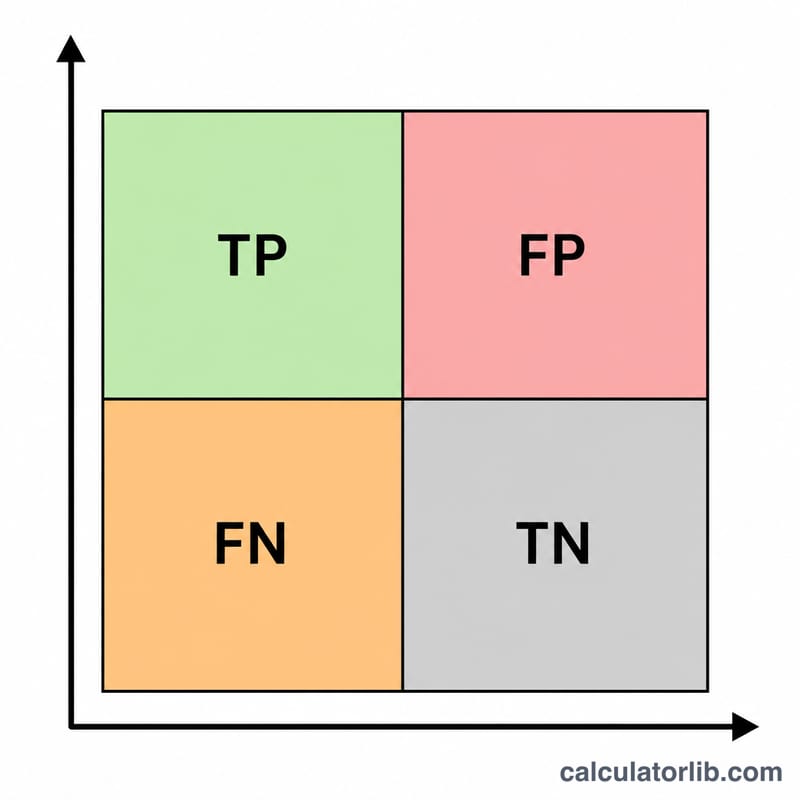
从你的混淆矩阵中填入三个计数值:真阳性(TP,被正确预测为正例的样本)、假阳性(FP,本是负例却被错误预测为正例的样本)、假阴性(FN,本是正例却被漏判的样本)。计算器会即时给出精确率、召回率以及对应的F1分数。
计算公式详解
精确率 = \(\text{TP} / (\text{TP} + \text{FP})\),衡量在所有被预测为正例的样本中,真正预测对了多少。召回率 = \(\text{TP} / (\text{TP} + \text{FN})\),衡量在所有实际正例中,模型成功找出了多少。F1分数则为
$$F_1 = \frac{2 \cdot (\text{Precision} \cdot \text{Recall})}{\text{Precision} + \text{Recall}}$$由于它是调和平均数,只要精确率或召回率中任意一项偏低,F1分数都会被大幅拉低。
实例演算
假设 \(\text{TP} = 70\),\(\text{FP} = 30\),\(\text{FN} = 10\)。精确率 = \(70 / 100 = 0.70\);召回率 = \(70 / 80 = 0.875\);
$$F_1 = \frac{2 \cdot (0.70 \cdot 0.875)}{0.70 + 0.875} = \frac{2 \cdot 0.6125}{1.575} \approx 0.7778$$即约77.78%。
不同精确率与召回率情形下的F1分数
F1是精确率与召回率的调和平均数:\(F_1 = \frac{2PR}{P+R}\)。下表将其与简单算术平均数进行了比较,列出了若干组精确率(P)与召回率(R)的组合。
| 精确率 | 召回率 | 算术平均数 | F1 |
|---|---|---|---|
| 0.90 | 0.90 | 0.900 | 0.900 |
| 0.99 | 0.50 | 0.745 | ≈ 0.664 |
| 0.80 | 0.60 | 0.700 | ≈ 0.686 |
| 1.00 | 0.10 | 0.550 | ≈ 0.182 |
| 0.50 | 0.50 | 0.500 | 0.500 |
例如,0.80/0.60这一行对应 TP = 60、FP = 15、FN = 40:精确率 = 60/75 = 0.80,召回率 = 60/100 = 0.60,且 \(F_1 = \frac{2 \cdot 60}{2 \cdot 60 + 15 + 40} = \frac{120}{175} \approx 0.686\)。
注:与算术平均数相比,F1总是更接近两个数值中较小的那个。当精确率与召回率相等时,F1与两者都相等。两者差距越大,F1就越会被拉向较弱的那一个,因此模型无法用出色的精确率掩盖糟糕的召回率(反之亦然)。
混淆矩阵术语及相关指标
- 真正例(TP):模型正确预测为正例的正类样本。
- 假正例(FP):被错误预测为正例的负类样本(误报,第一类错误)。
- 假负例(FN):被错误预测为负例的正类样本(漏报,第二类错误)。
- 真负例(TN):模型正确预测为负例的负类样本。F1公式中不使用TN。
- 精确率(阳性预测值):\(\frac{TP}{TP + FP}\),即预测为正例的样本中真正为正例的比例。
- 召回率(灵敏度、真正例率):\(\frac{TP}{TP + FN}\),即实际正例中被模型找出的比例。
- 准确率:\(\frac{TP + TN}{TP + TN + FP + FN}\),即所有预测中正确预测的比例。在不平衡数据上可能具有误导性。
- 特异度(真负例率):\(\frac{TN}{TN + FP}\),即实际负例中被正确识别的比例。
- F-beta分数:\(F_\beta = \frac{(1+\beta^2) PR}{\beta^2 P + R}\)。F1即\(\beta = 1\)的情形。F2(\(\beta = 2\))更重视召回率;F0.5(\(\beta = 0.5\))更重视精确率。
- 宏平均:分别计算每个类别的F1,再取未加权的平均值,因此每个类别的权重相同。
- 微平均:汇总所有类别的TP、FP和FN,计算一个总体F1,因此样本量大的类别影响更大。
- 加权平均:按每个类别的真实样本数(支持度)对各类别的F1分数进行加权平均。
如何解读你的F1分数
F1的取值范围从0(没有真正例)到1(没有假正例和假负例)。作为一个粗略的非正式参考:
- 约0至0.5:较弱
- 0.5至0.7:中等
- 0.7至0.9:良好
- 高于0.9:非常强
这些区间依赖于具体情境,并不存在通用标准。对于标签含噪声的稀有事件检测等困难任务,0.6的F1可能已属优秀;而在安全关键场景中,0.95也可能不够。
精确率与召回率之间的差距意味着什么
- 精确率较低、召回率较高:模型能找出大部分正例,但会产生许多误报。
- 召回率较低、精确率较高:模型的正例预测较为可靠,但漏掉了许多实际正例。
应同时查看两个数值,而不要只依赖F1,因为同一个F1可能来自截然不同的精确率/召回率组合。
需要注意的局限性
- F1忽略真负例,因此无法反映模型在负类上的表现。
- F1依赖类别平衡程度。同一模型在正例比例不同的数据集上得分可能不同。
- F1依赖决策阈值。调整阈值会在精确率与召回率之间权衡,并使F1随之变化。
- 应始终与基线进行比较,例如多数类预测器、总是预测为正例的预测器,或某个简单的现有模型,以判断分数是否代表真正的提升。
常见问题
什么时候该用F1而不是准确率(Accuracy)?当各类别样本数量不平衡时,更推荐使用F1。因为在某一类别占绝对多数的情况下,准确率往往会虚高,给人误导性的乐观印象。
F1分数多高才算好?F1的取值范围是0到1,越接近1越好。具体多少算"好"要看任务类型,但通常超过0.8就被认为表现相当不错。
为什么要用调和平均数?相比简单的算术平均,调和平均会对精确率与召回率之间的严重失衡给予更重的惩罚,从而确保两项指标都必须保持在合理较高的水平。