F1 Score là gì?
F1 score là một chỉ số duy nhất kết hợp precision (độ chính xác) và recall (độ phủ) thành một con số, nên rất được ưa chuộng khi đánh giá các mô hình phân loại trong máy học, truy hồi thông tin và thống kê. Đây chính là trung bình điều hòa của precision và recall, vì vậy nó ưu tiên những mô hình cân bằng được cả hai yếu tố thay vì chỉ giỏi ở một mặt.
Cách sử dụng công cụ
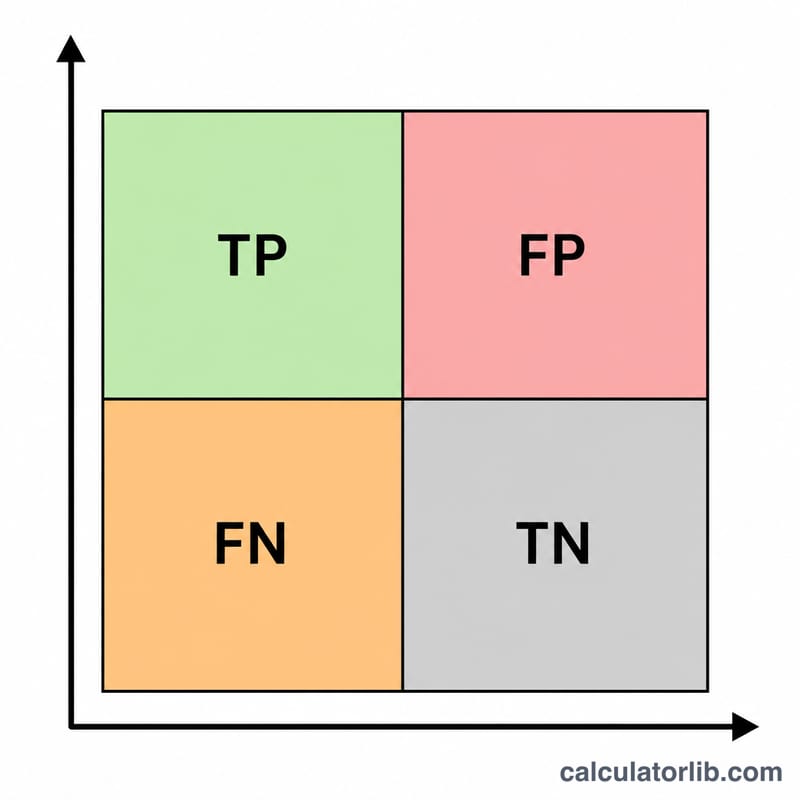
Bạn chỉ cần nhập ba con số từ ma trận nhầm lẫn (confusion matrix): True Positive (TP — số trường hợp dương tính được dự đoán đúng), False Positive (FP — số trường hợp âm tính bị dự đoán nhầm thành dương tính) và False Negative (FN — số trường hợp dương tính bị bỏ sót). Công cụ sẽ lập tức trả về precision, recall và F1 score tương ứng.
Giải thích công thức
Precision = \( \dfrac{\text{TP}}{\text{TP} + \text{FP}} \) cho biết trong số các trường hợp được dự đoán là dương tính thì có bao nhiêu dự đoán đúng. Recall = \( \dfrac{\text{TP}}{\text{TP} + \text{FN}} \) cho biết trong số các trường hợp dương tính thực tế thì mô hình phát hiện được bao nhiêu. Khi đó
$$ F_1 = \frac{2 \cdot (\text{precision} \cdot \text{recall})}{\text{precision} + \text{recall}} $$Vì là trung bình điều hòa nên chỉ cần precision hoặc recall thấp là F1 score sẽ tụt xuống rõ rệt.
Ví dụ minh họa
Giả sử \( \text{TP} = 70 \), \( \text{FP} = 30 \), \( \text{FN} = 10 \). Precision = \( \dfrac{70}{100} = 0{,}70 \). Recall = \( \dfrac{70}{80} = 0{,}875 \).
$$ F_1 = \frac{2 \cdot (0{,}70 \cdot 0{,}875)}{0{,}70 + 0{,}875} = \frac{2 \cdot 0{,}6125}{1{,}575} \approx 0{,}7778 $$tức khoảng 77,78%.
Điểm F1 trong các tình huống Precision và Recall khác nhau
F1 là trung bình điều hòa của precision và recall: \(F_1 = \frac{2PR}{P+R}\). Bảng so sánh điểm này với trung bình cộng đơn giản cho một số cặp precision (P) và recall (R).
| Precision | Recall | Trung bình cộng | F1 |
|---|---|---|---|
| 0.90 | 0.90 | 0.900 | 0.900 |
| 0.99 | 0.50 | 0.745 | ≈ 0.664 |
| 0.80 | 0.60 | 0.700 | ≈ 0.686 |
| 1.00 | 0.10 | 0.550 | ≈ 0.182 |
| 0.50 | 0.50 | 0.500 | 0.500 |
Ví dụ, dòng 0.80/0.60 tương ứng với TP = 60, FP = 15, FN = 40: precision = 60/75 = 0.80, recall = 60/100 = 0.60, và \(F_1 = \frac{2 \cdot 60}{2 \cdot 60 + 15 + 40} = \frac{120}{175} \approx 0.686\).
Lưu ý: F1 luôn gần với giá trị nhỏ hơn trong hai giá trị hơn so với trung bình cộng. Khi precision và recall bằng nhau, F1 cũng bằng đúng giá trị đó. Hai giá trị càng chênh lệch, F1 càng bị kéo xuống gần phía yếu hơn, nên một mô hình không thể che giấu recall kém bằng precision xuất sắc (hoặc ngược lại).
Các thuật ngữ ma trận nhầm lẫn và các chỉ số liên quan
- True Positive (TP): một trường hợp dương tính mà mô hình dự đoán đúng là dương tính.
- False Positive (FP): một trường hợp âm tính bị dự đoán nhầm là dương tính (báo động giả, lỗi loại I).
- False Negative (FN): một trường hợp dương tính bị dự đoán nhầm là âm tính (bỏ sót, lỗi loại II).
- True Negative (TN): một trường hợp âm tính được dự đoán đúng là âm tính. TN không được sử dụng trong công thức F1.
- Precision (giá trị dự đoán dương tính): \(\frac{TP}{TP + FP}\), tỷ lệ các dự đoán dương tính thực sự là dương tính.
- Recall (độ nhạy, tỷ lệ dương tính thật): \(\frac{TP}{TP + FN}\), tỷ lệ các trường hợp dương tính thực tế mà mô hình tìm ra.
- Accuracy (độ chính xác tổng thể): \(\frac{TP + TN}{TP + TN + FP + FN}\), tỷ lệ tất cả các dự đoán đúng. Chỉ số này có thể gây hiểu lầm trên dữ liệu mất cân bằng.
- Specificity (tỷ lệ âm tính thật): \(\frac{TN}{TN + FP}\), tỷ lệ các trường hợp âm tính thực tế được nhận diện đúng.
- F-beta score: \(F_\beta = \frac{(1+\beta^2) PR}{\beta^2 P + R}\). F1 là trường hợp \(\beta = 1\). F2 (\(\beta = 2\)) đặt trọng số recall cao hơn; F0.5 (\(\beta = 0.5\)) đặt trọng số precision cao hơn.
- Macro averaging (trung bình macro): tính F1 cho từng lớp rồi lấy trung bình không trọng số, nên mọi lớp đều có vai trò như nhau.
- Micro averaging (trung bình micro): gộp TP, FP và FN của tất cả các lớp rồi tính một F1 duy nhất, nên các lớp xuất hiện thường xuyên sẽ chiếm ưu thế.
- Weighted averaging (trung bình có trọng số): lấy trung bình điểm F1 của từng lớp, có trọng số theo số lượng trường hợp dương tính thực tế của mỗi lớp (support).
Diễn giải điểm F1 của bạn
F1 nằm trong khoảng từ 0 (không có true positive) đến 1 (không có false positive và không có false negative). Như một hướng dẫn sơ bộ, không chính thức:
- Khoảng 0 đến 0.5: yếu
- 0.5 đến 0.7: trung bình
- 0.7 đến 0.9: tốt
- Trên 0.9: rất mạnh
Các mức này phụ thuộc vào ngữ cảnh và không tồn tại tiêu chuẩn chung nào. Điểm F1 0.6 có thể là xuất sắc đối với một bài toán khó như phát hiện sự kiện hiếm với nhãn nhiễu, trong khi 0.95 có thể là chưa đủ trong một bối cảnh liên quan đến an toàn.
Ý nghĩa của khoảng cách giữa precision và recall
- Precision thấp, recall cao hơn: mô hình tìm được phần lớn các trường hợp dương tính nhưng tạo ra nhiều báo động giả.
- Recall thấp, precision cao hơn: các dự đoán dương tính của mô hình đáng tin cậy, nhưng nó bỏ sót nhiều trường hợp dương tính thực tế.
Hãy kiểm tra cả hai giá trị thay vì chỉ dựa vào F1, vì cùng một điểm F1 có thể đến từ những tổ hợp precision/recall rất khác nhau.
Những hạn chế cần lưu ý
- F1 bỏ qua true negative, nên không cho biết mô hình xử lý lớp âm tính tốt đến đâu.
- Nó phụ thuộc vào độ cân bằng của lớp. Cùng một mô hình có thể đạt điểm khác nhau trên các tập dữ liệu có tỷ lệ dương tính khác nhau.
- Nó phụ thuộc vào ngưỡng quyết định. Thay đổi ngưỡng sẽ đánh đổi precision lấy recall và làm thay đổi F1.
- Luôn so sánh với một mốc tham chiếu, chẳng hạn như bộ dự đoán luôn chọn lớp đa số hoặc luôn dự đoán dương tính, hoặc một mô hình hiện có đơn giản, để đánh giá xem điểm số có thực sự là cải thiện hay không.
Câu hỏi thường gặp
Khi nào nên dùng F1 thay vì accuracy? Bạn nên ưu tiên F1 khi dữ liệu bị mất cân bằng giữa các lớp, bởi vì accuracy có thể cao một cách đánh lừa khi một lớp chiếm đa số.
F1 score bao nhiêu là tốt? F1 dao động từ 0 đến 1; càng gần 1 càng tốt. Mức "tốt" còn tùy thuộc vào từng bài toán, nhưng giá trị trên 0,8 thường được xem là khá cao.
Vì sao lại dùng trung bình điều hòa? Trung bình điều hòa trừng phạt sự chênh lệch lớn giữa precision và recall mạnh hơn so với trung bình cộng thông thường, đảm bảo cả hai đều phải đạt mức hợp lý.