ما هي درجة F1؟
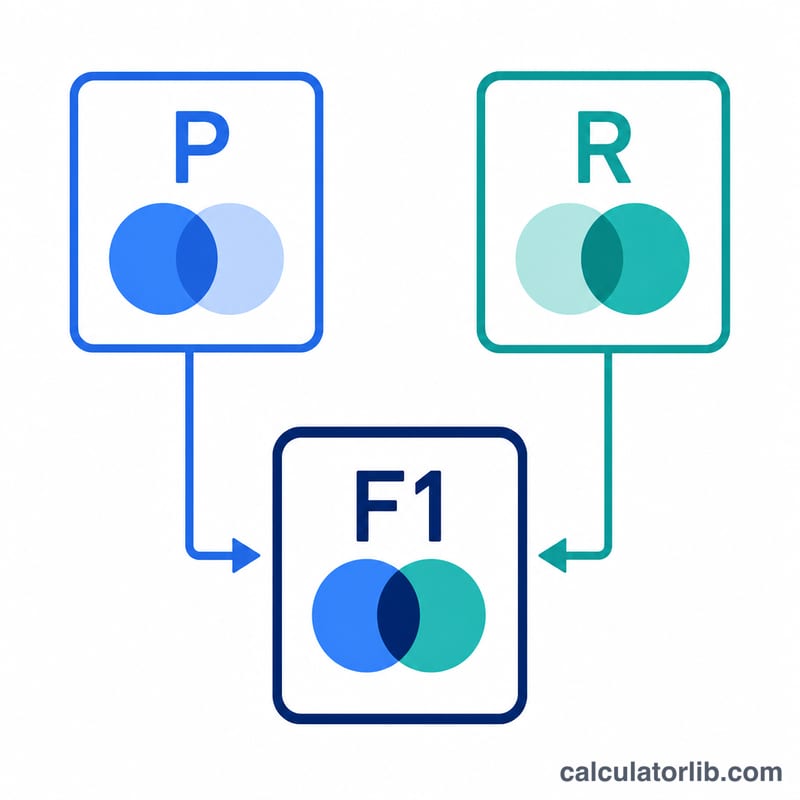
درجة F1 هي مقياس واحد يجمع بين الدقة (Precision) والاستدعاء (Recall) في رقم واحد، مما يجعلها وسيلة شائعة لتقييم نماذج التصنيف في تعلّم الآلة واسترجاع المعلومات والإحصاء. وهي المتوسط التوافقي (Harmonic Mean) للدقة والاستدعاء، لذا فهي تكافئ المصنّفات التي توازن بين الاثنين بدلًا من التفوّق في أحدهما فقط.
كيفية استخدام هذه الحاسبة
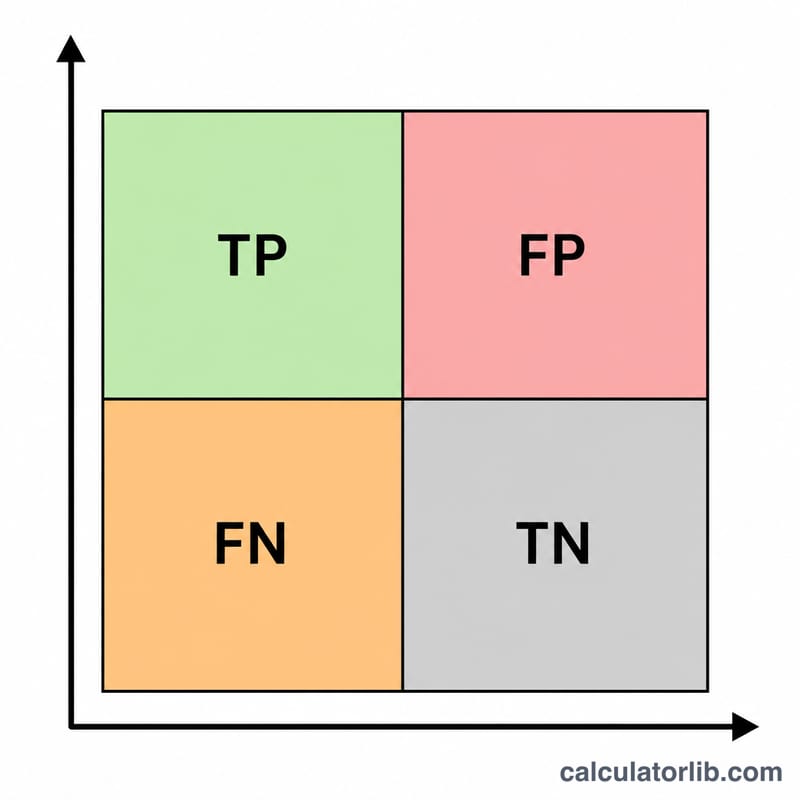
أدخل ثلاثة أرقام من مصفوفة الالتباس (Confusion Matrix) الخاصة بك: الإيجابيات الصحيحة (TP، الحالات الإيجابية التي تم التنبؤ بها بشكل صحيح)، والإيجابيات الكاذبة (FP، الحالات السلبية التي تم تصنيفها خطأً على أنها إيجابية)، والسلبيات الكاذبة (FN، الحالات الإيجابية التي فاتت المصنّف). تعرض الحاسبة فورًا قيم الدقة والاستدعاء ودرجة F1 الناتجة.
شرح المعادلة
الدقة \(= \text{TP} / (\text{TP} + \text{FP})\) وتقيس كم عدد التنبؤات الإيجابية التي كانت صحيحة. الاستدعاء \(= \text{TP} / (\text{TP} + \text{FN})\) ويقيس كم عدد الحالات الإيجابية الفعلية التي تم العثور عليها. ثم تُحسب درجة F1 بالصيغة
$$F_1 = 2 \cdot \frac{\text{Precision} \cdot \text{Recall}}{\text{Precision} + \text{Recall}}$$ولأنها متوسط توافقي، فإن أي قيمة منخفضة في الدقة أو الاستدعاء تخفض درجة F1 بشكل حاد.
مثال محلول
لنفترض أن \(\text{TP} = 70\) و\(\text{FP} = 30\) و\(\text{FN} = 10\). عندئذ تكون الدقة \(= 70 / 100 = 0.70\)، والاستدعاء \(= 70 / 80 = 0.875\). ومن ثَمّ
$$F_1 = 2 \cdot \frac{0.70 \cdot 0.875}{0.70 + 0.875} = 2 \cdot \frac{0.6125}{1.575} \approx 0.7778$$أي نحو 77.78%.
درجة F1 عبر سيناريوهات مختلفة من الدقة والاستدعاء
درجة F1 هي المتوسط التوافقي للدقة والاستدعاء: \(F_1 = \frac{2PR}{P+R}\). يقارن الجدول بينها وبين المتوسط الحسابي البسيط لعدة أزواج من الدقة (P) والاستدعاء (R).
| الدقة | الاستدعاء | المتوسط الحسابي | F1 |
|---|---|---|---|
| 0.90 | 0.90 | 0.900 | 0.900 |
| 0.99 | 0.50 | 0.745 | ≈ 0.664 |
| 0.80 | 0.60 | 0.700 | ≈ 0.686 |
| 1.00 | 0.10 | 0.550 | ≈ 0.182 |
| 0.50 | 0.50 | 0.500 | 0.500 |
يتوافق الصف 0.80/0.60 على سبيل المثال مع TP = 60، وFP = 15، وFN = 40: الدقة = 60/75 = 0.80، والاستدعاء = 60/100 = 0.60، و\(F_1 = \frac{2 \cdot 60}{2 \cdot 60 + 15 + 40} = \frac{120}{175} \approx 0.686\).
ملاحظة: تقع درجة F1 دائمًا أقرب إلى القيمة الأدنى من القيمتين مقارنةً بالمتوسط الحسابي. وعندما تتساوى الدقة والاستدعاء، تساوي درجة F1 كليهما. وكلما زاد الفرق بينهما انجذبت درجة F1 نحو القيمة الأضعف، لذلك لا يمكن للنموذج أن يخفي ضعف الاستدعاء خلف دقة ممتازة (أو العكس).
مصطلحات مصفوفة الارتباك والمقاييس ذات الصلة
- الإيجابي الحقيقي (TP): حالة إيجابية توقعها النموذج بشكل صحيح على أنها إيجابية.
- الإيجابي الكاذب (FP): حالة سلبية توقعها النموذج خطأً على أنها إيجابية (إنذار كاذب، خطأ من النوع الأول).
- السلبي الكاذب (FN): حالة إيجابية توقعها النموذج خطأً على أنها سلبية (حالة فائتة، خطأ من النوع الثاني).
- السلبي الحقيقي (TN): حالة سلبية توقعها النموذج بشكل صحيح على أنها سلبية. لا يُستخدم TN في صيغة F1.
- الدقة (القيمة التنبؤية الإيجابية): \(\frac{TP}{TP + FP}\)، وهي نسبة التوقعات الإيجابية التي هي إيجابية فعلًا.
- الاستدعاء (الحساسية، معدل الإيجابي الحقيقي): \(\frac{TP}{TP + FN}\)، وهي نسبة الحالات الإيجابية الفعلية التي يجدها النموذج.
- الدقة الكلية (Accuracy): \(\frac{TP + TN}{TP + TN + FP + FN}\)، وهي نسبة جميع التوقعات الصحيحة. وقد تكون مضللة في البيانات غير المتوازنة.
- الخصوصية (معدل السلبي الحقيقي): \(\frac{TN}{TN + FP}\)، وهي نسبة الحالات السلبية الفعلية التي تم تحديدها بشكل صحيح.
- درجة F-beta: \(F_\beta = \frac{(1+\beta^2) PR}{\beta^2 P + R}\). وتكون F1 الحالة \(\beta = 1\). أما F2 (\(\beta = 2\)) فتُرجّح الاستدعاء بشكل أكبر، وF0.5 (\(\beta = 0.5\)) تُرجّح الدقة بشكل أكبر.
- المتوسط الكلي (Macro averaging): احسب F1 لكل فئة ثم خذ متوسطها غير المرجح، بحيث تُحتسب كل فئة بالتساوي.
- المتوسط المجمّع (Micro averaging): اجمع TP وFP وFN عبر جميع الفئات واحسب درجة F1 واحدة، فتهيمن الفئات الأكثر تكرارًا.
- المتوسط المرجّح (Weighted averaging): متوسط درجات F1 لكل فئة مرجّحًا بعدد الحالات الحقيقية في كل فئة (الدعم).
تفسير درجة F1 الخاصة بك
تتراوح درجة F1 من 0 (لا توجد إيجابيات حقيقية) إلى 1 (لا توجد إيجابيات كاذبة ولا سلبيات كاذبة). وكدليل تقريبي غير رسمي:
- من حوالي 0 إلى 0.5: ضعيف
- من 0.5 إلى 0.7: متوسط
- من 0.7 إلى 0.9: جيد
- أعلى من 0.9: قوي جدًا
هذه النطاقات تعتمد على السياق، ولا يوجد معيار عام موحّد. فقد تكون درجة F1 تبلغ 0.6 ممتازة لمهمة صعبة مثل كشف الأحداث النادرة مع تسميات مشوشة، بينما قد تكون 0.95 غير كافية في بيئة تتطلب السلامة القصوى.
ماذا تعني الفجوة بين الدقة والاستدعاء
- دقة منخفضة مع استدعاء أعلى: يجد النموذج معظم الحالات الإيجابية لكنه يُطلق إنذارات كاذبة كثيرة.
- استدعاء منخفض مع دقة أعلى: توقعات النموذج الإيجابية موثوقة، لكنه يفوّت كثيرًا من الحالات الإيجابية الفعلية.
تحقق من القيمتين معًا بدلًا من الاعتماد على F1 وحدها، لأن درجة F1 نفسها قد تنتج عن توليفات مختلفة جدًا من الدقة والاستدعاء.
قيود ينبغي أخذها في الحسبان
- تتجاهل F1 الحالات السلبية الحقيقية، لذا فهي لا تقول شيئًا عن مدى جودة تعامل النموذج مع الفئة السلبية.
- وهي تعتمد على توازن الفئات. فقد يحصل النموذج نفسه على درجات مختلفة في مجموعات بيانات ذات نسب إيجابية متباينة.
- وهي تعتمد على عتبة القرار. فتغيير العتبة يوازن بين الدقة والاستدعاء ويحرك درجة F1.
- قارن دائمًا بخط أساس، مثل مُتنبئ الفئة الأغلبية أو مُتنبئ الإيجابي دائمًا، أو نموذج بسيط قائم، لتحديد ما إذا كانت الدرجة تحسنًا حقيقيًا.
الأسئلة الشائعة
متى أستخدم F1 بدلًا من الدقة الكلية (Accuracy)؟ يُفضَّل استخدام F1 عندما تكون الفئات غير متوازنة، لأن الدقة الكلية قد تبدو مرتفعة بشكل مُضلِّل عندما تهيمن إحدى الفئات على البيانات.
ما هي درجة F1 الجيدة؟ تتراوح درجة F1 بين 0 و1، وكلما اقتربت من 1 كان ذلك أفضل. أما ما يُعدّ «جيدًا» فيعتمد على طبيعة المهمة، لكن القيم التي تتجاوز 0.8 غالبًا ما تُعتبر قوية.
لماذا هو متوسط توافقي؟ يعاقب المتوسط التوافقي على التفاوت الكبير بين الدقة والاستدعاء أكثر مما يفعل المتوسط الحسابي البسيط، مما يضمن أن تكون كلتا القيمتين مرتفعتين بشكل معقول.