F1スコアとは?
F1スコアは、適合率(Precision)と再現率(Recall)という2つの指標を1つの数値にまとめた評価指標です。機械学習や情報検索、統計の分野で分類モデルの性能を測る際に広く使われています。F1スコアは適合率と再現率の調和平均であるため、どちらか一方だけが優れているモデルよりも、両者をバランスよく両立させたモデルを高く評価するのが特徴です。
このツールの使い方
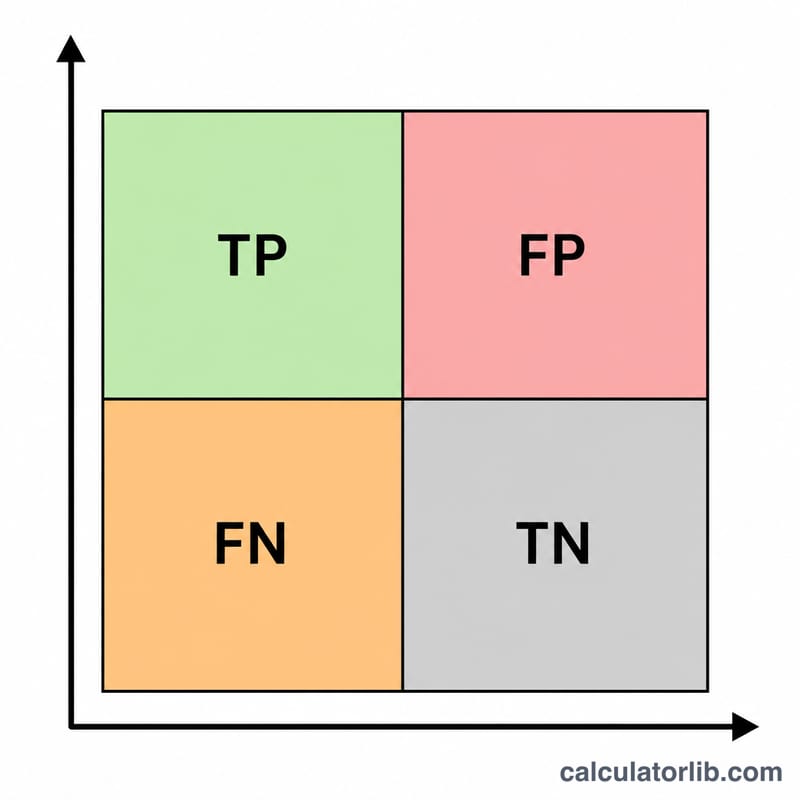
混同行列(Confusion Matrix)から得られる3つの値を入力してください。真陽性(TP:正例を正しく正例と予測した数)、偽陽性(FP:負例を誤って正例と予測した数)、偽陰性(FN:見逃してしまった正例の数)の3つです。値を入力すると、適合率・再現率・F1スコアが即座に表示されます。
計算式の解説
適合率 = TP /(TP + FP)は、「正例と予測したもののうち、実際に正しかった割合」を表します。再現率 = TP /(TP + FN)は、「実際の正例のうち、正しく拾えた割合」を表します。そしてF1スコアは
$$F_1 = \frac{2 \cdot (\text{適合率} \times \text{再現率})}{\text{適合率} + \text{再現率}}$$で求められます。調和平均を用いているため、適合率と再現率のどちらかが低いと、F1スコアも大きく下がる仕組みになっています。
計算例
たとえば \(\text{TP} = 70\)、\(\text{FP} = 30\)、\(\text{FN} = 10\) とします。適合率 = 70 / 100 = 0.70、再現率 = 70 / 80 = 0.875 となります。これを式に当てはめると、
$$F_1 = \frac{2 \times (0.70 \times 0.875)}{0.70 + 0.875} = \frac{2 \times 0.6125}{1.575} \approx 0.7778$$つまり約77.78%になります。
精度と再現率のさまざまな組み合わせにおけるF1スコア
F1は適合率(precision)と再現率(recall)の調和平均です:\(F_1 = \frac{2PR}{P+R}\)。下の表は、いくつかの適合率(P)と再現率(R)の組み合わせについて、単純な算術平均と比較したものです。
| 適合率 | 再現率 | 算術平均 | F1 |
|---|---|---|---|
| 0.90 | 0.90 | 0.900 | 0.900 |
| 0.99 | 0.50 | 0.745 | ≈ 0.664 |
| 0.80 | 0.60 | 0.700 | ≈ 0.686 |
| 1.00 | 0.10 | 0.550 | ≈ 0.182 |
| 0.50 | 0.50 | 0.500 | 0.500 |
たとえば0.80/0.60の行は、TP = 60、FP = 15、FN = 40に対応します:適合率 = 60/75 = 0.80、再現率 = 60/100 = 0.60、そして\(F_1 = \frac{2 \cdot 60}{2 \cdot 60 + 15 + 40} = \frac{120}{175} \approx 0.686\)です。
注:F1は、算術平均よりも常に2つの値のうち小さい方に近い値になります。適合率と再現率が等しい場合、F1はどちらとも同じ値になります。両者の差が大きいほど、F1はより弱い方の値へと引き下げられるため、モデルは再現率の低さを高い適合率で隠すことも、その逆もできません。
混同行列の用語と関連する指標
- 真陽性(TP):陽性のケースを、モデルが正しく陽性と予測したもの。
- 偽陽性(FP):陰性のケースを誤って陽性と予測したもの(誤報、第一種の過誤)。
- 偽陰性(FN):陽性のケースを誤って陰性と予測したもの(見逃し、第二種の過誤)。
- 真陰性(TN):陰性のケースを、モデルが正しく陰性と予測したもの。TNはF1の計算式では使用されません。
- 適合率(陽性的中率):\(\frac{TP}{TP + FP}\)。陽性と予測されたもののうち、実際に陽性である割合。
- 再現率(感度、真陽性率):\(\frac{TP}{TP + FN}\)。実際の陽性のうち、モデルが検出できた割合。
- 正解率(accuracy):\(\frac{TP + TN}{TP + TN + FP + FN}\)。すべての予測のうち正しいものの割合。不均衡なデータでは誤解を招くことがあります。
- 特異度(真陰性率):\(\frac{TN}{TN + FP}\)。実際の陰性のうち、正しく陰性と識別された割合。
- Fベータスコア:\(F_\beta = \frac{(1+\beta^2) PR}{\beta^2 P + R}\)。F1は\(\beta = 1\)の場合にあたります。F2(\(\beta = 2\))は再現率をより重視し、F0.5(\(\beta = 0.5\))は適合率をより重視します。
- マクロ平均:各クラスのF1を計算し、その単純平均をとります。すべてのクラスが同じ重みで扱われます。
- マイクロ平均:すべてのクラスのTP、FP、FNをまとめて、1つのF1を計算します。出現頻度の高いクラスの影響が大きくなります。
- 加重平均:各クラスの真のインスタンス数(サポート)で重み付けしたクラス別F1スコアの平均です。
F1スコアの解釈
F1は0(真陽性がない)から1(偽陽性も偽陰性もない)までの値をとります。大まかな非公式の目安は次のとおりです:
- 約0〜0.5:弱い
- 0.5〜0.7:中程度
- 0.7〜0.9:良好
- 0.9超:非常に強い
これらの区分は文脈に依存し、普遍的な基準は存在しません。ラベルにノイズが多い希少事象の検出のような難しいタスクでは、F1が0.6でも優れている場合があります。一方、安全性が重視される場面では、0.95でも不十分な場合があります。
適合率と再現率の差が意味すること
- 適合率が低く、再現率が高い:モデルは陽性のほとんどを見つけますが、多くの誤報を出します。
- 再現率が低く、適合率が高い:モデルの陽性予測は信頼できますが、実際の陽性を多く見逃します。
F1だけに頼らず両方の値を確認してください。同じF1でも、適合率と再現率の組み合わせは大きく異なる場合があるためです。
留意すべき制約
- F1は真陰性を無視するため、モデルが陰性クラスをどれだけうまく扱えているかはわかりません。
- クラスの偏りに左右されます。陽性の割合が異なるデータセットでは、同じモデルでもスコアが変わることがあります。
- 判定しきい値に依存します。しきい値を変えると適合率と再現率がトレードオフになり、F1も変化します。
- スコアが真の改善であるかを判断するため、常に多数派クラスや常に陽性を予測する手法、既存の単純なモデルなどのベースラインと比較してください。
よくある質問
正解率(Accuracy)ではなくF1スコアを使うべきなのはどんなとき? クラスの偏り(不均衡データ)がある場合はF1スコアが適しています。一方のクラスが大多数を占めると、正解率は実態以上に高く見えてしまうことがあるためです。
F1スコアはどれくらいが「良い」とされる? F1スコアは0から1の範囲をとり、1に近いほど優れています。何を「良い」とするかはタスクによって異なりますが、一般的に0.8を超えると高い性能とみなされることが多いです。
なぜ調和平均を使うの? 調和平均は、適合率と再現率の偏りが大きいときに、単純平均よりも強くペナルティを与えます。これにより、両方ともある程度高くなければ良いスコアが出ない仕組みになっています。