什麼是 F1 分數?
F1 分數是一個將精確率(Precision)與召回率(Recall)整合成單一數值的指標,因此廣泛用於評估機器學習、資訊檢索與統計領域中的分類模型。它是精確率與召回率的調和平均數,所以會偏好兩者兼顧的模型,而不是只在單一面向表現突出的模型。
如何使用本計算器
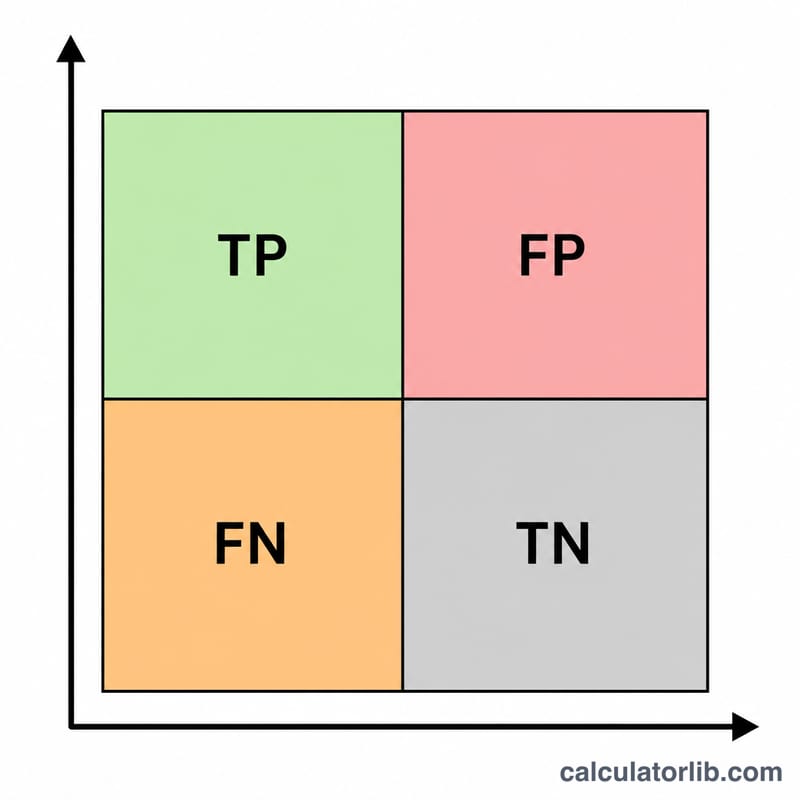
請從你的混淆矩陣(Confusion Matrix)中輸入三個數值:真陽性(TP,正確預測為正類的數量)、偽陽性(FP,本為負類卻被誤判為正類的數量),以及偽陰性(FN,本為正類卻被漏掉的數量)。計算器會立即回傳精確率、召回率與最終的 F1 分數。
公式詳解
精確率 = \(\frac{\text{TP}}{\text{TP} + \text{FP}}\),衡量在所有被預測為正類的樣本中,有多少是真正正確的。召回率 = \(\frac{\text{TP}}{\text{TP} + \text{FN}}\),衡量在所有實際為正類的樣本中,有多少被成功找出。F1 分數則為
$$F_1 = \frac{2 \cdot (\text{精確率} \cdot \text{召回率})}{\text{精確率} + \text{召回率}}$$由於它是調和平均數,只要精確率或召回率任一方偏低,F1 分數就會被大幅拉低。
實例演算
假設 \(\text{TP} = 70\)、\(\text{FP} = 30\)、\(\text{FN} = 10\)。精確率 = \(\frac{70}{100} = 0.70\);召回率 = \(\frac{70}{80} = 0.875\)。
$$F_1 = \frac{2 \cdot (0.70 \cdot 0.875)}{0.70 + 0.875} = \frac{2 \cdot 0.6125}{1.575} \approx 0.7778$$約等於 77.78%。
不同精確率與召回率情境下的 F1 分數
F1 是精確率(precision)與召回率(recall)的調和平均數:\(F_1 = \frac{2PR}{P+R}\)。下表將它與簡單算術平均數進行比較,列出數組不同的精確率(P)與召回率(R)。
| 精確率 | 召回率 | 算術平均數 | F1 |
|---|---|---|---|
| 0.90 | 0.90 | 0.900 | 0.900 |
| 0.99 | 0.50 | 0.745 | ≈ 0.664 |
| 0.80 | 0.60 | 0.700 | ≈ 0.686 |
| 1.00 | 0.10 | 0.550 | ≈ 0.182 |
| 0.50 | 0.50 | 0.500 | 0.500 |
舉例來說,0.80/0.60 這一列對應 TP = 60、FP = 15、FN = 40:精確率 = 60/75 = 0.80,召回率 = 60/100 = 0.60,且 \(F_1 = \frac{2 \cdot 60}{2 \cdot 60 + 15 + 40} = \frac{120}{175} \approx 0.686\)。
注意:F1 總是比算術平均數更接近兩個數值中較低的那一個。當精確率與召回率相等時,F1 與兩者皆相同。兩者差距越大,F1 就越會被拉向較弱的那一個,因此模型無法用極佳的精確率掩蓋糟糕的召回率(反之亦然)。
混淆矩陣術語與相關指標
- 真陽性(TP):正例被模型正確預測為正例。
- 偽陽性(FP):負例被錯誤預測為正例(誤報,第一類型錯誤)。
- 偽陰性(FN):正例被錯誤預測為負例(漏報,第二類型錯誤)。
- 真陰性(TN):負例被正確預測為負例。TN 不用於 F1 公式。
- 精確率(陽性預測值):\(\frac{TP}{TP + FP}\),即被預測為正例的樣本中,確實為正例的比例。
- 召回率(敏感度、真陽性率):\(\frac{TP}{TP + FN}\),即實際正例中,模型找出的比例。
- 準確率:\(\frac{TP + TN}{TP + TN + FP + FN}\),即所有預測中正確的比例。在不平衡資料上可能具有誤導性。
- 特異度(真陰性率):\(\frac{TN}{TN + FP}\),即實際負例中被正確辨識的比例。
- F-beta 分數:\(F_\beta = \frac{(1+\beta^2) PR}{\beta^2 P + R}\)。F1 即 \(\beta = 1\) 的情況。F2(\(\beta = 2\))更重視召回率;F0.5(\(\beta = 0.5\))更重視精確率。
- 巨觀平均(Macro averaging):計算每個類別的 F1,再取未加權平均,因此每個類別權重相同。
- 微觀平均(Micro averaging):將所有類別的 TP、FP 與 FN 合併,計算單一 F1,因此常見類別會佔主導地位。
- 加權平均(Weighted averaging):以每個類別的真實樣本數(支持度)為權重,對各類別的 F1 分數取加權平均。
如何解讀你的 F1 分數
F1 的範圍從 0(沒有真陽性)到 1(沒有偽陽性且沒有偽陰性)。以下是一個粗略、非正式的參考標準:
- 約 0 至 0.5:弱
- 0.5 至 0.7:中等
- 0.7 至 0.9:良好
- 高於 0.9:非常強
這些區間取決於情境,並不存在通用的標準。對於標籤有雜訊的稀有事件偵測等困難任務,0.6 的 F1 可能已屬優秀;但在安全關鍵的場景中,0.95 也可能不足夠。
精確率與召回率之間的差距代表什麼
- 精確率低、召回率較高:模型能找出大部分正例,但會產生許多誤報。
- 召回率低、精確率較高:模型的正例預測可靠,但遺漏了許多實際正例。
請同時檢視兩個數值,而不要只依賴 F1,因為相同的 F1 可能來自截然不同的精確率/召回率組合。
需要留意的限制
- F1 忽略真陰性,因此無法反映模型在負例類別上的表現。
- 它取決於類別平衡。同一個模型在正例比例不同的資料集上,分數可能會不同。
- 它取決於決策閾值。調整閾值會在精確率與召回率之間取捨,並改變 F1。
- 務必與基準進行比較,例如多數類別預測器、永遠預測為正例的預測器,或既有的簡單模型,以判斷分數是否為真正的改進。
常見問題
什麼時候該用 F1 而不是準確率(Accuracy)?當類別分布不平衡時,F1 更為適用;因為當某一類別佔絕大多數時,準確率可能會虛高而具誤導性。
多少的 F1 分數才算好?F1 的範圍是 0 到 1,越接近 1 越好。「好」的標準會因任務而異,但一般而言,數值高於 0.8 通常被視為相當不錯的表現。
為什麼要用調和平均數?相較於簡單的算術平均,調和平均數會對精確率與召回率之間的極端落差施加更重的懲罰,確保兩者都必須維持在合理的水準。