什麼是 z 分數?
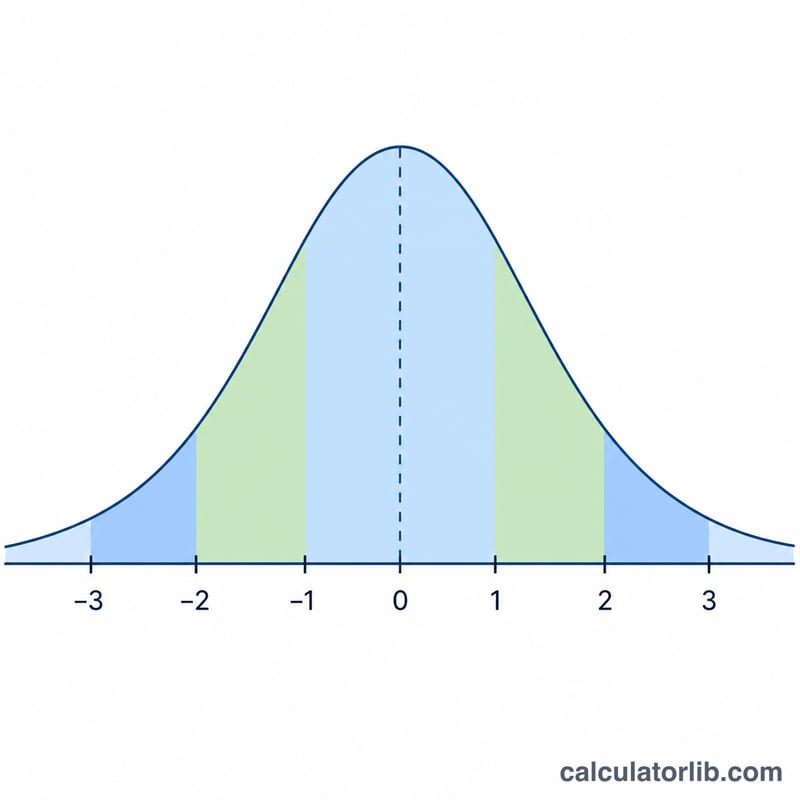
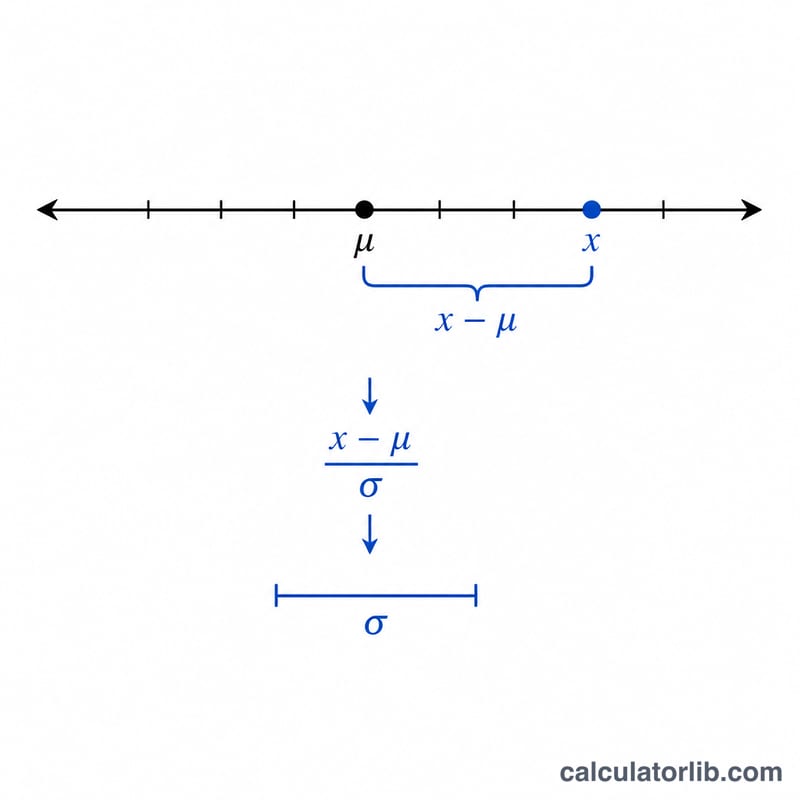
z 分數(又稱標準分數或標準化數值)告訴你某個數值距離母體平均數有幾個母體標準差。z 為正,代表該數值高於平均數;z 為負,代表低於平均數;z = 0 則表示恰好等於平均數。由於 z 分數沒有單位,你可以拿它來比較那些用完全不同尺度測量出來的觀測值。本工具是純統計計算,無論在哪個國家、哪種情境下使用,算法都完全一致。
如何使用這個計算器
先用「計算 z 的方式」選單決定你要標準化的對象:單一或多個數據點、已知的樣本平均數與樣本數,或是讓工具替你自動取平均的整組原始資料。接著輸入母體平均數(mu)與母體標準差(sigma)。輸入清單時可用逗號、空格、Tab 或換行分隔,因此你也能直接把試算表中的一整欄貼上來。
計算公式
對於單一觀測值,公式為 $$z = \dfrac{x - \mu}{\sigma}$$ 若計算的是樣本平均數,則改用平均數的標準誤: $$z = \dfrac{\bar{x} - \mu}{\sigma / \sqrt{n}}$$ 其中 \(\sigma / \sqrt{n}\) 即為標準誤。在「整組資料」模式下,計算器會先求出樣本平均數 \(\bar{x} = \) (所有數值之和)/ n,再套用相同的標準誤公式。
實例演算
假設 \(x = 190\)、\(\mu = 150\)、\(\sigma = 25\),那麼 $$z = \frac{190 - 150}{25} = \frac{40}{25} = 1.6$$ 代表 190 落在平均數之上 1.6 個標準差的位置。再看一個樣本平均數的例子:\(\bar{x} = 280\)、\(\mu = 300\)、\(\sigma = 50\)、\(n = 25\),標準誤為 \(50 / \sqrt{25} = 10\),因此 $$z = \frac{280 - 300}{10} = -2.0$$
Z 分數轉百分位查詢表
此表列出標準常態累積機率 \(P(Z \le z)\),即常態分布中位於 z 或低於 z 的比例。乘以 100 即可得到近似百分位。
| z | P(Z ≤ z) | 近似百分位 |
|---|---|---|
| -3 | 0.0013 | 0.13% |
| -2.576 | 0.0050 | 0.5% |
| -2.5 | 0.0062 | 0.62% |
| -2 | 0.0228 | 2.28% |
| -1.96 | 0.0250 | 2.5% |
| -1.645 | 0.0500 | 5% |
| -1 | 0.1587 | 15.87% |
| -0.5 | 0.3085 | 30.85% |
| 0 | 0.5000 | 50% |
| 0.5 | 0.6915 | 69.15% |
| 1 | 0.8413 | 84.13% |
| 1.5 | 0.9332 | 93.32% |
| 1.6 | 0.9452 | 94.52% |
| 1.645 | 0.9500 | 95% |
| 1.96 | 0.9750 | 97.5% |
| 2 | 0.9772 | 97.72% |
| 2.5 | 0.9938 | 99.38% |
| 2.576 | 0.9950 | 99.5% |
| 3 | 0.9987 | 99.87% |
對稱性:標準常態曲線以 0 為對稱軸,因此 \(P(Z \le -z) = 1 - P(Z \le z)\)。例如,\(P(Z \le -1) = 1 - 0.8413 = 0.1587\)。
範例:某分數為 85,平均數為 70,標準差為 10,則 \(z = \frac{85 - 70}{10} = \) 1.5。由表中可知 \(P(Z \le 1.5) = 0.9332\),因此假設分數大致呈常態分布,該分數約位於第 93 百分位。
常見問題
可以一次輸入多個數據點嗎?可以。在「數據點」模式下,用逗號或空格分隔多個數字,系統會分別算出每個數字的 z 分數。
為什麼 sigma 必須大於零?z 公式要除以 sigma(或標準誤 \(\sigma/\sqrt{n}\))。若標準差為零就會變成除以零,因此計算器會回報錯誤。
如何把 z 分數換算成百分位數?查標準常態分配表,或使用累積常態函數即可。舉例來說,\(z = 1.6\) 大約對應到第 94.52 個百分位。