z-स्कोर क्या होता है?
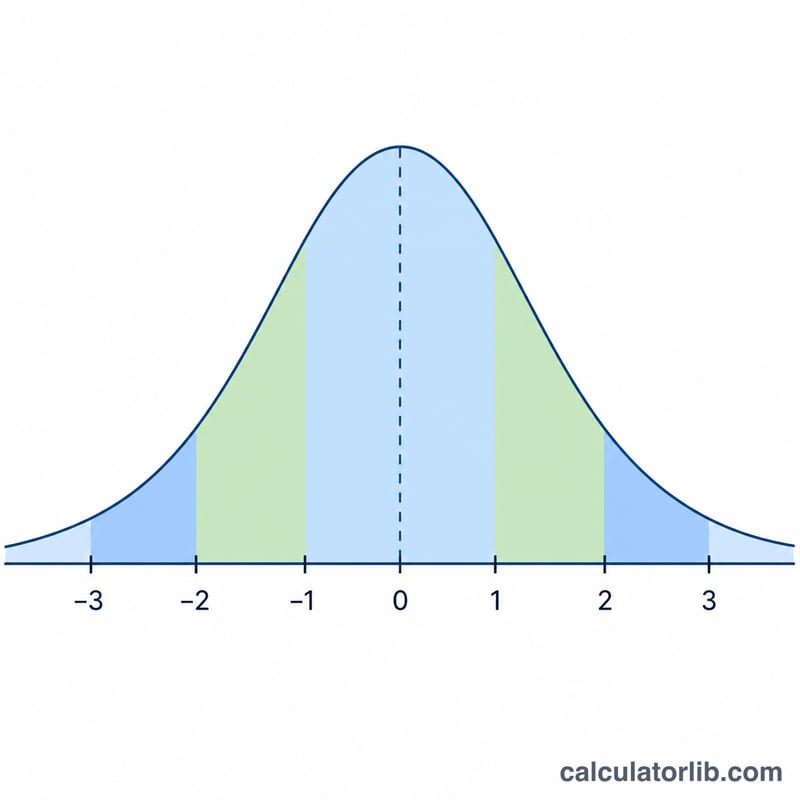
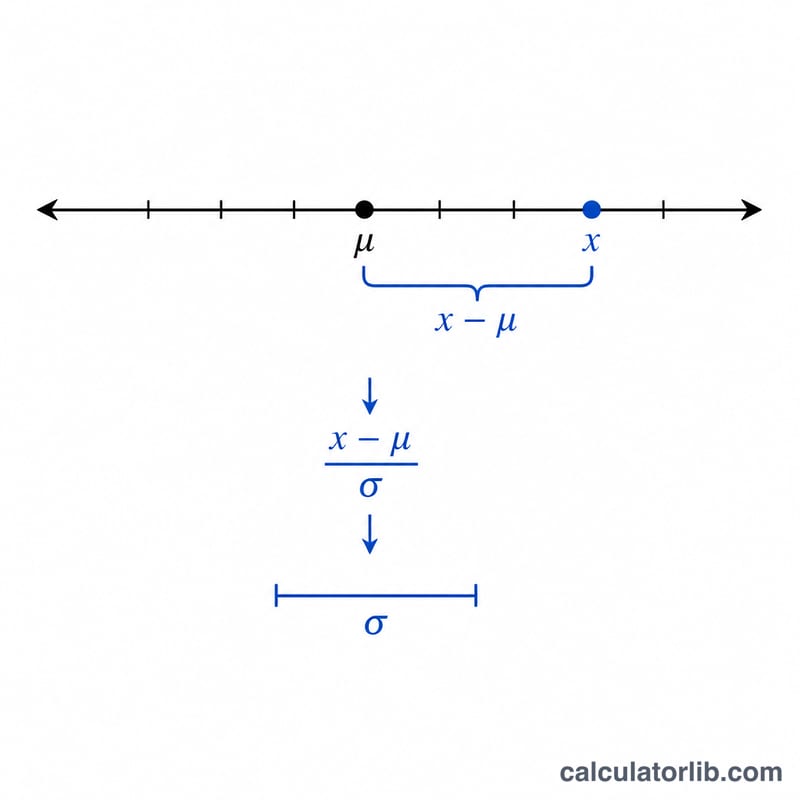
z-स्कोर (जिसे मानक स्कोर या मानकीकृत मान भी कहते हैं) यह बताता है कि कोई मान जनसंख्या माध्य से कितने मानक विचलन (standard deviations) दूर है। धनात्मक z का मतलब है कि मान माध्य से ऊपर है, ऋणात्मक z का मतलब है कि वह माध्य से नीचे है, और \(z = 0\) का मतलब है कि वह ठीक माध्य पर ही है। चूँकि z-स्कोर का कोई मात्रक (unit) नहीं होता, इसलिए इनकी मदद से आप बिल्कुल अलग-अलग पैमानों पर मापे गए प्रेक्षणों की आपस में तुलना कर सकते हैं। यह कैलकुलेटर एक शुद्ध सांख्यिकी उपकरण है और दुनिया में कहीं भी एक जैसे ही काम करता है।
इस कैलकुलेटर का उपयोग कैसे करें
"z की गणना इसके आधार पर करें" विकल्प से चुनें कि आप किसका मानकीकरण करना चाहते हैं: एक अकेला डेटा बिंदु या कई बिंदु, एक ज्ञात नमूना माध्य उसके आकार के साथ, या एक कच्चा डेटा नमूना जिसका औसत यह उपकरण खुद निकाल देगा। इसके बाद जनसंख्या माध्य (mu) और जनसंख्या मानक विचलन (sigma) दर्ज करें। सूचियों को कॉमा, स्पेस, टैब या नई लाइन से अलग किया जा सकता है, इसलिए आप किसी स्प्रेडशीट का पूरा कॉलम सीधे पेस्ट कर सकते हैं।
सूत्र
किसी एक प्रेक्षण के लिए सूत्र है
$$z = \frac{x - \mu}{\sigma}$$नमूना माध्य के लिए सूत्र में माध्य की मानक त्रुटि (standard error) का उपयोग होता है:
$$z = \frac{\bar{x} - \mu}{\sigma / \sqrt{n}}$$जहाँ \(\sigma / \sqrt{n}\) मानक त्रुटि है। "डेटा नमूना" मोड में कैलकुलेटर पहले नमूना माध्य \(\bar{x} = (\text{मानों का योग}) / n\) निकालता है, फिर वही मानक-त्रुटि वाला सूत्र लागू करता है।
हल किया हुआ उदाहरण
मान लीजिए \(x = 190\), \(\mu = 150\) और \(\sigma = 25\)। तब
$$z = \frac{190 - 150}{25} = \frac{40}{25} = 1.6$$यानी 190 माध्य से 1.6 मानक विचलन ऊपर है। नमूना माध्य के एक उदाहरण में मान लीजिए \(\bar{x} = 280\), \(\mu = 300\), \(\sigma = 50\) और \(n = 25\); तब मानक त्रुटि \(50 / \sqrt{25} = 10\) होगी, इसलिए
$$z = \frac{280 - 300}{10} = -2.0$$Z-स्कोर से प्रतिशतक तालिका
यह तालिका मानक सामान्य संचयी प्रायिकता \(P(Z \le z)\) दिखाती है, जो सामान्य वितरण का वह हिस्सा है जो z पर या उससे नीचे स्थित है। अनुमानित प्रतिशतक पाने के लिए इसे 100 से गुणा करें।
| z | P(Z ≤ z) | अनुमानित प्रतिशतक |
|---|---|---|
| -3 | 0.0013 | 0.13% |
| -2.576 | 0.0050 | 0.5% |
| -2.5 | 0.0062 | 0.62% |
| -2 | 0.0228 | 2.28% |
| -1.96 | 0.0250 | 2.5% |
| -1.645 | 0.0500 | 5% |
| -1 | 0.1587 | 15.87% |
| -0.5 | 0.3085 | 30.85% |
| 0 | 0.5000 | 50% |
| 0.5 | 0.6915 | 69.15% |
| 1 | 0.8413 | 84.13% |
| 1.5 | 0.9332 | 93.32% |
| 1.6 | 0.9452 | 94.52% |
| 1.645 | 0.9500 | 95% |
| 1.96 | 0.9750 | 97.5% |
| 2 | 0.9772 | 97.72% |
| 2.5 | 0.9938 | 99.38% |
| 2.576 | 0.9950 | 99.5% |
| 3 | 0.9987 | 99.87% |
समरूपता: मानक सामान्य वक्र 0 के बारे में सममित है, इसलिए \(P(Z \le -z) = 1 - P(Z \le z)\)। उदाहरण के लिए, \(P(Z \le -1) = 1 - 0.8413 = 0.1587\)।
उदाहरण: एक स्कोर 85 है जहाँ माध्य 70 और मानक विचलन 10 है, तो \(z = \frac{85 - 70}{10} = \) 1.5। तालिका से, \(P(Z \le 1.5) = 0.9332\), इसलिए यह स्कोर लगभग 93वें प्रतिशतक पर है, यह मानते हुए कि स्कोर लगभग सामान्य हैं।
अक्सर पूछे जाने वाले सवाल
क्या मैं एक साथ कई डेटा बिंदु दर्ज कर सकता हूँ? हाँ। "डेटा बिंदु" मोड में कॉमा या स्पेस से अलग करके कई संख्याएँ दर्ज करें और आपको हर एक के लिए अलग z-स्कोर मिल जाएगा।
sigma का शून्य से बड़ा होना ज़रूरी क्यों है? z सूत्र में sigma (या मानक त्रुटि \(\sigma/\sqrt{n}\)) से भाग दिया जाता है। मानक विचलन शून्य होने पर शून्य से भाग देना पड़ेगा, इसलिए कैलकुलेटर एक त्रुटि दिखाता है।
z-स्कोर को पर्सेंटाइल में कैसे बदलें? z मान को मानक-सामान्य (standard normal) तालिका में देखें या किसी संचयी सामान्य (cumulative normal) फलन का उपयोग करें। उदाहरण के लिए, \(z = 1.6\) लगभग 94.52वें पर्सेंटाइल के बराबर होता है।