F1 स्कोर क्या होता है?
F1 स्कोर एक ऐसा मेट्रिक है जो प्रिसिजन और रिकॉल दोनों को मिलाकर एक ही संख्या में पेश करता है। यही वजह है कि मशीन लर्निंग, इन्फॉर्मेशन रिट्रीवल और सांख्यिकी में क्लासिफिकेशन मॉडल का मूल्यांकन करने के लिए यह बहुत लोकप्रिय है। यह प्रिसिजन और रिकॉल का हार्मोनिक मीन (समान्तर माध्य नहीं) होता है, इसलिए यह उन मॉडलों को बेहतर आँकता है जो दोनों के बीच संतुलन बनाए रखते हैं, बजाय इसके कि केवल किसी एक में अच्छे हों।
इस कैलकुलेटर का उपयोग कैसे करें
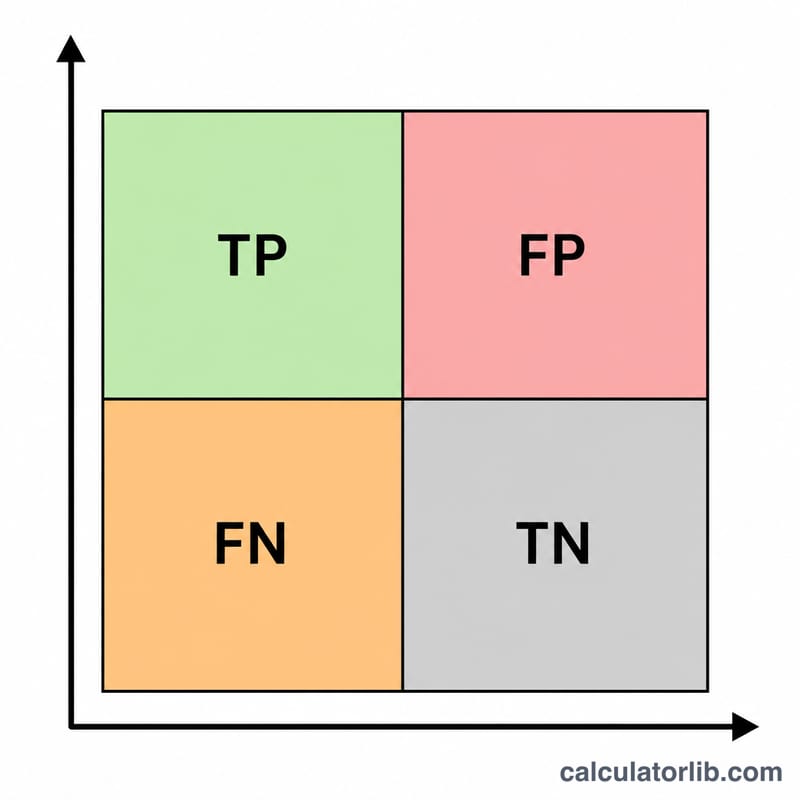
अपने कन्फ्यूज़न मैट्रिक्स से तीन गिनतियाँ दर्ज करें: True Positives (TP, यानी सही तरीके से पहचाने गए पॉज़िटिव), False Positives (FP, यानी वे नेगेटिव जिन्हें गलती से पॉज़िटिव बताया गया), और False Negatives (FN, यानी वे पॉज़िटिव जो छूट गए)। कैलकुलेटर तुरंत प्रिसिजन, रिकॉल और परिणामस्वरूप F1 स्कोर दिखा देगा।
फॉर्मूला आसान भाषा में
प्रिसिजन = \(\text{TP} / (\text{TP} + \text{FP})\) यह बताता है कि जितने पॉज़िटिव की भविष्यवाणी की गई थी, उनमें से कितने सही थे। रिकॉल = \(\text{TP} / (\text{TP} + \text{FN})\) यह बताता है कि असली पॉज़िटिव में से कितने पकड़े गए। इसके बाद F1 स्कोर निकलता है:
$$F_1 = 2 \cdot \frac{\text{प्रिसिजन} \cdot \text{रिकॉल}}{\text{प्रिसिजन} + \text{रिकॉल}}$$चूँकि यह हार्मोनिक मीन है, इसलिए अगर प्रिसिजन या रिकॉल में से कोई एक भी कम हो, तो F1 स्कोर तेज़ी से नीचे गिर जाता है।
हल किया हुआ उदाहरण
मान लीजिए \(\text{TP} = 70\), \(\text{FP} = 30\), \(\text{FN} = 10\)। तब प्रिसिजन = \(70 / 100 = 0.70\)। रिकॉल = \(70 / 80 = 0.875\)।
$$F_1 = 2 \cdot \frac{0.70 \cdot 0.875}{0.70 + 0.875} = 2 \cdot \frac{0.6125}{1.575} \approx 0.7778$$यानी लगभग 77.78%।
विभिन्न सटीकता और रिकॉल परिदृश्यों में F1 स्कोर
F1 सटीकता (precision) और रिकॉल (recall) का हार्मोनिक माध्य है: \(F_1 = \frac{2PR}{P+R}\). तालिका कई सटीकता (P) और रिकॉल (R) जोड़ियों के लिए इसकी तुलना साधारण अंकगणितीय माध्य से करती है।
| सटीकता | रिकॉल | अंकगणितीय माध्य | F1 |
|---|---|---|---|
| 0.90 | 0.90 | 0.900 | 0.900 |
| 0.99 | 0.50 | 0.745 | ≈ 0.664 |
| 0.80 | 0.60 | 0.700 | ≈ 0.686 |
| 1.00 | 0.10 | 0.550 | ≈ 0.182 |
| 0.50 | 0.50 | 0.500 | 0.500 |
0.80/0.60 वाली पंक्ति उदाहरण के लिए TP = 60, FP = 15, FN = 40 से मेल खाती है: सटीकता = 60/75 = 0.80, रिकॉल = 60/100 = 0.60, और \(F_1 = \frac{2 \cdot 60}{2 \cdot 60 + 15 + 40} = \frac{120}{175} \approx 0.686\).
नोट: F1 हमेशा अंकगणितीय माध्य की तुलना में दोनों मानों में से छोटे मान के अधिक करीब होता है। जब सटीकता और रिकॉल बराबर होते हैं, तब F1 दोनों के बराबर होता है। दोनों में जितना अधिक अंतर होगा, F1 उतना ही कमज़ोर मान की ओर खिंचेगा, इसलिए कोई मॉडल उत्कृष्ट सटीकता के पीछे खराब रिकॉल (या इसके उलट) नहीं छिपा सकता।
कन्फ्यूजन मैट्रिक्स के शब्द और संबंधित मेट्रिक्स
- ट्रू पॉज़िटिव (TP): एक पॉज़िटिव मामला जिसे मॉडल ने सही तरह से पॉज़िटिव अनुमानित किया।
- फ़ॉल्स पॉज़िटिव (FP): एक नेगेटिव मामला जिसे गलती से पॉज़िटिव अनुमानित किया गया (झूठा अलार्म, टाइप I त्रुटि)।
- फ़ॉल्स नेगेटिव (FN): एक पॉज़िटिव मामला जिसे गलती से नेगेटिव अनुमानित किया गया (चूक, टाइप II त्रुटि)।
- ट्रू नेगेटिव (TN): एक नेगेटिव मामला जिसे सही तरह से नेगेटिव अनुमानित किया गया। TN का उपयोग F1 सूत्र में नहीं होता।
- सटीकता (Precision, पॉज़िटिव प्रेडिक्टिव वैल्यू): \(\frac{TP}{TP + FP}\), अनुमानित पॉज़िटिव में से वास्तव में पॉज़िटिव होने वाला हिस्सा।
- रिकॉल (Recall, संवेदनशीलता, ट्रू पॉज़िटिव दर): \(\frac{TP}{TP + FN}\), वास्तविक पॉज़िटिव में से मॉडल द्वारा पाए गए मामलों का हिस्सा।
- एक्यूरेसी (Accuracy): \(\frac{TP + TN}{TP + TN + FP + FN}\), सभी अनुमानों में से सही अनुमानों का हिस्सा। असंतुलित डेटा पर यह भ्रामक हो सकता है।
- स्पेसिफ़िसिटी (Specificity, ट्रू नेगेटिव दर): \(\frac{TN}{TN + FP}\), वास्तविक नेगेटिव में से सही पहचाने गए मामलों का हिस्सा।
- F-बीटा स्कोर: \(F_\beta = \frac{(1+\beta^2) PR}{\beta^2 P + R}\). F1 मामला \(\beta = 1\) का है। F2 (\(\beta = 2\)) रिकॉल को अधिक भार देता है; F0.5 (\(\beta = 0.5\)) सटीकता को अधिक भार देता है।
- मैक्रो औसत (Macro averaging): हर वर्ग के लिए F1 की गणना करें और उनका असंभारित माध्य लें, ताकि हर वर्ग बराबर गिना जाए।
- माइक्रो औसत (Micro averaging): सभी वर्गों के TP, FP और FN को जोड़कर एक F1 की गणना करें, जिससे बार-बार आने वाले वर्ग हावी हो जाते हैं।
- भारित औसत (Weighted averaging): हर वर्ग के वास्तविक उदाहरणों की संख्या (सपोर्ट) के भार से प्रति-वर्ग F1 स्कोर का माध्य लें।
अपने F1 स्कोर की व्याख्या
F1 का मान 0 (कोई ट्रू पॉज़िटिव नहीं) से 1 (कोई फ़ॉल्स पॉज़िटिव और कोई फ़ॉल्स नेगेटिव नहीं) तक होता है। एक मोटे, अनौपचारिक मार्गदर्शन के रूप में:
- लगभग 0 से 0.5: कमज़ोर
- 0.5 से 0.7: मध्यम
- 0.7 से 0.9: अच्छा
- 0.9 से ऊपर: बहुत मज़बूत
ये सीमाएँ संदर्भ-आधारित हैं और कोई सार्वभौमिक मानक मौजूद नहीं है। शोर वाले लेबल के साथ दुर्लभ-घटना पहचान जैसे कठिन कार्य के लिए 0.6 का F1 उत्कृष्ट हो सकता है, जबकि सुरक्षा-संवेदी स्थिति में 0.95 भी अपर्याप्त हो सकता है।
सटीकता और रिकॉल के बीच अंतर का अर्थ
- कम सटीकता, अधिक रिकॉल: मॉडल अधिकांश पॉज़िटिव ढूँढता है, पर कई झूठे अलार्म उठाता है।
- कम रिकॉल, अधिक सटीकता: मॉडल के पॉज़िटिव अनुमान भरोसेमंद हैं, पर वह कई वास्तविक पॉज़िटिव चूक जाता है।
केवल F1 पर भरोसा करने के बजाय दोनों मानों की जाँच करें, क्योंकि एक ही F1 बहुत अलग सटीकता/रिकॉल संयोजनों से आ सकता है।
ध्यान रखने योग्य सीमाएँ
- F1 ट्रू नेगेटिव को नज़रअंदाज़ करता है, इसलिए यह नहीं बताता कि मॉडल नेगेटिव वर्ग को कितनी अच्छी तरह संभालता है।
- यह वर्ग संतुलन पर निर्भर करता है। अलग-अलग पॉज़िटिव दर वाले डेटासेट पर वही मॉडल अलग स्कोर कर सकता है।
- यह निर्णय सीमा (threshold) पर निर्भर करता है। सीमा बदलने से सटीकता और रिकॉल के बीच व्यापार होता है और F1 बदल जाता है।
- यह जाँचने के लिए कि स्कोर वास्तविक सुधार है या नहीं, हमेशा किसी आधार-रेखा (baseline) से तुलना करें, जैसे बहुसंख्यक-वर्ग या हमेशा-पॉज़िटिव अनुमानक, या कोई सरल मौजूदा मॉडल।
अक्सर पूछे जाने वाले सवाल
एक्यूरेसी की जगह F1 का इस्तेमाल कब करना चाहिए? जब क्लासेस असंतुलित (imbalanced) हों, तब F1 बेहतर रहता है, क्योंकि ऐसे में एक्यूरेसी भ्रामक रूप से ज़्यादा दिख सकती है जब कोई एक क्लास हावी हो।
अच्छा F1 स्कोर कितना होता है? F1 की रेंज 0 से 1 तक होती है; 1 के जितना करीब, उतना बेहतर। "अच्छा" क्या है यह काम पर निर्भर करता है, लेकिन आमतौर पर 0.8 से ऊपर के मान को मज़बूत माना जाता है।
यह हार्मोनिक मीन ही क्यों है? हार्मोनिक मीन, प्रिसिजन और रिकॉल के बीच के अत्यधिक असंतुलन पर साधारण औसत के मुकाबले कहीं ज़्यादा सख़्ती बरतता है, जिससे यह तय होता है कि दोनों ही उचित रूप से ऊँचे हों।