Qu'est-ce que le score F1 ?
Le score F1 est une métrique unique qui combine la précision et le rappel en un seul chiffre. C'est l'une des façons les plus répandues d'évaluer les modèles de classification en apprentissage automatique, en recherche d'information et en statistique. Il correspond à la moyenne harmonique de la précision et du rappel : il récompense donc les classificateurs qui équilibrent les deux plutôt que ceux qui n'excellent que sur un seul critère.
Comment utiliser ce calculateur
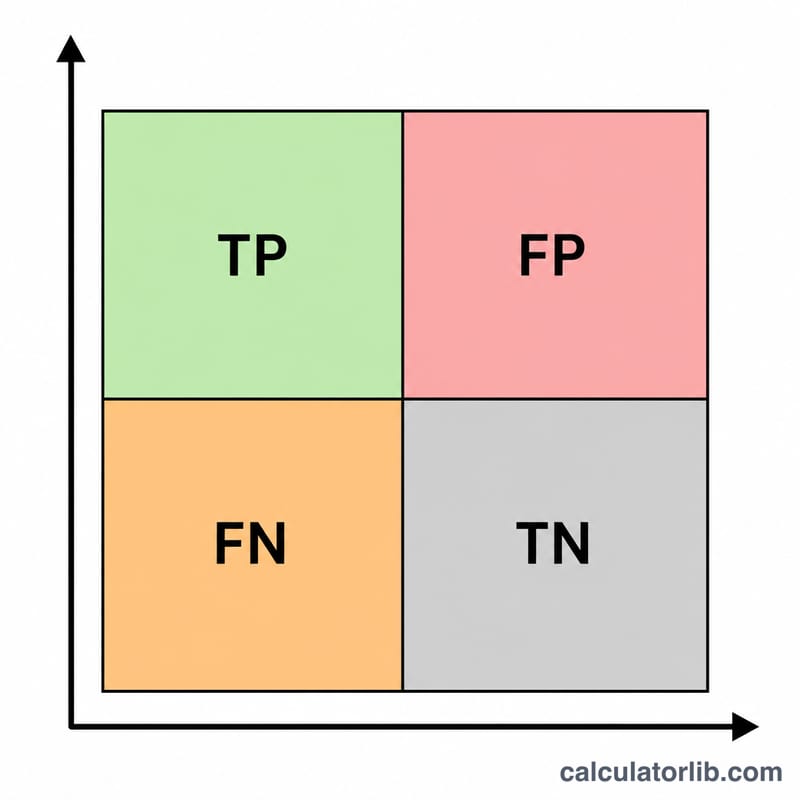
Saisissez les trois effectifs issus de votre matrice de confusion : les vrais positifs (VP, les cas positifs correctement prédits), les faux positifs (FP, les cas négatifs prédits à tort comme positifs) et les faux négatifs (FN, les cas positifs qui ont été manqués). Le calculateur affiche aussitôt la précision, le rappel et le score F1 correspondant.
La formule expliquée
La précision = \( \frac{\text{VP}}{\text{VP} + \text{FP}} \) mesure la part de prédictions positives qui étaient correctes. Le rappel = \( \frac{\text{VP}}{\text{VP} + \text{FN}} \) mesure la part des cas réellement positifs qui ont été détectés. Le score F1 vaut alors
$$ F_1 = \frac{2 \cdot (\text{précision} \cdot \text{rappel})}{\text{précision} + \text{rappel}} $$Comme il s'agit d'une moyenne harmonique, une valeur faible de la précision ou du rappel fait chuter fortement le score F1.
Exemple concret
Supposons \( \text{VP} = 70 \), \( \text{FP} = 30 \), \( \text{FN} = 10 \). La précision = \( \frac{70}{100} = 0{,}70 \). Le rappel = \( \frac{70}{80} = 0{,}875 \). Le F1 =
$$ F_1 = \frac{2 \cdot (0{,}70 \cdot 0{,}875)}{0{,}70 + 0{,}875} = \frac{2 \cdot 0{,}6125}{1{,}575} \approx 0{,}7778 $$soit environ 77,78 %.
Score F1 selon différents scénarios de précision et de rappel
Le F1 est la moyenne harmonique de la précision et du rappel : \(F_1 = \frac{2PR}{P+R}\). Le tableau le compare à la moyenne arithmétique simple pour plusieurs couples de précision (P) et de rappel (R).
| Précision | Rappel | Moyenne arithmétique | F1 |
|---|---|---|---|
| 0.90 | 0.90 | 0.900 | 0.900 |
| 0.99 | 0.50 | 0.745 | ≈ 0.664 |
| 0.80 | 0.60 | 0.700 | ≈ 0.686 |
| 1.00 | 0.10 | 0.550 | ≈ 0.182 |
| 0.50 | 0.50 | 0.500 | 0.500 |
La ligne 0.80/0.60 correspond, par exemple, à VP = 60, FP = 15, FN = 40 : précision = 60/75 = 0.80, rappel = 60/100 = 0.60, et \(F_1 = \frac{2 \cdot 60}{2 \cdot 60 + 15 + 40} = \frac{120}{175} \approx 0.686\).
Remarque : le F1 se situe toujours plus près de la plus faible des deux valeurs que ne le fait la moyenne arithmétique. Lorsque la précision et le rappel sont égaux, le F1 est égal aux deux. Plus ils diffèrent, plus le F1 est tiré vers la valeur la plus faible, de sorte qu'un modèle ne peut pas masquer un mauvais rappel derrière une excellente précision (ou l'inverse).
Termes de la matrice de confusion et métriques associées
- Vrai positif (VP) : un cas positif que le modèle a correctement prédit comme positif.
- Faux positif (FP) : un cas négatif prédit à tort comme positif (une fausse alarme, erreur de type I).
- Faux négatif (FN) : un cas positif prédit à tort comme négatif (un raté, erreur de type II).
- Vrai négatif (VN) : un cas négatif correctement prédit comme négatif. Le VN n'est pas utilisé dans la formule du F1.
- Précision (valeur prédictive positive) : \(\frac{VP}{VP + FP}\), la part des prédictions positives qui sont réellement positives.
- Rappel (sensibilité, taux de vrais positifs) : \(\frac{VP}{VP + FN}\), la part des positifs réels que le modèle détecte.
- Exactitude : \(\frac{VP + VN}{VP + VN + FP + FN}\), la part de toutes les prédictions qui sont correctes. Elle peut être trompeuse sur des données déséquilibrées.
- Spécificité (taux de vrais négatifs) : \(\frac{VN}{VN + FP}\), la part des négatifs réels correctement identifiés.
- Score F-bêta : \(F_\beta = \frac{(1+\beta^2) PR}{\beta^2 P + R}\). Le F1 correspond au cas \(\beta = 1\). Le F2 (\(\beta = 2\)) accorde plus de poids au rappel ; le F0.5 (\(\beta = 0.5\)) accorde plus de poids à la précision.
- Moyenne macro : calculer le F1 pour chaque classe et prendre la moyenne non pondérée, de sorte que chaque classe compte de la même façon.
- Moyenne micro : regrouper les VP, FP et FN de toutes les classes et calculer un seul F1, de sorte que les classes fréquentes dominent.
- Moyenne pondérée : calculer la moyenne des scores F1 par classe, pondérés par le nombre d'instances réelles de chaque classe (support).
Interpréter votre score F1
Le F1 varie de 0 (aucun vrai positif) à 1 (aucun faux positif et aucun faux négatif). À titre de repère approximatif et informel :
- Environ 0 à 0.5 : faible
- 0.5 à 0.7 : modéré
- 0.7 à 0.9 : bon
- Au-dessus de 0.9 : très solide
Ces seuils dépendent du contexte, et il n'existe aucune norme universelle. Un F1 de 0.6 peut être excellent pour une tâche difficile, comme la détection d'événements rares avec des étiquettes bruitées, tandis qu'un F1 de 0.95 peut être insuffisant dans un contexte critique pour la sécurité.
Ce que signifie un écart entre précision et rappel
- Précision faible, rappel plus élevé : le modèle trouve la plupart des positifs, mais déclenche de nombreuses fausses alarmes.
- Rappel faible, précision plus élevée : les prédictions positives du modèle sont fiables, mais il manque de nombreux positifs réels.
Vérifiez les deux valeurs plutôt que de vous fier au seul F1, car un même F1 peut résulter de combinaisons très différentes de précision et de rappel.
Limites à garder à l'esprit
- Le F1 ignore les vrais négatifs : il ne dit donc rien de la manière dont le modèle traite la classe négative.
- Il dépend de l'équilibre des classes. Un même modèle peut obtenir des scores différents sur des jeux de données présentant des taux de positifs différents.
- Il dépend du seuil de décision. Modifier le seuil fait un compromis entre précision et rappel et fait varier le F1.
- Comparez toujours à une référence, comme un prédicteur de la classe majoritaire ou qui prédit toujours positif, ou à un modèle simple existant, afin de juger si le score représente une réelle amélioration.
FAQ
Quand vaut-il mieux utiliser le F1 plutôt que l'exactitude (accuracy) ? Le F1 est préférable lorsque les classes sont déséquilibrées, car l'exactitude peut être trompeusement élevée quand une classe domine largement.
Qu'est-ce qu'un bon score F1 ? Le F1 varie de 0 à 1 ; plus il s'approche de 1, mieux c'est. Ce que l'on considère comme « bon » dépend de la tâche, mais les valeurs supérieures à 0,8 sont souvent jugées solides.
Pourquoi une moyenne harmonique ? La moyenne harmonique pénalise plus fortement un déséquilibre marqué entre précision et rappel qu'une simple moyenne arithmétique : elle impose que les deux soient raisonnablement élevés.