Что такое F1-мера?
F1-мера — это единый показатель, который объединяет точность (precision) и полноту (recall) в одно число. Именно поэтому её так часто используют для оценки моделей классификации в машинном обучении, информационном поиске и статистике. F1-мера представляет собой гармоническое среднее точности и полноты, поэтому она вознаграждает те модели, которые держат баланс между этими метриками, а не «вытягивают» лишь одну из них.
Как пользоваться калькулятором
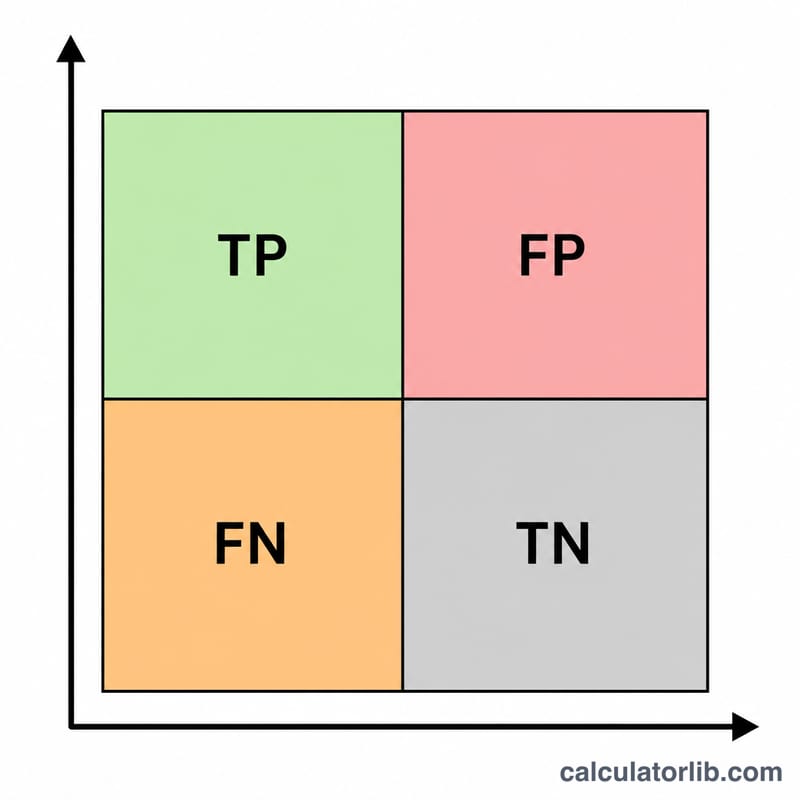
Введите три значения из матрицы ошибок (confusion matrix): True Positives (TP — верно предсказанные положительные примеры), False Positives (FP — отрицательные примеры, ошибочно отнесённые к положительным) и False Negatives (FN — пропущенные положительные примеры). Калькулятор мгновенно рассчитает точность, полноту и итоговую F1-меру.
Разбор формулы
Точность = \( \frac{\text{TP}}{\text{TP} + \text{FP}} \) показывает, какая доля предсказанных положительных примеров оказалась верной. Полнота = \( \frac{\text{TP}}{\text{TP} + \text{FN}} \) показывает, какую долю реальных положительных примеров удалось найти. F1-мера вычисляется по формуле $$ F_1 = \frac{2 \cdot (\text{точность} \cdot \text{полнота})}{\text{точность} + \text{полнота}} $$ Поскольку это гармоническое среднее, низкое значение хотя бы одной из метрик резко тянет F1-меру вниз.
Пример расчёта
Допустим, \( \text{TP} = 70 \), \( \text{FP} = 30 \), \( \text{FN} = 10 \). Тогда точность = \( \frac{70}{100} = 0{,}70 \). Полнота = \( \frac{70}{80} = 0{,}875 \).
$$ F_1 = \frac{2 \cdot (0{,}70 \cdot 0{,}875)}{0{,}70 + 0{,}875} = \frac{2 \cdot 0{,}6125}{1{,}575} \approx 0{,}7778 $$то есть примерно 77,78 %.
Частые вопросы
Когда использовать F1 вместо точности классификации (accuracy)? F1-мера предпочтительнее при несбалансированных классах: метрика accuracy может оказаться обманчиво высокой, когда один класс заметно преобладает над другим.
Какое значение F1 считается хорошим? F1-мера принимает значения от 0 до 1; чем ближе к 1, тем лучше. То, что считать «хорошим» результатом, зависит от задачи, но значения выше 0,8 обычно расцениваются как сильные.
Почему используется именно гармоническое среднее? Гармоническое среднее сильнее наказывает резкий дисбаланс между точностью и полнотой, чем обычное среднее арифметическое. Так гарантируется, что обе метрики должны быть достаточно высокими.
Оценка F1 при разных сочетаниях точности и полноты
F1 — это гармоническое среднее точности и полноты: \(F_1 = \frac{2PR}{P+R}\). В таблице он сравнивается с простым арифметическим средним для нескольких пар точности (P) и полноты (R).
| Точность | Полнота | Арифметическое среднее | F1 |
|---|---|---|---|
| 0.90 | 0.90 | 0.900 | 0.900 |
| 0.99 | 0.50 | 0.745 | ≈ 0.664 |
| 0.80 | 0.60 | 0.700 | ≈ 0.686 |
| 1.00 | 0.10 | 0.550 | ≈ 0.182 |
| 0.50 | 0.50 | 0.500 | 0.500 |
Строка 0.80/0.60, например, соответствует TP = 60, FP = 15, FN = 40: точность = 60/75 = 0.80, полнота = 60/100 = 0.60, а \(F_1 = \frac{2 \cdot 60}{2 \cdot 60 + 15 + 40} = \frac{120}{175} \approx 0.686\).
Примечание: F1 всегда ближе к меньшему из двух значений, чем арифметическое среднее. Когда точность и полнота равны, F1 равен им обоим. Чем сильнее они различаются, тем сильнее F1 смещается к более слабому показателю, поэтому модель не может скрыть низкую полноту за высокой точностью (или наоборот).
Термины матрицы ошибок и связанные метрики
- Истинно положительный результат (TP): положительный случай, который модель правильно предсказала как положительный.
- Ложно положительный результат (FP): отрицательный случай, ошибочно предсказанный как положительный (ложная тревога, ошибка I рода).
- Ложно отрицательный результат (FN): положительный случай, ошибочно предсказанный как отрицательный (пропуск, ошибка II рода).
- Истинно отрицательный результат (TN): отрицательный случай, правильно предсказанный как отрицательный. TN не используется в формуле F1.
- Точность (precision, положительная прогностическая ценность): \(\frac{TP}{TP + FP}\), доля предсказанных положительных случаев, которые действительно являются положительными.
- Полнота (recall, чувствительность, доля истинно положительных): \(\frac{TP}{TP + FN}\), доля реальных положительных случаев, которую находит модель.
- Accuracy (доля верных ответов): \(\frac{TP + TN}{TP + TN + FP + FN}\), доля всех верных предсказаний. На несбалансированных данных может вводить в заблуждение.
- Специфичность (доля истинно отрицательных): \(\frac{TN}{TN + FP}\), доля реальных отрицательных случаев, которые модель правильно выявляет.
- F-бета мера: \(F_\beta = \frac{(1+\beta^2) PR}{\beta^2 P + R}\). F1 — это случай \(\beta = 1\). F2 (\(\beta = 2\)) сильнее учитывает полноту; F0.5 (\(\beta = 0.5\)) сильнее учитывает точность.
- Макро-усреднение: вычисляется F1 для каждого класса и берётся невзвешенное среднее, поэтому каждый класс учитывается одинаково.
- Микро-усреднение: суммируются TP, FP и FN по всем классам и вычисляется один F1, поэтому частые классы доминируют.
- Взвешенное усреднение: усредняются F1 по классам с весами, равными количеству истинных примеров каждого класса (support).
Интерпретация вашей оценки F1
F1 изменяется от 0 (нет истинно положительных результатов) до 1 (нет ложно положительных и ложно отрицательных результатов). Ориентировочное, неформальное руководство:
- Примерно от 0 до 0.5: слабо
- От 0.5 до 0.7: умеренно
- От 0.7 до 0.9: хорошо
- Выше 0.9: очень сильно
Эти диапазоны зависят от контекста, универсального стандарта не существует. F1, равный 0.6, может быть отличным результатом для сложной задачи, например обнаружения редких событий при зашумлённых метках, тогда как 0.95 может оказаться недостаточным в системе, критичной к безопасности.
Что означает разрыв между точностью и полнотой
- Низкая точность, более высокая полнота: модель находит большинство положительных случаев, но выдаёт много ложных тревог.
- Низкая полнота, более высокая точность: положительные предсказания модели надёжны, но она пропускает много реальных положительных случаев.
Проверяйте оба показателя, а не полагайтесь только на F1, поскольку один и тот же F1 может получиться из очень разных сочетаний точности и полноты.
Ограничения, которые стоит учитывать
- F1 не учитывает истинно отрицательные результаты, поэтому ничего не говорит о том, насколько хорошо модель работает с отрицательным классом.
- Он зависит от баланса классов. Одна и та же модель может получать разные оценки на наборах данных с разной долей положительных примеров.
- Он зависит от порога принятия решения. Изменение порога меняет соотношение точности и полноты и смещает F1.
- Всегда сравнивайте с базовым уровнем, например с предсказателем, который всегда выдаёт класс большинства или всегда положительный класс, либо с простой существующей моделью, чтобы понять, является ли оценка реальным улучшением.