¿Qué es el F1 score?
El F1 score es una métrica única que combina la precisión y el recall en un solo número, lo que lo convierte en una de las formas más utilizadas para evaluar modelos de clasificación en machine learning, recuperación de información y estadística. Se trata de la media armónica de la precisión y el recall, de modo que premia a los clasificadores capaces de equilibrar ambas en lugar de destacar solo en una de ellas.
Cómo usar esta calculadora
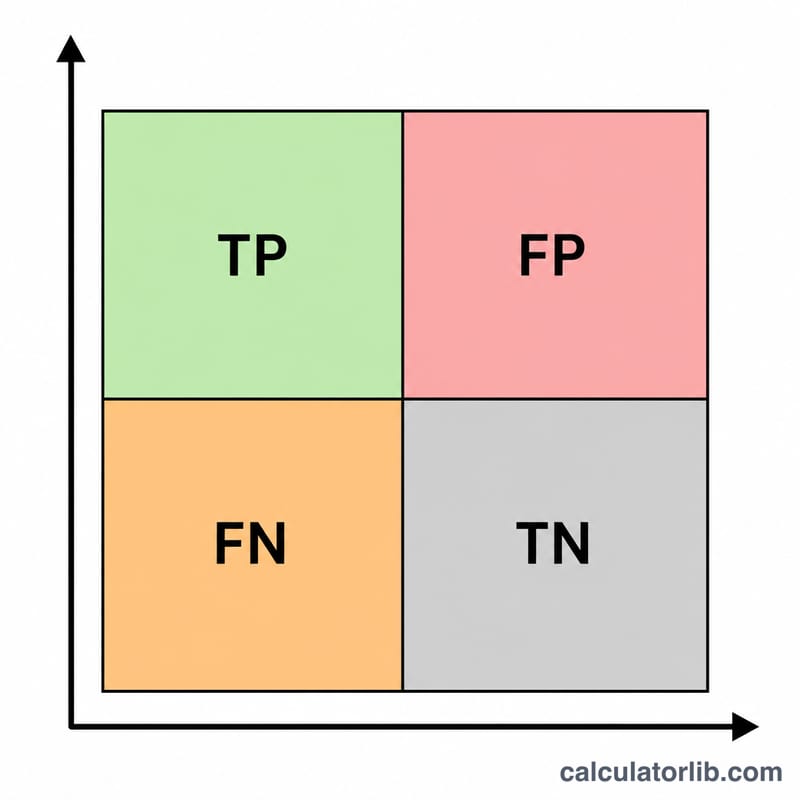
Introduce tres valores de tu matriz de confusión: los verdaderos positivos (TP, los positivos predichos correctamente), los falsos positivos (FP, negativos que se predijeron erróneamente como positivos) y los falsos negativos (FN, positivos que se pasaron por alto). La calculadora te devuelve al instante la precisión, el recall y el F1 score resultante.
La fórmula explicada
Precisión \(= \text{TP} / (\text{TP} + \text{FP})\) mide cuántos de los positivos predichos eran correctos. Recall \(= \text{TP} / (\text{TP} + \text{FN})\) mide cuántos de los positivos reales se lograron detectar. El F1 score se calcula entonces como
$$F_1 = \frac{2 \cdot (\text{precisión} \cdot \text{recall})}{\text{precisión} + \text{recall}}$$Al tratarse de una media armónica, un valor bajo en la precisión o en el recall hace que el F1 score caiga de forma notable.
Ejemplo práctico
Supongamos que \(\text{TP} = 70\), \(\text{FP} = 30\) y \(\text{FN} = 10\). La precisión \(= 70 / 100 = 0{,}70\). El recall \(= 70 / 80 = 0{,}875\). El F1:
$$F_1 = \frac{2 \cdot (0{,}70 \cdot 0{,}875)}{0{,}70 + 0{,}875} = \frac{2 \cdot 0{,}6125}{1{,}575} \approx 0{,}7778$$es decir, alrededor del 77,78 %.
Puntuación F1 en diferentes escenarios de precisión y exhaustividad
F1 es la media armónica de la precisión y la exhaustividad: \(F_1 = \frac{2PR}{P+R}\). La tabla la compara con la media aritmética simple para varios pares de precisión (P) y exhaustividad (R).
| Precisión | Exhaustividad | Media aritmética | F1 |
|---|---|---|---|
| 0.90 | 0.90 | 0.900 | 0.900 |
| 0.99 | 0.50 | 0.745 | ≈ 0.664 |
| 0.80 | 0.60 | 0.700 | ≈ 0.686 |
| 1.00 | 0.10 | 0.550 | ≈ 0.182 |
| 0.50 | 0.50 | 0.500 | 0.500 |
La fila 0.80/0.60 corresponde, por ejemplo, a VP = 60, FP = 15, FN = 40: precisión = 60/75 = 0.80, exhaustividad = 60/100 = 0.60, y \(F_1 = \frac{2 \cdot 60}{2 \cdot 60 + 15 + 40} = \frac{120}{175} \approx 0.686\).
Nota: F1 siempre se sitúa más cerca del menor de los dos valores que la media aritmética. Cuando la precisión y la exhaustividad son iguales, F1 es igual a ambas. Cuanto más difieren, más se acerca F1 al valor más débil, de modo que un modelo no puede ocultar una mala exhaustividad tras una excelente precisión (ni al revés).
Términos de la matriz de confusión y métricas relacionadas
- Verdadero positivo (VP): un caso positivo que el modelo predijo correctamente como positivo.
- Falso positivo (FP): un caso negativo predicho erróneamente como positivo (una falsa alarma, error de tipo I).
- Falso negativo (FN): un caso positivo predicho erróneamente como negativo (una omisión, error de tipo II).
- Verdadero negativo (VN): un caso negativo predicho correctamente como negativo. VN no se utiliza en la fórmula de F1.
- Precisión (valor predictivo positivo): \(\frac{VP}{VP + FP}\), la proporción de predicciones positivas que son realmente positivas.
- Exhaustividad (sensibilidad, tasa de verdaderos positivos): \(\frac{VP}{VP + FN}\), la proporción de positivos reales que el modelo encuentra.
- Exactitud: \(\frac{VP + VN}{VP + VN + FP + FN}\), la proporción de todas las predicciones que son correctas. Puede resultar engañosa con datos desequilibrados.
- Especificidad (tasa de verdaderos negativos): \(\frac{VN}{VN + FP}\), la proporción de negativos reales identificados correctamente.
- Puntuación F-beta: \(F_\beta = \frac{(1+\beta^2) PR}{\beta^2 P + R}\). F1 es el caso \(\beta = 1\). F2 (\(\beta = 2\)) da más peso a la exhaustividad; F0.5 (\(\beta = 0.5\)) da más peso a la precisión.
- Promedio macro: calcular F1 para cada clase y tomar la media no ponderada, de modo que cada clase cuente por igual.
- Promedio micro: agrupar VP, FP y FN de todas las clases y calcular un único F1, de modo que las clases frecuentes dominen.
- Promedio ponderado: promediar las puntuaciones F1 por clase ponderadas según el número de instancias reales de cada clase (soporte).
Interpretación de tu puntuación F1
F1 va de 0 (ningún verdadero positivo) a 1 (ningún falso positivo ni falso negativo). Como guía orientativa e informal:
- Aproximadamente 0 a 0.5: débil
- 0.5 a 0.7: moderado
- 0.7 a 0.9: bueno
- Por encima de 0.9: muy sólido
Estos rangos dependen del contexto y no existe un estándar universal. Un F1 de 0.6 puede ser excelente para una tarea difícil, como la detección de eventos raros con etiquetas ruidosas, mientras que 0.95 puede ser insuficiente en un entorno crítico para la seguridad.
Qué significa una diferencia entre precisión y exhaustividad
- Precisión baja, exhaustividad mayor: el modelo encuentra la mayoría de los positivos, pero genera muchas falsas alarmas.
- Exhaustividad baja, precisión mayor: las predicciones positivas del modelo son fiables, pero se le escapan muchos positivos reales.
Revisa ambos valores en lugar de confiar solo en F1, ya que una misma puntuación F1 puede proceder de combinaciones de precisión/exhaustividad muy distintas.
Limitaciones a tener en cuenta
- F1 ignora los verdaderos negativos, por lo que no dice nada sobre cómo maneja el modelo la clase negativa.
- Depende del equilibrio de clases. El mismo modelo puede obtener puntuaciones distintas en conjuntos de datos con diferentes tasas de positivos.
- Depende del umbral de decisión. Cambiar el umbral intercambia precisión por exhaustividad y modifica F1.
- Compara siempre con una línea base, como un predictor de la clase mayoritaria o que siempre predice positivo, o con un modelo sencillo existente, para determinar si la puntuación supone una mejora real.
Preguntas frecuentes
¿Cuándo conviene usar el F1 en lugar de la exactitud (accuracy)? El F1 es preferible cuando las clases están desequilibradas, ya que la exactitud puede resultar engañosamente alta cuando una clase domina sobre las demás.
¿Qué se considera un buen F1 score? El F1 va de 0 a 1; cuanto más cerca de 1, mejor. Lo que se considera "bueno" depende de la tarea, pero los valores superiores a 0,8 suelen tomarse como sólidos.
¿Por qué es una media armónica? La media armónica penaliza el desequilibrio extremo entre la precisión y el recall más de lo que lo haría un promedio simple, garantizando así que ambas deban ser razonablemente altas.