O que a calculadora de conteúdo GC faz
Esta ferramenta calcula o conteúdo GC de qualquer sequência de DNA — a porcentagem de bases que são guanina (G) ou citosina (C). O conteúdo GC é uma medida fundamental em biologia molecular, usada para comparar genomas, projetar primers de PCR e prever a temperatura de melting e a estabilidade do DNA de fita dupla. Como os pares G–C são unidos por três ligações de hidrogênio (contra duas nos pares A–T), sequências mais ricas em G e C tendem a ser termicamente mais estáveis.
Como usar
- Sequência de DNA: cole ou digite sua sequência usando as letras A, T, G e C.
- A entrada não diferencia maiúsculas de minúsculas — "atgc" e "ATGC" produzem o mesmo resultado.
- Quaisquer caracteres que não sejam A, T, G ou C (espaços, números, N, quebras de linha) são removidos automaticamente antes do cálculo, e a calculadora informa quantos caracteres inválidos foram removidos.
Por exemplo, ao inserir ATGCATGCATGC você obtém a porcentagem instantaneamente.
A fórmula
A calculadora conta as bases G e C na sequência limpa e divide pelo número total de bases válidas:
$$\text{GC\%} = \frac{N_G + N_C}{N_G + N_A + N_T + N_C} \times 100$$
Ela também informa o conteúdo AT complementar, usando a mesma lógica com as contagens de A e T. Se não houver bases válidas, o resultado é simplesmente 0.
Exemplo prático
Considere a sequência de exemplo ATGCATGCATGC:
- Total de bases = 12
- Contagem de G = 3, contagem de C = 3, então a contagem GC = 6
- Conteúdo GC = $$(6 \div 12) \times 100 = 50\%$$ 50%
- Contagem de AT = 6, então o conteúdo AT = 50%
Uma sequência equilibrada como esta tem conteúdo GC e AT iguais.
Conteúdo GC típico de organismos comuns
O conteúdo GC genômico varia enormemente na árvore da vida, de cerca de um quinto a quase três quartos de todas as bases sendo G ou C. A tabela abaixo lista médias de genoma completo comumente citadas para organismos de referência bem estudados. Todos os valores são médias aproximadas do genoma inteiro, arredondadas a partir de montagens de referência publicadas; o valor exato depende da linhagem, do isolado, da versão da montagem e de a sequência organelar (mitocondrial, plastidial) e repetitiva/não posicionada estar incluída ou não. Genes, promotores, íntrons e isócoros individuais dentro do mesmo genoma podem desviar da média em 20 pontos percentuais ou mais; portanto, use estes números como orientação, não como meta para qualquer sequência específica.
| Organismo | Tipo de genoma | %GC aprox. | Por que fica nessa faixa |
|---|---|---|---|
| Plasmodium falciparum (parasita da malária) | Genoma nuclear, protozoário apicomplexo | ~19% | Um dos genomas mais ricos em AT conhecidos; o viés extremo para AT se estende às regiões codificantes e torna notoriamente difícil fazer PCR e clonagem de suas sequências. |
| Dictyostelium discoideum (ameba social) | Genoma nuclear, amebozoário | ~22% | Fortemente rico em AT, com longos trechos homopoliméricos de A e T que complicaram sua montagem original. |
| Arabidopsis thaliana (agrião-de-thale) | Genoma nuclear, planta com flores | ~36% | Típico de muitos genomas nucleares de plantas; éxons codificantes são mais ricos em GC do que a média intergênica. |
| Saccharomyces cerevisiae (levedura de padaria) | Genoma nuclear, levedura de brotamento | ~38% | Genoma eucarioto compacto e denso em genes, com um fundo moderadamente rico em AT. |
| Homo sapiens (humano) | Genoma nuclear, mamífero | ~41% | Mosaico de isócoros pobres e ricos em GC; regiões ricas em genes e ilhas CpG ficam bem acima da média do genoma. |
| Drosophila melanogaster (mosca-da-fruta) | Genoma nuclear, inseto | ~42% | Composição quase equilibrada; regiões heterocromáticas e repetitivas são mais ricas em AT do que a eucromatina. |
| Escherichia coli K-12 | Cromossomo bacteriano circular | ~50,8% | O clássico genoma de referência de composição equilibrada, parte do motivo de ser um hospedeiro tão conveniente para clonagem e expressão. |
| Mycobacterium tuberculosis H37Rv | Cromossomo bacteriano circular (actinobactéria) | ~65,6% | Rica em GC como a maioria das actinobactérias; o uso de códons é fortemente desviado para G/C na terceira posição. |
| Streptomyces coelicolor A3(2) | Cromossomo bacteriano linear (actinobactéria) | ~72% | Um dos genomas mais ricos em GC com os quais se trabalha rotineiramente; a amplificação geralmente exige tampões adequados a GC, DMSO ou betaína. |
O padrão geral é real e reproduzível: parasitas intracelulares obrigatórios e algumas amebas e leveduras de vida livre tendem a ser ricos em AT, enquanto actinobactérias e muitas bactérias do solo tendem a ser ricas em GC. As causas subjacentes são debatidas e incluem viés mutacional, diferenças na maquinaria de reparo do DNA e seleção relacionada ao estilo de vida e ao ambiente.
Termos e variáveis principais
Variáveis usadas na fórmula
| Símbolo | Significado |
|---|---|
| \(N_G\) | Número de bases guanina (G) contadas na sequência. |
| \(N_C\) | Número de bases citosina (C) contadas na sequência. |
| \(N_A\) | Número de bases adenina (A) contadas na sequência. |
| \(N_T\) | Número de bases timina (T) contadas na sequência. |
| \(N_G + N_A + N_T + N_C\) | Total de bases válidas — o denominador. Apenas os caracteres inequívocos A, T, G e C são contados; lacunas, espaços, dígitos, quebras de linha e linhas de cabeçalho FASTA são excluídos, de modo que uma sequência com códigos de ambiguidade pode ter um total menor que seu comprimento bruto em caracteres. |
Termos
- Adenina (A) — uma base púrica; pareia com a timina no DNA por meio de duas ligações de hidrogênio.
- Timina (T) — uma base pirimidínica encontrada no DNA; pareia com a adenina.
- Guanina (G) — uma base púrica; pareia com a citosina por meio de três ligações de hidrogênio.
- Citosina (C) — uma base pirimidínica; pareia com a guanina.
- Par de bases (pb) — um pareamento A–T ou G–C entre as duas fitas de uma dupla hélice; também é a unidade padrão de comprimento do DNA.
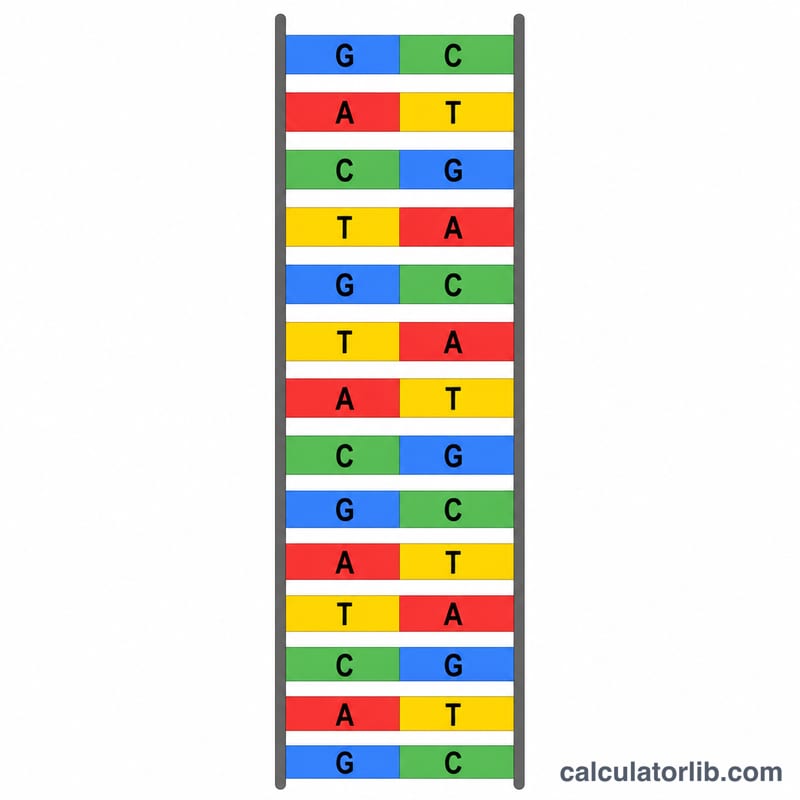
- Fita complementar — a fita oposta, produzida substituindo cada base por seu par (A↔T, G↔C) e invertendo a ordem. Como G sempre pareia com C, uma sequência e sua complementar têm conteúdo GC idêntico — você pode calcular o %GC a partir de qualquer fita e obter a mesma resposta.
- Conteúdo GC (%GC) — a porcentagem de todas as bases válidas que são G ou C, conforme a fórmula acima.
- Conteúdo AT — a grandeza complementar para sequências que contêm apenas A, T, G e C: \(\text{AT\%} = 100 - \text{GC\%}\).
- Temperatura de melting (Tm) — a temperatura na qual metade de uma população de duplas hélices de DNA se separou em fitas simples. Ela aumenta com o conteúdo GC, mas também depende do comprimento, do sal, da concentração e do contexto da sequência.
- Primer de PCR — um oligonucleotídeo sintético curto (geralmente cerca de 18–25 nt) que se anela ao molde e fornece a extremidade 3′ a partir da qual a polimerase estende. Seu conteúdo GC e sua Tm são as duas propriedades de composição que os projetistas verificam primeiro.
- Isócoro — um longo trecho de DNA genômico (centenas de quilobases) com conteúdo GC relativamente uniforme, que difere dos trechos vizinhos. Os genomas de mamíferos são classicamente descritos como um mosaico dessas regiões pobres e ricas em GC.
- Código de ambiguidade N — o símbolo IUPAC para "qualquer base" (A, C, G ou T), usado quando uma leitura de sequenciamento é incerta ou uma lacuna de montagem é preenchida. Outros códigos IUPAC, como R (A ou G), Y (C ou T) e W (A ou T), funcionam da mesma forma. Como um N pode ser G, C, A ou T, ele não pode ser pontuado e normalmente é excluído tanto do numerador quanto do denominador — uma sequência preenchida com muitos N informará o %GC apenas para as bases resolvidas.
- Uracila (U) — a pirimidina que substitui a timina no RNA; ela pareia com a adenina da mesma forma que o T. Por isso, sequências de RNA devem ser convertidas para a forma de DNA (substituindo cada U por T) antes de calcular o conteúdo GC; caso contrário, os caracteres U não são reconhecidos como bases válidas e o denominador fica errado. Note que o valor de GC em si não é afetado pela substituição, pois o U contribui para o conteúdo AT, não para o GC.
Perguntas frequentes
Por que o conteúdo GC é importante? Ele afeta a estabilidade do DNA e a temperatura de melting, ajuda a identificar regiões ricas em genes e é usado no projeto de primers para que se liguem de forma confiável durante a PCR.
O que acontece com os caracteres inválidos? Letras como N, U, lacunas ou espaços em branco são removidas automaticamente. Apenas A, T, G e C são mantidas e contadas, então espaços em sequências coladas não distorcem o resultado.
A calculadora aceita sequências de RNA? A calculadora reconhece apenas bases de DNA (A, T, G, C). A uracila (U) do RNA seria filtrada, então converta U em T primeiro para obter uma leitura precisa.