GC 함량 계산기로 무엇을 할 수 있나요?
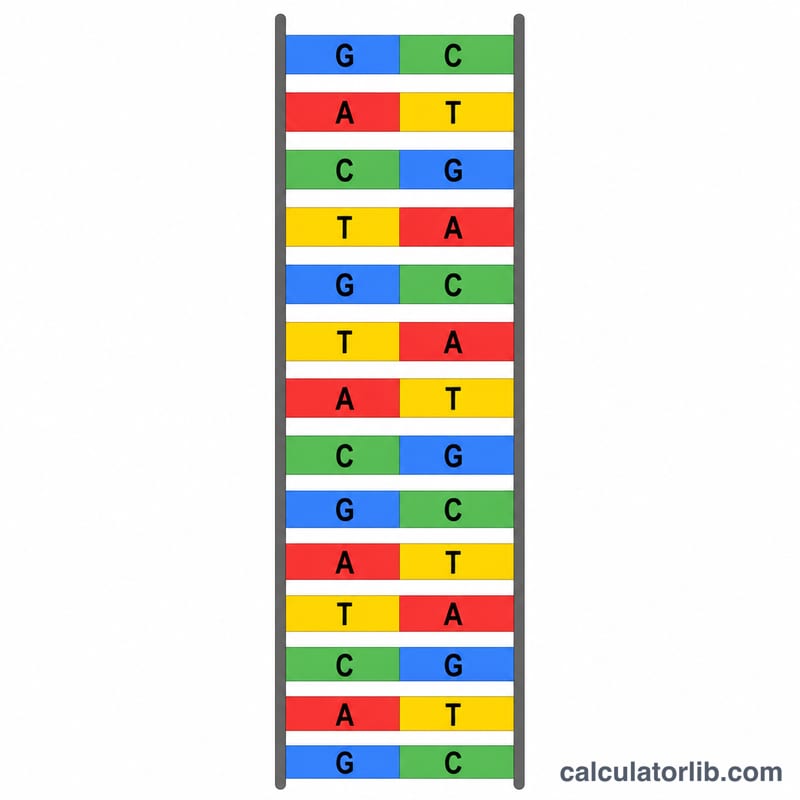
이 도구는 입력한 DNA 염기서열의 GC 함량, 즉 구아닌(G) 또는 시토신(C)에 해당하는 염기의 비율을 계산합니다. GC 함량은 분자생물학에서 매우 기본이 되는 지표로, 게놈을 비교하거나 PCR 프라이머를 설계하고 이중나선 DNA의 녹는점(Tm)과 안정성을 예측하는 데 널리 쓰입니다. G–C 쌍은 수소결합 세 개로 연결되는 반면 A–T 쌍은 두 개로 연결되기 때문에, G와 C가 많은 서열일수록 열적으로 더 안정적인 경향이 있습니다.
사용 방법
- DNA 염기서열: A, T, G, C 네 가지 문자를 사용해 서열을 붙여넣거나 직접 입력하세요.
- 입력은 대소문자를 구분하지 않습니다. "atgc"와 "ATGC"는 동일한 결과를 냅니다.
- A, T, G, C가 아닌 문자(공백, 숫자, N, 줄바꿈 등)는 계산 전에 자동으로 제거되며, 계산기가 몇 개의 잘못된 문자를 제거했는지 알려 줍니다.
예를 들어 ATGCATGCATGC를 입력하면 즉시 비율이 표시됩니다.
계산 공식
계산기는 정리된 서열에서 G와 C 염기의 개수를 센 뒤, 전체 유효 염기 수로 나눕니다.
$$\text{GC\%} = \frac{N_G + N_C}{N_G + N_A + N_T + N_C} \times 100$$
같은 방식으로 A와 C 개수를 이용해 상보적인 AT 함량도 함께 계산합니다. 유효한 염기가 하나도 없을 경우 결과는 단순히 0으로 표시됩니다.
계산 예시
예시 서열 ATGCATGCATGC를 살펴봅시다.
- 전체 염기 수 = 12
- G 개수 = 3, C 개수 = 3 이므로 GC 개수 = 6
- GC 함량 = \((6 \div 12) \times 100\) = 50%
- AT 개수 = 6 이므로 AT 함량 = 50%
이처럼 균형 잡힌 서열은 GC 함량과 AT 함량이 동일하게 나타납니다.
일반적인 생물의 전형적인 GC 함량
게놈 GC 함량은 생명의 계통수 전체에서 엄청나게 다양하며, 모든 염기의 약 1/5에서 거의 3/4까지가 G 또는 C입니다. 아래 표는 잘 연구된 표준 생물의 일반적으로 인용되는 전체 게놈 평균을 나열합니다. 모든 수치는 게시된 참조 어셈블리에서 반올림한 근사 게놈 전체 평균입니다. 정확한 값은 계통, 분리주, 어셈블리 버전 및 세포소기관(미토콘드리아, 엽록체) 및 반복/미배치 서열의 포함 여부에 따라 달라집니다. 같은 게놈 내의 개별 유전자, 프로모터, 인트론 및 이소코어는 평균에서 20 퍼센트 포인트 이상 벗어날 수 있으므로, 이 수치를 특정 서열의 목표가 아닌 방향으로 사용하십시오.
| 생물 | 게놈 유형 | 약 %GC | 이 위치에 있는 이유 |
|---|---|---|---|
| Plasmodium falciparum (말라리아 기생충) | 핵 게놈, 아피콤플렉스 원생동물 | ~19% | 알려진 것 중 가장 AT가 풍부한 게놈 중 하나입니다. 극단적인 AT 편향이 코딩 영역으로 확장되어 이 생물의 PCR 및 클로닝을 악명 높게 어렵게 만듭니다. |
| Dictyostelium discoideum (사회 아메바) | 핵 게놈, 아메바동물 | ~22% | 강하게 AT가 풍부하며, A와 T의 긴 호모폴리머 구간이 원래 어셈블리를 복잡하게 만들었습니다. |
| Arabidopsis thaliana (애기장대) | 핵 게놈, 개화 식물 | ~36% | 많은 식물 핵 게놈의 전형적인 예입니다. 코딩 엑손은 유전자 간 평균보다 GC가 더 풍부합니다. |
| Saccharomyces cerevisiae (빵효모) | 핵 게놈, 출아 효모 | ~38% | 콤팩트한 유전자 밀도가 높은 진핵생물 게놈으로 중간 정도로 AT가 풍부한 배경을 가지고 있습니다. |
| Homo sapiens (인간) | 핵 게놈, 포유류 | ~41% | GC가 부족한 이소코어와 GC가 풍부한 이소코어의 모자이크입니다. 유전자가 풍부한 영역과 CpG 아일랜드는 게놈 평균보다 훨씬 높습니다. |
| Drosophila melanogaster (초파리) | 핵 게놈, 곤충 | ~42% | 거의 균형 잡힌 조성입니다. 이색질 및 반복 영역은 진정색질보다 더 AT가 풍부합니다. |
| Escherichia coli K-12 | 원형 박테리아 염색체 | ~50.8% | 균형 잡힌 조성의 고전적인 참조 게놈이며, 이것이 이 생물이 편리한 클로닝 및 발현 숙주인 이유 중 일부입니다. |
| Mycobacterium tuberculosis H37Rv | 원형 박테리아 염색체 (방선균) | ~65.6% | 대부분의 방선균처럼 GC가 풍부합니다. 코돈 사용이 세 번째 위치에서 G/C로 크게 편향되어 있습니다. |
| Streptomyces coelicolor A3(2) | 선형 박테리아 염색체 (방선균) | ~72% | 일상적으로 작업하는 가장 GC가 풍부한 게놈 중 하나입니다. 증폭은 보통 GC 친화적 완충액, DMSO 또는 베타인이 필요합니다. |
광범위한 패턴은 실제이고 반복 가능합니다. 필수 세포 내 기생충과 일부 자유 생활 아메바 및 효모는 AT가 풍부한 경향이 있고, 방선균 및 많은 토양 박테리아는 GC가 풍부한 경향이 있습니다. 근본적인 원인은 논쟁 중이며 돌연변이 편향, DNA 수리 기계의 차이, 생활 방식 및 환경과 관련된 선택을 포함합니다.
핵심 용어 및 변수
공식에 사용된 변수
| 기호 | 의미 |
|---|---|
| \(N_G\) | 서열에서 센 구아닌(G) 염기의 수입니다. |
| \(N_C\) | 서열에서 센 시토신(C) 염기의 수입니다. |
| \(N_A\) | 서열에서 센 아데닌(A) 염기의 수입니다. |
| \(N_T\) | 서열에서 센 티민(T) 염기의 수입니다. |
| \(N_G + N_A + N_T + N_C\) | 총 유효 염기 — 분모입니다. 명확하지 않은 A, T, G 및 C 문자만 계산되고, 간격, 공간, 숫자, 줄 바꿈 및 FASTA 헤더 줄은 제외되므로 모호성 코드가 포함된 서열의 총합은 원본 문자 길이보다 낮을 수 있습니다. |
용어
- 아데닌(A) — 퓨린 염기입니다. DNA에서 두 개의 수소 결합을 통해 티민과 쌍을 이룹니다.
- 티민(T) — DNA에서 발견되는 피리미딘 염기입니다. 아데닌과 쌍을 이룹니다.
- 구아닌(G) — 퓨린 염기입니다. 3개의 수소 결합을 통해 시토신과 쌍을 이룹니다.
- 시토신(C) — 피리미딘 염기입니다. 구아닌과 쌍을 이룹니다.
- 염기쌍(bp) — 이중 가닥의 두 가닥에 걸친 하나의 A-T 또는 G-C 쌍입니다. DNA 길이의 표준 단위이기도 합니다.
- 상보 가닥 — 각 염기를 파트너(A↔T, G↔C)로 바꾸고 순서를 뒤집어 생성되는 반대 가닥입니다. G는 항상 C와 쌍을 이루기 때문에 서열과 그 상보체는 동일한 GC 함량을 갖습니다 — 어느 가닥에서든 %GC를 계산하고 같은 답을 얻을 수 있습니다.
- GC 함량(%GC) — 위의 공식에서 주어진 대로 모든 유효 염기의 G 또는 C인 백분율입니다.
- AT 함량 — A, T, G 및 C만 포함하는 서열에 대한 상보 수량입니다: \(\text{AT\%} = 100 - \text{GC\%}\).
- 융해 온도(Tm) — DNA 이중 가닥 모집단의 절반이 단일 가닥으로 분리되는 온도입니다. GC 함량에 따라 증가하지만 길이, 염도, 농도 및 서열 맥락에도 달라집니다.
- PCR 프라이머 — 템플릿에 어닐링되고 폴리머라제가 확장되는 3′ 말단을 제공하는 짧은 합성 올리고뉴클레오티드(일반적으로 약 18-25 nt)입니다. GC 함량과 Tm은 설계자가 먼저 확인하는 두 가지 조성 특성입니다.
- 이소코어 — 상대적으로 균일한 GC 함량을 가지고 있으며 인접한 스트레치와 다른 긴 게놈 DNA 구간(수백 킬로베이스)입니다. 포유류 게놈은 고전적으로 GC가 부족한 영역과 GC가 풍부한 영역의 모자이크로 설명됩니다.
- 모호성 코드 N — "임의의 염기"(A, C, G 또는 T)에 대한 IUPAC 기호이며, 서열 읽기가 불확실하거나 어셈블리 간격이 패딩될 때 사용됩니다. R(A 또는 G), Y(C 또는 T) 및 W(A 또는 T)와 같은 다른 IUPAC 코드도 동일하게 작동합니다. N은 G, C, A 또는 T일 수 있으므로 점수를 매길 수 없으며 일반적으로 분자와 분모 모두에서 제외됩니다 — 많은 N으로 패딩된 서열은 해결된 염기에 대해서만 %GC를 보고합니다.
- 우라실(U) — RNA에서 티민을 대체하는 피리미딘입니다. T처럼 아데닌과 쌍을 이룹니다. RNA 서열은 GC 함량을 계산하기 전에 DNA 형태로 변환되어야 하므로(모든 U를 T로 바꿈), 그렇지 않으면 U 문자가 유효한 염기로 인식되지 않고 분모가 잘못됩니다. U가 GC 함량이 아닌 AT 함량에 기여하므로 GC 값 자체는 치환의 영향을 받지 않습니다.
자주 묻는 질문
GC 함량이 왜 중요한가요? GC 함량은 DNA의 안정성과 녹는점(Tm)에 영향을 주고, 유전자가 밀집된 영역을 찾는 데 도움이 되며, PCR 과정에서 프라이머가 안정적으로 결합하도록 설계할 때도 활용됩니다.
잘못된 문자는 어떻게 처리되나요? N, U, 갭(-), 공백 같은 문자는 자동으로 제거됩니다. A, T, G, C만 남겨서 계산하므로, 붙여넣은 서열에 공백이 섞여 있어도 결과가 왜곡되지 않습니다.
RNA 염기서열도 입력할 수 있나요? 이 계산기는 DNA 염기(A, T, G, C)만 인식합니다. RNA의 우라실(U)은 걸러지므로, 정확한 결과를 얻으려면 먼저 U를 T로 변환한 뒤 입력하세요.