Công cụ tính hàm lượng GC làm được gì
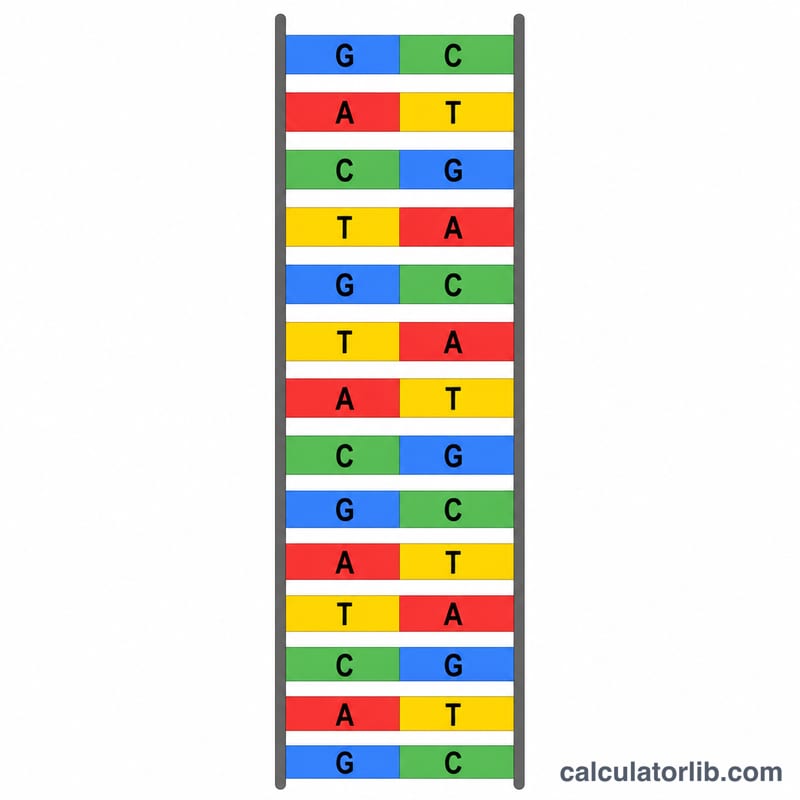
Công cụ này tính hàm lượng GC của bất kỳ trình tự DNA nào — tức là tỷ lệ phần trăm các base là guanine (G) hoặc cytosine (C). Hàm lượng GC là một chỉ số nền tảng trong sinh học phân tử, được dùng để so sánh các hệ gen, thiết kế mồi PCR, cũng như dự đoán nhiệt độ nóng chảy và độ ổn định của DNA mạch kép. Vì cặp G–C được liên kết bằng ba liên kết hydro (so với hai liên kết ở cặp A–T), nên những trình tự giàu G và C thường bền nhiệt hơn.
Cách sử dụng
- Trình tự DNA: Dán hoặc gõ trình tự của bạn bằng các chữ cái A, T, G và C.
- Dữ liệu nhập vào không phân biệt chữ hoa hay chữ thường — "atgc" và "ATGC" cho cùng một kết quả.
- Mọi ký tự không phải A, T, G hay C (khoảng trắng, chữ số, N, ký tự xuống dòng) sẽ tự động bị loại bỏ trước khi tính, và công cụ sẽ báo cho bạn biết đã loại bao nhiêu ký tự không hợp lệ.
Ví dụ, nhập ATGCATGCATGC sẽ cho ngay kết quả phần trăm.
Công thức tính
Công cụ đếm số base G và C trong trình tự đã được làm sạch, rồi chia cho tổng số base hợp lệ:
$$\text{Hàm lượng GC (\%)} = \frac{\text{Số lượng G} + \text{Số lượng C}}{\text{Tổng số base}} \times 100$$
Công cụ cũng tính hàm lượng AT bổ sung theo cùng logic dựa trên số lượng A và T. Nếu không có base hợp lệ nào, kết quả đơn giản là 0.
Ví dụ minh họa
Lấy trình tự ví dụ ATGCATGCATGC:
- Tổng số base = 12
- Số lượng G = 3, số lượng C = 3, nên số base GC = 6
- Hàm lượng GC = \((6 \div 12) \times 100 = \) 50%
- Số base AT = 6, nên hàm lượng AT = 50%
Một trình tự cân bằng như thế này có hàm lượng GC và AT bằng nhau.
Hàm lượng GC điển hình của các sinh vật thông dụng
Hàm lượng GC của bộ gen dao động rất lớn trên cây tiến hóa, từ khoảng một phần năm đến gần ba phần tư của tất cả các bazơ là G hoặc C. Bảng dưới đây liệt kê các giá trị trung bình bộ gen toàn bộ được trích dẫn phổ biến cho các sinh vật tham chiếu được nghiên cứu kỹ lưỡng. Tất cả các số liệu là các giá trị trung bình xấp xỉ toàn bộ bộ gen được làm tròn từ các cơ sở dữ liệu tham chiếu được công bố; giá trị chính xác phụ thuộc vào chủng, phân lập vật, phiên bản lắp ráp, và liệu trình tự sinh vật nhân (ty thể, lục lạp) và trình tự lặp lại/không được xác định vị trí có được bao gồm hay không. Các gen riêng lẻ, vùng khuyến nạp, intron và isochore trong cùng một bộ gen có thể lệch khỏi giá trị trung bình đến 20 điểm phần trăm hoặc hơn, vì vậy hãy sử dụng các số này làm định hướng, không phải là mục tiêu cho bất kỳ trình tự cụ thể nào.
| Sinh vật | Loại bộ gen | Xấp xỉ %GC | Lý do nó ở đó |
|---|---|---|---|
| Plasmodium falciparum (ký sinh trùng gây sốt rét) | Bộ gen nhân, sinh vật nguyên sinh apicomplexan | ~19% | Một trong những bộ gen giàu AT nhất được biết đến; sự thiên vị AT cực đoan kéo dài vào các vùng mã hóa và làm cho PCR và nhân bản trình tự của nó có danh tiếng là khó khăn. |
| Dictyostelium discoideum (amip xã hội) | Bộ gen nhân, sinh vật nguyên sinh amip | ~22% | Giàu AT mạnh mẽ, với các đoạn dài của A và T lặp lại liên tục làm phức tạp việc lắp ráp ban đầu của nó. |
| Arabidopsis thaliana (cải thảo) | Bộ gen nhân, thực vật có hoa | ~36% | Điển hình của nhiều bộ gen nhân thực vật; các exon mã hóa giàu GC hơn so với mức trung bình liên gen. |
| Saccharomyces cerevisiae (nấm men bánh mì) | Bộ gen nhân, nấm men nảy chồi | ~38% | Bộ gen sinh vật nhân chặt chẽ, giàu gen với nền giàu AT vừa phải. |
| Homo sapiens (con người) | Bộ gen nhân, động vật có vú | ~41% | Sự khảm ghép của các isochore nghèo GC và giàu GC; các vùng giàu gen và các đảo CpG nằm cao hơn nhiều so với mức trung bình bộ gen. |
| Drosophila melanogaster (ruồi giấm) | Bộ gen nhân, côn trùng | ~42% | Thành phần gần như cân bằng; các vùng dị sắc thể và lặp lại giàu AT hơn so với euchromatin. |
| Escherichia coli K-12 | Nhiễm sắc thể vi khuẩn vòng tròn | ~50.8% | Bộ gen tham chiếu có thành phần cân bằng kinh điển, đây là một phần lý do tại sao nó lại là một vật chủ nhân bản và biểu hiện thuận tiện như vậy. |
| Mycobacterium tuberculosis H37Rv | Nhiễm sắc thể vi khuẩn vòng tròn (vi khuẩn actino) | ~65.6% | Giàu GC như hầu hết các vi khuẩn actino; việc sử dụng codon bị lệch nặng về phía G/C ở vị trí thứ ba. |
| Streptomyces coelicolor A3(2) | Nhiễm sắc thể vi khuẩn tuyến tính (vi khuẩn actino) | ~72% | Trong số những bộ gen giàu GC nhất được làm việc thường xuyên với; việc khuếch đại thường cần các bộ đệm thân thiện với GC, DMSO hoặc betaine. |
Mô hình rộng này là thực tế và có thể lặp lại: ký sinh trùng bắt buộc bên trong tế bào và một số amip sống tự do cũng như nấm men có xu hướng giàu AT, trong khi vi khuẩn actino và nhiều vi khuẩn đất có xu hướng giàu GC. Các nguyên nhân cơ bản bị tranh luận và bao gồm sai lệch đột biến, sự khác biệt của cơ chế sửa chữa DNA, và lựa chọn liên quan đến lối sống và môi trường.
Các Thuật ngữ và Biến số Chính
Các biến được sử dụng trong công thức
| Ký hiệu | Ý nghĩa |
|---|---|
| \(N_G\) | Số lượng các cơ sở guanine (G) được đếm trong trình tự. |
| \(N_C\) | Số lượng các cơ sở cytosine (C) được đếm trong trình tự. |
| \(N_A\) | Số lượng các cơ sở adenine (A) được đếm trong trình tự. |
| \(N_T\) | Số lượng các cơ sở thymine (T) được đếm trong trình tự. |
| \(N_G + N_A + N_T + N_C\) | Tổng số cơ sở hợp lệ — mẫu số. Chỉ các ký tự A, T, G và C rõ ràng được đếm; các khoảng trống, dấu cách, chữ số, ngắt dòng và các dòng tiêu đề FASTA bị loại trừ, do đó một trình tự chứa mã ambiguity có thể có tổng dưới chiều dài ký tự thô của nó. |
Thuật ngữ
- Adenine (A) — một cơ sở purine; ghép cặp với thymine trong DNA thông qua hai liên kết hydro.
- Thymine (T) — một cơ sở pyrimidine được tìm thấy trong DNA; ghép cặp với adenine.
- Guanine (G) — một cơ sở purine; ghép cặp với cytosine thông qua ba liên kết hydro.
- Cytosine (C) — một cơ sở pyrimidine; ghép cặp với guanine.
- Cặp cơ sở (bp) — một ghép cặp A–T hoặc G–C trên hai sợi của một đôi xoắn kép; cũng là đơn vị tiêu chuẩn của chiều dài DNA.
- Sợi bổ sung — sợi đối lập được tạo ra bằng cách thay thế mỗi cơ sở bằng đối tác của nó (A↔T, G↔C) và đảo ngược thứ tự. Vì G luôn ghép cặp với C, một trình tự và phần bổ sung của nó có hàm lượng GC giống hệt nhau — bạn có thể tính %GC từ bất kỳ sợi nào và nhận được cùng một câu trả lời.
- Hàm lượng GC (%GC) — tỷ lệ phần trăm của tất cả các cơ sở hợp lệ là G hoặc C, như được đưa ra bởi công thức ở trên.
- Hàm lượng AT — đại lượng bổ sung cho các trình tự chứa chỉ A, T, G và C: \(\text{AT\%} = 100 - \text{GC\%}\).
- Nhiệt độ nóng chảy (Tm) — nhiệt độ mà tại đó nửa dân số đôi xoắn kép DNA đã tách thành các sợi đơn. Nó tăng lên cùng với hàm lượng GC nhưng cũng phụ thuộc vào chiều dài, muối, nồng độ và ngữ cảnh trình tự.
- Mồi PCR — một oligonucleotide tổng hợp ngắn (thường khoảng 18–25 nt) gắn vào mẫu và cung cấp đầu 3′ mà từ đó polymerase mở rộng. Hàm lượng GC và Tm của nó là hai tính chất thành phần mà các nhà thiết kế kiểm tra trước tiên.
- Isochore — một đoạn dài của DNA bộ gen (hàng trăm kilobases) có hàm lượng GC tương đối đồng nhất khác với các đoạn lân cận. Các bộ gen động vật có vú thường được mô tả như một khảm ghép của những vùng nghèo GC và giàu GC như vậy.
- Mã ambiguity N — ký hiệu IUPAC cho "bất kỳ cơ sở nào" (A, C, G hoặc T), được sử dụng khi một bản đọc trình tự không chắc chắn hoặc một khoảng trống lắp ráp được lấp đầy. Các mã IUPAC khác như R (A hoặc G), Y (C hoặc T) và W (A hoặc T) hoạt động theo cùng một cách. Vì N có thể là G, C, A hoặc T, nó không thể được ghi bàn và thường bị loại trừ khỏi cả tử số và mẫu số — một trình tự được lấp đầy bằng nhiều Ns sẽ báo cáo %GC chỉ cho các cơ sở đã giải quyết.
- Uracil (U) — pyrimidine thay thế thymine trong RNA; nó ghép cặp với adenine giống như T. Do đó, các trình tự RNA phải được chuyển đổi thành dạng DNA (thay thế mọi U bằng T) trước khi tính toán hàm lượng GC, nếu không các ký tự U không được công nhận là các cơ sở hợp lệ và mẫu số là sai. Lưu ý rằng giá trị GC chính nó không bị ảnh hưởng bởi sự thay thế, vì U góp phần vào hàm lượng AT, không phải GC.
Câu hỏi thường gặp
Vì sao hàm lượng GC lại quan trọng? Nó ảnh hưởng đến độ ổn định và nhiệt độ nóng chảy của DNA, giúp xác định các vùng giàu gen, đồng thời được dùng khi thiết kế mồi để chúng bắt cặp ổn định trong phản ứng PCR.
Các ký tự không hợp lệ sẽ ra sao? Những chữ cái như N, U, dấu cách hay khoảng trắng sẽ tự động bị loại bỏ. Chỉ A, T, G và C được giữ lại và đếm, nhờ vậy các khoảng trắng trong trình tự bạn dán vào sẽ không làm sai lệch kết quả.
Công cụ có chấp nhận trình tự RNA không? Công cụ chỉ nhận diện các base DNA (A, T, G, C). Uracil (U) trong RNA sẽ bị lọc bỏ, vì vậy hãy chuyển U thành T trước để có kết quả chính xác.