GC कंटेंट कैलकुलेटर क्या करता है
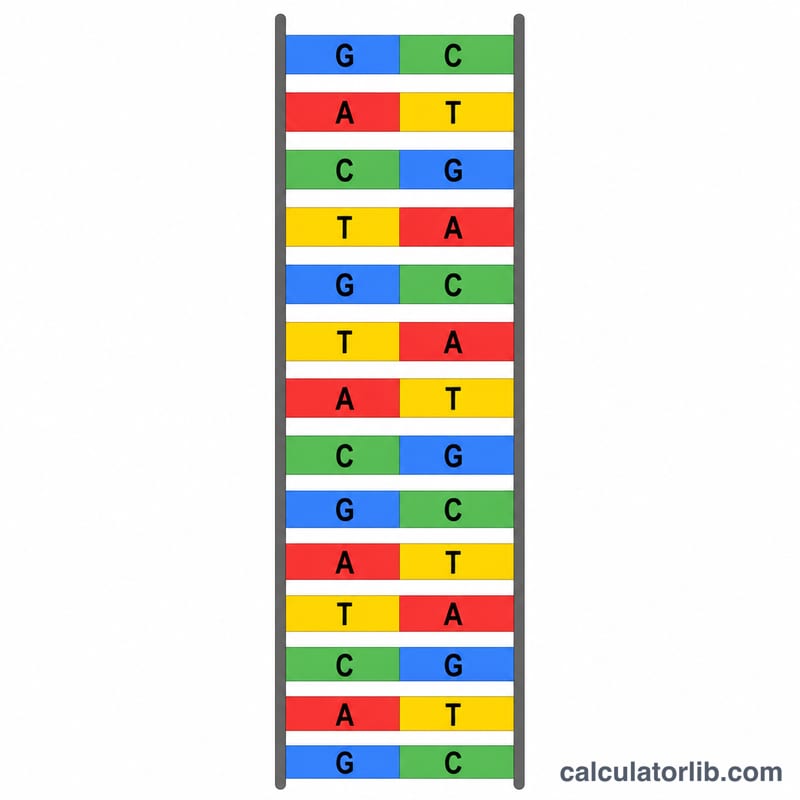
यह टूल किसी भी DNA सीक्वेंस का GC कंटेंट निकालता है — यानी उन बेस का प्रतिशत जो या तो ग्वानिन (G) हैं या साइटोसिन (C)। आणविक जीवविज्ञान (मॉलिक्यूलर बायोलॉजी) में GC कंटेंट एक बुनियादी माप है, जिसका इस्तेमाल जीनोम की तुलना करने, PCR प्राइमर डिज़ाइन करने, और डबल-स्ट्रैंडेड DNA के पिघलने के तापमान (मेल्टिंग टेम्परेचर) व स्थिरता का अनुमान लगाने में होता है। चूँकि G–C जोड़े तीन हाइड्रोजन बॉन्ड से जुड़े होते हैं (जबकि A–T जोड़े केवल दो से), इसलिए जिन सीक्वेंस में G और C ज़्यादा होते हैं वे आमतौर पर ताप की दृष्टि से अधिक स्थिर होते हैं।
इसका इस्तेमाल कैसे करें
- DNA सीक्वेंस: A, T, G और C अक्षरों का उपयोग करते हुए अपना सीक्वेंस पेस्ट करें या टाइप करें।
- इनपुट केस-सेंसिटिव नहीं है — "atgc" और "ATGC" दोनों एक ही परिणाम देंगे।
- जो भी अक्षर A, T, G या C नहीं हैं (स्पेस, संख्याएँ, N, लाइन ब्रेक), उन्हें गणना से पहले अपने-आप हटा दिया जाता है, और कैलकुलेटर बता देता है कि उसने कितने अमान्य अक्षर हटाए।
उदाहरण के लिए, ATGCATGCATGC डालने पर आपको तुरंत प्रतिशत मिल जाता है।
फॉर्मूला
कैलकुलेटर आपके साफ़ किए गए सीक्वेंस में G और C बेस गिनता है और उन्हें कुल मान्य बेस की संख्या से भाग देता है:
$$\text{GC\%} = \frac{N_G + N_C}{N_G + N_A + N_T + N_C} \times 100$$
यह इसी तर्क से A और T की संख्या के आधार पर पूरक AT कंटेंट भी बताता है। यदि कोई मान्य बेस मौजूद नहीं है, तो परिणाम सीधे 0 रहता है।
हल किया हुआ उदाहरण
उदाहरण सीक्वेंस ATGCATGCATGC को लें:
- कुल बेस = 12
- G की संख्या = 3, C की संख्या = 3, यानी GC गिनती = 6
- GC कंटेंट = \((6 \div 12) \times 100 = \mathbf{50\%}\)
- AT गिनती = 6, यानी AT कंटेंट = 50%
इस तरह का संतुलित सीक्वेंस GC और AT कंटेंट दोनों में बराबर होता है।
सामान्य जीवों की विशिष्ट GC सामग्री
जीनोमिक GC सामग्री जीवन के पेड़ में बेहद भिन्न होती है, लगभग एक पाँचवाँ से लगभग तीन चौथाई तक सभी बेस G या C हो सकते हैं। नीचे दी गई तालिका अच्छी तरह से अध्ययन किए गए संदर्भ जीवों के लिए सामान्यतः उद्धृत संपूर्ण-जीनोम औसत सूचीबद्ध करती है। सभी आंकड़े अनुमानित जीनोम-व्यापी औसत हैं जो प्रकाशित संदर्भ विधानसभाओं से गोल किए गए हैं; सटीक मान तनाव, अलग-थलग, विधानसभा संस्करण, और क्या ऑर्गेनेलर (माइटोकॉन्ड्रियल, प्लास्टिड) और दोहराए गए/अप्रस्तुत अनुक्रम शामिल हैं, इस पर निर्भर करता है। एक ही जीनोम के भीतर व्यक्तिगत जीन, प्रमोटर, इंट्रॉन और आइसोकोर औसत से 20 प्रतिशत अंक या अधिक से विचलित हो सकते हैं, इसलिए इन संख्याओं को अभिविन्यास के रूप में उपयोग करें, किसी विशेष अनुक्रम के लिए लक्ष्य के रूप में नहीं।
| जीव | जीनोम प्रकार | अनुमानित %GC | यह वहाँ क्यों बैठता है |
|---|---|---|---|
| Plasmodium falciparum (मलेरिया परजीवी) | परमाणु जीनोम, एपिकॉम्प्लेक्सन प्रोटोजोआ | ~19% | सबसे AT-समृद्ध जीनोमों में से एक; चरम AT पूर्वाग्रह कोडिंग क्षेत्रों तक विस्तृत होता है और इसके अनुक्रमों की PCR और क्लोनिंग को बदनाम रूप से मुश्किल बनाता है। |
| Dictyostelium discoideum (सामाजिक अमीबा) | परमाणु जीनोम, अमीबाजोआ | ~22% | दृढ़ता से AT-समृद्ध, A और T के लंबे होमोपॉलिमर ट्रैक्ट के साथ जो इसकी मूल विधानसभा को जटिल बनाता है। |
| Arabidopsis thaliana (थेल क्रेस) | परमाणु जीनोम, पुष्पीय पौधा | ~36% | कई पौधे परमाणु जीनोम के लिए विशिष्ट; कोडिंग एक्सॉन इंटरजेनिक औसत की तुलना में अधिक GC-समृद्ध हैं। |
| Saccharomyces cerevisiae (बेकर का यीस्ट) | परमाणु जीनोम, कलियों वाला यीस्ट | ~38% | कॉम्पैक्ट, जीन-घने यूकेरियोटिक जीनोम जिसमें मध्यम AT-समृद्ध पृष्ठभूमि है। |
| Homo sapiens (मानव) | परमाणु जीनोम, स्तनपायी | ~41% | GC-गरीब और GC-समृद्ध आइसोकोर का मोज़ेक; जीन-समृद्ध क्षेत्र और CpG द्वीप जीनोम औसत से बहुत ऊपर हैं। |
| Drosophila melanogaster (फलों की मक्खी) | परमाणु जीनोम, कीट | ~42% | निकट-संतुलित संरचना; हेटेरोक्रोमैटिक और दोहराए गए क्षेत्र यूक्रोमेटिन की तुलना में अधिक AT-समृद्ध हैं। |
| Escherichia coli K-12 | वृत्ताकार बैक्टीरियल गुणसूत्र | ~50.8% | क्लासिक संतुलित-संरचना संदर्भ जीनोम, जो एक कारण है कि यह क्लोनिंग और अभिव्यक्ति मेजबान के रूप में इतना सुविधाजनक है। |
| Mycobacterium tuberculosis H37Rv | वृत्ताकार बैक्टीरियल गुणसूत्र (एक्टिनोबैक्टीरियम) | ~65.6% | अधिकांश एक्टिनोबैक्टीरिया की तरह GC-समृद्ध; कोडन उपयोग तीसरी स्थिति में G/C की ओर भारी रूप से तिरछा है। |
| Streptomyces coelicolor A3(2) | रैखिक बैक्टीरियल गुणसूत्र (एक्टिनोबैक्टीरियम) | ~72% | सबसे GC-समृद्ध जीनोम में से एक जो नियमित रूप से काम किया जाता है; प्रवर्धन आमतौर पर GC-अनुकूल बफ़र, DMSO या बेटाइन की आवश्यकता होती है। |
व्यापक पैटर्न वास्तविक और दोहराए जाने योग्य है: अनिवार्य अंतरकोशिकीय परजीवी और कुछ मुक्त-जीवी अमीबा और यीस्ट AT-समृद्ध प्रवृत्ति रखते हैं, जबकि एक्टिनोबैक्टीरिया और कई मिट्टी बैक्टीरिया GC-समृद्ध प्रवृत्ति रखते हैं। अंतर्निहित कारण विवादास्पद हैं और इसमें म्यूटेशनल पूर्वाग्रह, DNA मरम्मत मशीनरी अंतर, और जीवन शैली और वातावरण से संबंधित चयन शामिल हैं।
मुख्य शब्द और चर
सूत्र में प्रयुक्त चर
| प्रतीक | अर्थ |
|---|---|
| \(N_G\) | अनुक्रम में गिने गए गुआनिन (G) बेस की संख्या। |
| \(N_C\) | अनुक्रम में गिने गए साइटोसिन (C) बेस की संख्या। |
| \(N_A\) | अनुक्रम में गिने गए एडिनिन (A) बेस की संख्या। |
| \(N_T\) | अनुक्रम में गिने गए थाइमिन (T) बेस की संख्या। |
| \(N_G + N_A + N_T + N_C\) | कुल मान्य बेस — हर। केवल स्पष्ट A, T, G और C वर्णों को गिना जाता है; अंतराल, स्थान, अंक, लाइन ब्रेक और FASTA शीर्षलेख पंक्तियां बाहर रखी जाती हैं, इसलिए अस्पष्टता कोड युक्त अनुक्रम का कुल इसके कच्चे वर्ण लंबाई से नीचे हो सकता है। |
शब्द
- एडिनिन (A) — एक प्यूरीन बेस; DNA में दो हाइड्रोजन बॉन्ड के माध्यम से थाइमिन के साथ जोड़ता है।
- थाइमिन (T) — DNA में पाया जाने वाला एक पाइरिमिडीन बेस; एडिनिन के साथ जोड़ता है।
- गुआनिन (G) — एक प्यूरीन बेस; तीन हाइड्रोजन बॉन्ड के माध्यम से साइटोसिन के साथ जोड़ता है।
- साइटोसिन (C) — एक पाइरिमिडीन बेस; गुआनिन के साथ जोड़ता है।
- बेस जोड़ी (bp) — डुप्लेक्स के दोनों किनारों पर एक A–T या G–C जोड़ी; यह भी DNA लंबाई की मानक इकाई है।
- पूरक किनारा — विरोधी किनारा जो प्रत्येक बेस को इसके साथी (A↔T, G↔C) से बदलकर और क्रम को उलट कर उत्पादित होता है। क्योंकि G हमेशा C के साथ जोड़ता है, एक अनुक्रम और इसके पूरक में समान GC सामग्री होती है — आप किसी भी किनारे से %GC की गणना कर सकते हैं और समान उत्तर प्राप्त कर सकते हैं।
- GC सामग्री (%GC) — सभी मान्य बेस का प्रतिशत जो G या C हैं, जैसा कि ऊपर दिए गए सूत्र द्वारा दिया गया है।
- AT सामग्री — केवल A, T, G और C युक्त अनुक्रमों के लिए पूरक मात्रा: \(\text{AT\%} = 100 - \text{GC\%}\)।
- पिघलने का तापमान (Tm) — वह तापमान जिस पर DNA डुप्लेक्स जनसंख्या का आधा एकल किनारों में अलग हो गया है। यह GC सामग्री के साथ बढ़ता है लेकिन लंबाई, नमक, एकाग्रता और अनुक्रम संदर्भ पर भी निर्भर करता है।
- PCR प्राइमर — एक संक्षिप्त सिंथेटिक ऑलिगोन्यूक्लिओटाइड (आमतौर पर लगभग 18–25 nt) जो एक टेम्पलेट में जुड़ता है और 3′ अंत प्रदान करता है जिससे एक पोलीमरेज़ विस्तार करता है। इसकी GC सामग्री और Tm दो संरचना गुण हैं जो डिज़ाइनर पहले जांचते हैं।
- आइसोकोर — जीनोमिक DNA का एक लंबा खिंचाव (सैकड़ों किलोबेस) अपेक्षाकृत एकसमान GC सामग्री के साथ जो पड़ोसी खिंचावों से भिन्न होता है। स्तनपायी जीनोम को क्लासिक रूप से ऐसे GC-गरीब और GC-समृद्ध क्षेत्रों के मोज़ेक के रूप में वर्णित किया जाता है।
- अस्पष्टता कोड N — "कोई भी बेस" के लिए IUPAC प्रतीक (A, C, G या T), जहां अनुक्रमण रीड अनिश्चित है या विधानसभा अंतराल गद्देदार है। अन्य IUPAC कोड जैसे R (A या G), Y (C या T) और W (A या T) एक ही तरह से काम करते हैं। क्योंकि एक N G, C, A या T हो सकता है, इसे स्कोर नहीं किया जा सकता और आमतौर पर अंश और हर दोनों से बाहर रखा जाता है — कई Ns के साथ गद्देदार अनुक्रम केवल हल किए गए बेस के लिए %GC की रिपोर्ट करेगा।
- यूरेसिल (U) — पाइरिमिडीन जो RNA में थाइमिन को बदल देता है; यह बिल्कुल T की तरह एडिनिन के साथ जोड़ता है। इसलिए GC सामग्री की गणना करने से पहले RNA अनुक्रम को उनके DNA फॉर्म में परिवर्तित किया जाना चाहिए (प्रत्येक U को T से बदलें), अन्यथा U वर्ण मान्य बेस के रूप में पहचाने नहीं जाते हैं और हर गलत है। ध्यान दें कि GC मान स्वयं प्रतिस्थापन से प्रभावित नहीं होता है, क्योंकि U AT सामग्री में योगदान देता है, GC सामग्री में नहीं।
अक्सर पूछे जाने वाले सवाल
GC कंटेंट क्यों मायने रखता है? यह DNA की स्थिरता और मेल्टिंग टेम्परेचर को प्रभावित करता है, जीन-समृद्ध क्षेत्रों की पहचान में मदद करता है, और प्राइमर डिज़ाइन करते समय काम आता है ताकि वे PCR के दौरान भरोसेमंद ढंग से बाइंड करें।
अमान्य अक्षरों का क्या होता है? N, U, गैप या व्हाइटस्पेस जैसे अक्षर अपने-आप हटा दिए जाते हैं। केवल A, T, G और C ही रखे और गिने जाते हैं, इसलिए पेस्ट किए गए सीक्वेंस में आए स्पेस आपके परिणाम को बिगाड़ेंगे नहीं।
क्या यह RNA सीक्वेंस स्वीकार करता है? कैलकुलेटर केवल DNA बेस (A, T, G, C) पहचानता है। RNA से आने वाला यूरेसिल (U) फ़िल्टर हो जाएगा, इसलिए सही परिणाम के लिए पहले U को T में बदल लें।