GC含量计算器有什么用
这款工具可以计算任意DNA序列的GC含量——也就是序列中属于鸟嘌呤(G)或胞嘧啶(C)的碱基所占的百分比。GC含量是分子生物学中的一项基础指标,常用于比较不同基因组、设计PCR引物,以及预测双链DNA的解链温度和稳定性。由于G–C碱基对之间由三个氢键连接(而A–T碱基对只有两个),因此G和C含量越高的序列,通常热稳定性也越好。
使用方法
- DNA序列:用字母A、T、G、C粘贴或输入你的序列。
- 输入不区分大小写——"atgc"和"ATGC"得到的结果完全相同。
- 凡是非A、T、G、C的字符(空格、数字、N、换行符等)都会在计算前被自动剔除,计算器还会告诉你共清除了多少个无效字符。
例如,输入ATGCATGCATGC就能立即得到对应的百分比。
计算公式
计算器会统计清理后序列中的G和C碱基数量,再除以有效碱基的总数:
$$\text{GC\%} = \frac{N_G + N_C}{N_G + N_A + N_T + N_C} \times 100$$
它还会用相同的逻辑、根据A和T的数量计算出互补的AT含量。如果序列中没有任何有效碱基,结果直接显示为0。
计算示例
以示例序列ATGCATGCATGC为例:
- 总碱基数 = 12
- G数量 = 3,C数量 = 3,因此GC数量 = 6
- GC含量 =(6 ÷ 12)× 100 = 50%
- AT数量 = 6,因此AT含量 = 50%
像这样均衡的序列,GC含量与AT含量是相等的。
常见生物的典型GC含量
基因组GC含量在生命之树上变化极大,从大约五分之一到近四分之三的所有碱基是G或C。下表列出了对已充分研究的参考生物体普遍引用的全基因组平均值。所有数字是从已发布参考组装中四舍五入得到的近似基因组范围内的平均值;确切值取决于菌株、分离株、组装版本,以及是否包含细胞器(线粒体、质体)和重复/未放置的序列。同一基因组内的单个基因、启动子、内含子和等置群可能偏离平均值20个百分点或更多,因此请将这些数字用作方向指引,而不是作为任何特定序列的目标。
| 生物体 | 基因组类型 | 约%GC | 为什么处于这个水平 |
|---|---|---|---|
| Plasmodium falciparum(疟原虫) | 核基因组,顶复门原虫 | ~19% | 已知最富含AT的基因组之一;极端AT偏好扩展到编码区域,使其序列的PCR和克隆极其困难。 |
| Dictyostelium discoideum(社会性黏菌) | 核基因组,阿米巴虫门 | ~22% | 富含AT,具有长的A和T同聚物链,使其原始组装变得复杂。 |
| Arabidopsis thaliana(拟南芥) | 核基因组,开花植物 | ~36% | 许多植物核基因组的典型特征;编码外显子的GC含量高于基因间序列平均值。 |
| Saccharomyces cerevisiae(酿酒酵母) | 核基因组,出芽酵母 | ~38% | 紧凑的、基因密集的真核生物基因组,具有中等富集AT的背景。 |
| Homo sapiens(人) | 核基因组,哺乳动物 | ~41% | GC贫乏和GC富集等置群的镶嵌体;富基因区域和CpG岛远高于基因组平均水平。 |
| Drosophila melanogaster(黑腹果蝇) | 核基因组,昆虫 | ~42% | 接近平衡的成分;异染色体和重复区域比真染色体富含AT。 |
| Escherichia coli K-12 | 环形细菌染色体 | ~50.8% | 经典的平衡成分参考基因组,这是为什么它是如此方便的克隆和表达宿主的部分原因。 |
| Mycobacterium tuberculosis H37Rv | 环形细菌染色体(放线菌) | ~65.6% | 像大多数放线菌一样富集GC;密码子使用在第三位置严重偏向G/C。 |
| Streptomyces coelicolor A3(2) | 线性细菌染色体(放线菌) | ~72% | 在常规处理的最富集GC的基因组中;扩增通常需要GC友好的缓冲液、DMSO或甜菜碱。 |
这种广泛的模式是真实和可重复的:专性细胞内寄生虫和一些自由生活的阿米巴和酵母趋向于富含AT,而放线菌和许多土壤细菌趋向于富集GC。潜在的原因存在争议,包括突变偏好、DNA修复机制差异,以及与生活方式和环境相关的选择。
关键术语和变量
公式中使用的变量
| 符号 | 含义 |
|---|---|
| \(N_G\) | 序列中计数的鸟嘌呤(G)碱基数。 |
| \(N_C\) | 序列中计数的胞嘧啶(C)碱基数。 |
| \(N_A\) | 序列中计数的腺嘌呤(A)碱基数。 |
| \(N_T\) | 序列中计数的胸腺嘧啶(T)碱基数。 |
| \(N_G + N_A + N_T + N_C\) | 总有效碱基——分母。仅计数明确的A、T、G和C字符;排除空隙、空格、数字、换行符和FASTA标题行,因此包含不确定代码的序列的总数可能低于其原始字符长度。 |
术语
- 腺嘌呤(A)——嘌呤碱基;在DNA中通过两个氢键与胸腺嘧啶配对。
- 胸腺嘧啶(T)——DNA中发现的嘧啶碱基;与腺嘌呤配对。
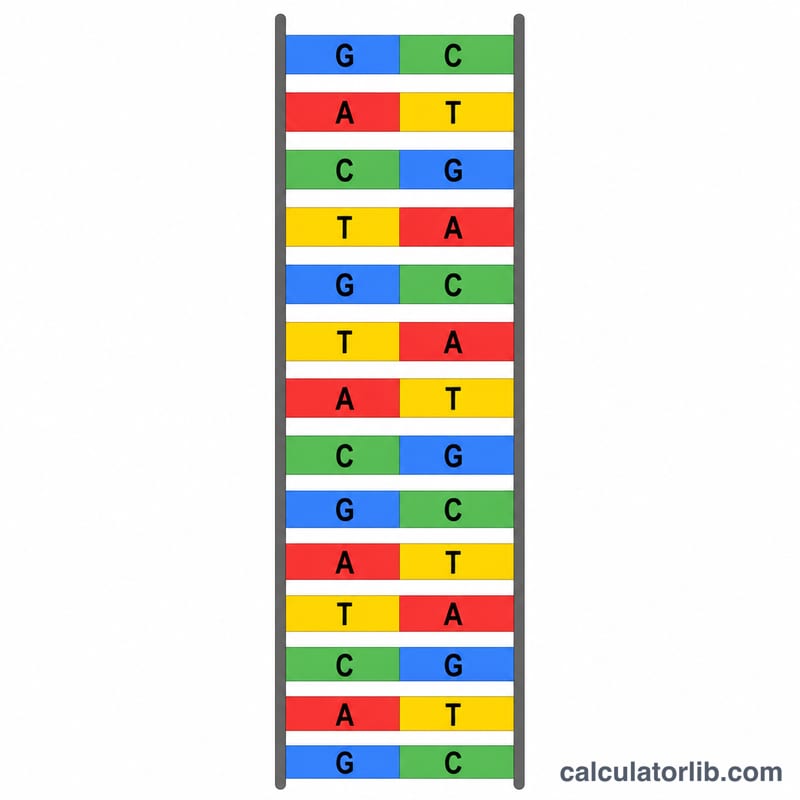
- 鸟嘌呤(G)——嘌呤碱基;通过三个氢键与胞嘧啶配对。
- 胞嘧啶(C)——嘧啶碱基;与鸟嘌呤配对。
- 碱基对(bp)——双链分子两条链上的一个A–T或G–C配对;也是DNA长度的标准单位。
- 互补链——通过将每个碱基替换为其配对碱基(A↔T、G↔C)并反转顺序生成的相对链。由于G总是与C配对,序列和其互补链具有相同的GC含量——您可以从任一链计算%GC并获得相同的答案。
- GC含量(%GC)——所有有效碱基中是G或C的百分比,如上式所示。
- AT含量——仅包含A、T、G和C的序列的互补量:\(\text{AT\%} = 100 - \text{GC\%}\)。
- 融解温度(Tm)——DNA双链群体中一半分离成单链的温度。它随GC含量增加而升高,但也取决于长度、盐浓度、浓度和序列背景。
- PCR引物——与模板退火的短合成寡核苷酸(通常约18–25 nt),并提供聚合酶延伸的3′端。其GC含量和Tm是设计者首先检查的两个成分特性。
- 等置群——具有相对均一GC含量的长基因组DNA片段(数百千碱基),与相邻片段不同。哺乳动物基因组经典上被描述为这样的GC贫乏和GC富集区域的镶嵌体。
- 不确定代码N——IUPAC符号表示"任何碱基"(A、C、G或T),用于测序读数不确定或组装间隙被填充的地方。其他IUPAC代码如R(A或G)、Y(C或T)和W(A或T)的工作方式相同。因为N可能是G、C、A或T,它无法被计数,通常从分子和分母中都被排除——用许多N填充的序列仅报告已解析碱基的%GC。
- 尿苷(U)——在RNA中替代胸腺嘧啶的嘧啶;它与腺嘌呤配对,就像T一样。因此,在计算GC含量之前,必须将RNA序列转换为其DNA形式(将每个U替换为T),否则U字符不会被识别为有效碱基,分母将是错误的。请注意,GC值本身不受替代的影响,因为U贡献于AT含量,而不是GC。
常见问题
GC含量为什么重要?它会影响DNA的稳定性和解链温度,有助于识别富含基因的区域,在设计引物时也至关重要——只有合适的GC含量才能保证引物在PCR过程中可靠结合。
无效字符会怎样处理?像N、U、空位或空白等字符会被自动删除,只保留并统计A、T、G、C。因此,粘贴序列时夹带的空格不会影响你的计算结果。
支持RNA序列吗?本计算器只识别DNA碱基(A、T、G、C)。RNA中的尿嘧啶(U)会被过滤掉,所以请先把U替换为T,才能得到准确的结果。