GC含量計算ツールでできること
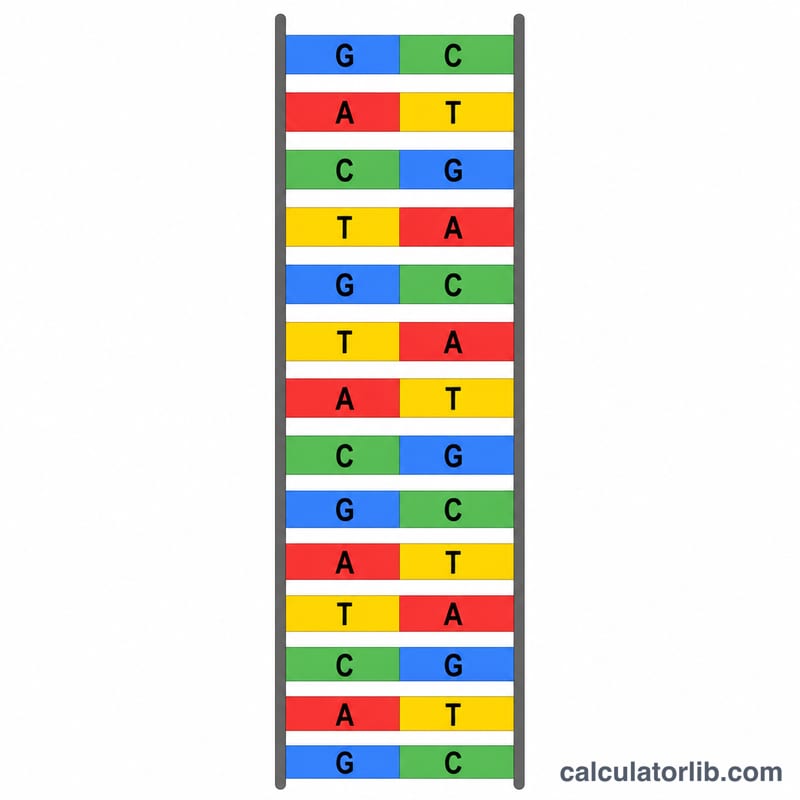
このツールは、任意のDNA配列のGC含量、すなわち塩基のうちグアニン(G)またはシトシン(C)が占める割合を計算します。GC含量は分子生物学における基本的な指標で、ゲノム同士の比較、PCRプライマーの設計、二本鎖DNAの融解温度(Tm)や安定性の予測などに広く使われています。G–C対は3本の水素結合で結ばれている(A–T対は2本)ため、GとCを多く含む配列ほど熱的に安定する傾向があります。
使い方
- DNA配列: A・T・G・Cの文字を使って、配列を貼り付けるか入力します。
- 入力は大文字・小文字を区別しません。「atgc」と「ATGC」は同じ結果になります。
- A・T・G・C以外の文字(スペース、数字、N、改行など)は計算前に自動的に除去され、いくつ無効な文字を取り除いたかも表示します。
例えばATGCATGCATGCと入力すれば、割合が即座に表示されます。
計算式
このツールは、整理後の配列に含まれるGとCの塩基数を数え、有効な塩基の総数で割って求めます。
$$\text{GC\%} = \frac{N_G + N_C}{N_G + N_A + N_T + N_C} \times 100$$
同じ考え方でAとTの数から、相補的なAT含量も算出します。有効な塩基が1つもない場合、結果は単純に0となります。
計算例
例として配列ATGCATGCATGCを使ってみましょう。
- 総塩基数 = 12
- Gの数 = 3、Cの数 = 3 なので、GCの数 = 6
- GC含量 $$=\left(\frac{6}{12}\right) \times 100 = \mathbf{50\%}$$
- ATの数 = 6 なので、AT含量 = 50%
このようにバランスの取れた配列では、GC含量とAT含量が等しくなります。
一般的な生物のGC含有量
ゲノムのGC含有量は生命の系統樹全体で非常に大きく異なり、すべての塩基のおよそ5分の1から4分の3近くがGまたはCである。下の表は、よく研究された参照生物で一般的に引用されるゲノム全体の平均値を列挙しています。すべての数値は公開されている参照アセンブリから四捨五入されたゲノム全体の概算平均値であり、正確な値は株、分離株、アセンブリバージョン、および細胞小器官(ミトコンドリア、プラスチド)および反復/未配置配列が含まれるかどうかに依存します。同じゲノム内の個々の遺伝子、プロモーター、イントロンおよびアイソコアは平均から20パーセントポイント以上逸脱する可能性があるため、これらの数値を特定の配列のターゲットではなく方向性として使用してください。
| 生物 | ゲノムタイプ | 約%GC | なぜそこに位置するのか |
|---|---|---|---|
| Plasmodium falciparum(マラリア原虫) | 核ゲノム、アピコンプレックス原虫 | ~19% | 既知の最もAT含有量の多いゲノムの1つです。極端なAT偏位はコード領域に広がり、そのシーケンスのPCRとクローニングを著しく困難にします。 |
| Dictyostelium discoideum(社会的アメーバ) | 核ゲノム、アメーバ動物門 | ~22% | 強くAT含有量が多く、AとTの長いホモポリマー領域が元のアセンブリを複雑にしました。 |
| Arabidopsis thaliana(シロイヌナズナ) | 核ゲノム、被子植物 | ~36% | 多くの植物核ゲノムに典型的です。コード領域のエキソンは遺伝子間領域の平均よりもGC含有量が多い。 |
| Saccharomyces cerevisiae(パン酵母) | 核ゲノム、出芽酵母 | ~38% | コンパクトで遺伝子密度が高い真核生物ゲノムで、背景は中程度のAT含有量が多いです。 |
| Homo sapiens(ヒト) | 核ゲノム、哺乳動物 | ~41% | GC含有量が低いアイソコアとGC含有量が多いアイソコアのモザイク。遺伝子が豊富な領域とCpG島はゲノム平均をはるかに上回っています。 |
| Drosophila melanogaster(ショウジョウバエ) | 核ゲノム、昆虫 | ~42% | ほぼバランスの取れた組成。ヘテロクロマチンと反復領域はユークロマチンよりもAT含有量が多いです。 |
| Escherichia coli K-12 | 円形細菌染色体 | ~50.8% | 古典的なバランスの取れた組成の参照ゲノムであり、これがクローニングと発現ホストとして非常に便利である理由の一つです。 |
| Mycobacterium tuberculosis H37Rv | 円形細菌染色体(放線菌) | ~65.6% | 大多数の放線菌のようにGC含有量が多い。コドン使用は第3位置でG/Cに大きく偏っています。 |
| Streptomyces coelicolor A3(2) | 線形細菌染色体(放線菌) | ~72% | 日常的に扱われるゲノムの中で最もGC含有量が多いゲノムの一つです。増幅には通常、GC適合バッファー、DMSOまたはベタインが必要です。 |
このパターンは実在し再現可能です。専従細胞内寄生虫と一部の自由生活アメーバと酵母はAT含有量が豊富になる傾向があり、放線菌と多くの土壌細菌はGC含有量が豊富になる傾向があります。基礎にある原因は議論中であり、変異バイアス、DNA修復機構の違い、およびライフスタイルと環境に関連する選択が含まれます。
主要な用語と変数
式で使用される変数
| 記号 | 意味 |
|---|---|
| \(N_G\) | 配列でカウントされたグアニン(G)塩基の数。 |
| \(N_C\) | 配列でカウントされたシトシン(C)塩基の数。 |
| \(N_A\) | 配列でカウントされたアデニン(A)塩基の数。 |
| \(N_T\) | 配列でカウントされたチミン(T)塩基の数。 |
| \(N_G + N_A + N_T + N_C\) | 有効な塩基の総数—分母。明確なA、T、GおよびC文字のみがカウントされます。ギャップ、スペース、数字、改行、およびFASTAヘッダー行は除外されるため、曖昧性コードを含む配列は生の文字長よりも低い総数を持つ可能性があります。 |
用語
- アデニン(A)—プリン塩基。DNAでは2つの水素結合を介してチミンと対を形成します。
- チミン(T)—DNAに含まれるピリミジン塩基。アデニンと対を形成します。
- グアニン(G)—プリン塩基。3つの水素結合を介してシトシンと対を形成します。
- シトシン(C)—ピリミジン塩基。グアニンと対を形成します。
- 塩基対(bp)—二重鎖の2本のストランドをまたいだ1つのA–TまたはG–C対合。また、DNA長の標準単位です。
- 相補鎖—各塩基をそのパートナー(A↔T、G↔C)に置き換え、順序を逆にすることによって生成される対向ストランド。Gは常にCと対を形成するため、シーケンスとその相補物は同じGC含有量を持つ—どちらのストランドからでも%GCを計算して同じ答えを得ることができます。
- GC含有量(%GC)—上記の式で与えられるように、GまたはCである有効な塩基すべてのパーセンテージ。
- AT含有量—A、T、GおよびCのみを含む配列の相補的な量:\(\text{AT\%} = 100 - \text{GC\%}\)。
- 融解温度(Tm)—DNA二重鎖集団の半分が単一鎖に分離する温度。GC含有量とともに上昇しますが、長さ、塩、濃度、およびシーケンスコンテキストにも依存します。
- PCRプライマー—テンプレートにアニールし、ポリメラーゼが伸長する3′末端を提供する短い合成オリゴヌクレオチド(通常約18–25 nt)。そのGC含有量とTmは、設計者が最初にチェックする2つの組成特性です。
- アイソコア—比較的均一なGC含有量を有するゲノムDNAの長い領域(数百キロ塩基)で、隣接する領域と異なります。哺乳動物ゲノムは古典的にそのようなGC含有量が低い領域とGC含有量が多い領域のモザイクとして説明されています。
- 曖昧性コードN—「任意の塩基」(A、C、GまたはT)のIUPACシンボル。配列決定読み取りが不確実な場所またはアセンブリギャップがパディングされている場所で使用されます。R(AまたはG)、Y(CまたはT)、W(AまたはT)などの他のIUPACコードも同じように機能します。NがG、C、AまたはTである可能性があるため、スコアリングすることはできず、通常は分子と分母の両方から除外されます—多くのNでパディングされた配列は、解決された塩基についてのみ%GCを報告します。
- ウラシル(U)—RNAでチミンに置き換わるピリミジン。Tがそうであるようにアデニンとペアを形成します。したがって、RNAシーケンスはGC含有量を計算する前に、DNA形式に変換されなければなりません(すべてのUをTに置き換える)。そうしないと、U文字は有効な塩基として認識されず、分母が間違っています。Uがアデニンと同じようにAT含有量ではなくGC含有量ではなく、GC値自体は置換の影響を受けないことに注意してください。
よくある質問
GC含量はなぜ重要なのですか? GC含量はDNAの安定性や融解温度に影響し、遺伝子が多い領域の特定にも役立ちます。また、PCRでプライマーが確実に結合するように設計する際にも利用されます。
無効な文字はどう処理されますか? N、U、ギャップ(欠失)、空白などの文字は自動的に除去されます。残してカウントするのはA・T・G・Cのみなので、貼り付けた配列に含まれるスペースが結果を狂わせる心配はありません。
RNA配列にも対応していますか? このツールが認識するのはDNA塩基(A・T・G・C)だけです。RNAのウラシル(U)は除去されてしまうため、正確に計算するには事前にUをTに変換してください。