Qué hace la calculadora de contenido GC
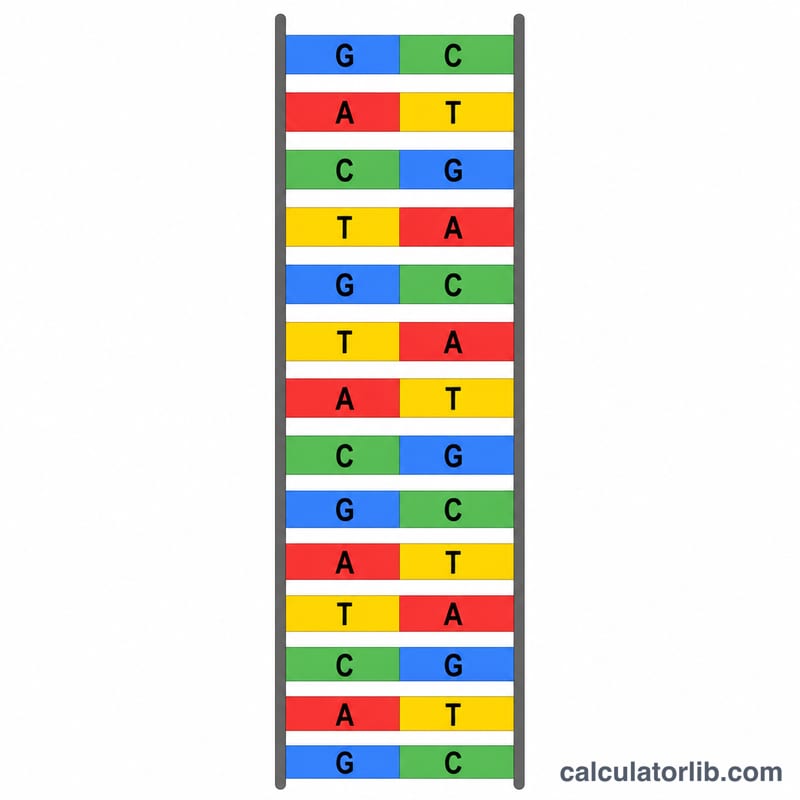
Esta herramienta calcula el contenido GC de cualquier secuencia de ADN, es decir, el porcentaje de bases que son guanina (G) o citosina (C). El contenido GC es una medida fundamental en biología molecular que se utiliza para comparar genomas, diseñar cebadores (primers) de PCR y predecir la temperatura de fusión y la estabilidad del ADN de doble cadena. Como los pares G–C están unidos por tres puentes de hidrógeno (frente a los dos de los pares A–T), las secuencias con más G y C suelen ser más estables térmicamente.
Cómo usarla
- Secuencia de ADN: pega o escribe tu secuencia usando las letras A, T, G y C.
- La entrada no distingue entre mayúsculas y minúsculas: «atgc» y «ATGC» dan el mismo resultado.
- Cualquier carácter que no sea A, T, G o C (espacios, números, N, saltos de línea) se elimina automáticamente antes del cálculo, y la calculadora te indica cuántos caracteres no válidos descartó.
Por ejemplo, al introducir ATGCATGCATGC obtienes el porcentaje al instante.
La fórmula
La calculadora cuenta las bases G y C de tu secuencia depurada y las divide entre el número total de bases válidas:
$$\text{GC\%} = \frac{N_G + N_C}{N_G + N_A + N_T + N_C} \times 100$$
También muestra el contenido AT complementario, aplicando la misma lógica con el recuento de A y T. Si no hay ninguna base válida, el resultado es simplemente 0.
Ejemplo resuelto
Tomemos la secuencia de ejemplo ATGCATGCATGC:
- Total de bases = 12
- Número de G = 3, número de C = 3, por lo que el recuento GC = 6
- Contenido GC = $$(6 \div 12) \times 100 = 50\,\%$$
- Recuento AT = 6, por lo que el contenido AT = 50 %
Una secuencia equilibrada como esta tiene el mismo contenido de GC y de AT.
Contenido GC Típico de Organismos Comunes
El contenido GC genómico varía enormemente en el árbol de la vida, desde aproximadamente una quinta parte hasta casi tres cuartas partes de todas las bases siendo G o C. La tabla siguiente lista promedios de todo el genoma comúnmente citados para organismos de referencia bien estudiados. Todas las cifras son promedios aproximados de todo el genoma redondeados de ensamblados de referencia publicados; el valor exacto depende de la cepa, aislado, versión del ensamblado, y de si se incluye la secuencia organelular (mitocondrial, plastidio) y repetitiva/no colocada. Los genes individuales, promotores, intrones e isocoras dentro del mismo genoma pueden desviarse del promedio en 20 puntos porcentuales o más, así que use estos números como orientación, no como un objetivo para ninguna secuencia en particular.
| Organismo | Tipo de genoma | GC% Aprox. | Por qué se sitúa allí |
|---|---|---|---|
| Plasmodium falciparum (parásito de la malaria) | Genoma nuclear, protozoo apicomplejos | ~19% | Uno de los genomas más ricos en AT conocidos; el sesgo extremo de AT se extiende a regiones codificantes y hace que la PCR y clonación de sus secuencias sea notoriamente difícil. |
| Dictyostelium discoideum (ameba social) | Genoma nuclear, amebozoo | ~22% | Fuertemente rico en AT, con largas secuencias de homopolímeros de A y T que complicaron su ensamblado original. |
| Arabidopsis thaliana (berro de Tálida) | Genoma nuclear, planta con flores | ~36% | Típico de muchos genomas nucleares de plantas; los exones codificantes son más ricos en GC que el promedio intergénico. |
| Saccharomyces cerevisiae (levadura de panadero) | Genoma nuclear, levadura gemante | ~38% | Genoma eucariota compacto y denso en genes con un fondo moderadamente rico en AT. |
| Homo sapiens (humano) | Genoma nuclear, mamífero | ~41% | Mosaico de isocoras pobres en GC y ricas en GC; las regiones ricas en genes e islas CpG están muy por encima del promedio del genoma. |
| Drosophila melanogaster (mosca de la fruta) | Genoma nuclear, insecto | ~42% | Composición casi equilibrada; las regiones heterocromáticas y repetitivas son más ricas en AT que la eucromatina. |
| Escherichia coli K-12 | Cromosoma bacteriano circular | ~50.8% | El genoma de referencia clásico de composición equilibrada, que es parte de por qué es un anfitrión de clonación y expresión tan conveniente. |
| Mycobacterium tuberculosis H37Rv | Cromosoma bacteriano circular (actinobacteria) | ~65.6% | Rico en GC como la mayoría de actinobacterias; el uso de codones está fuertemente sesgado hacia G/C en la tercera posición. |
| Streptomyces coelicolor A3(2) | Cromosoma bacteriano lineal (actinobacteria) | ~72% | Entre los genomas más ricos en GC trabajados rutinariamente; la amplificación generalmente necesita amortiguadores favorables a GC, DMSO o betaína. |
El patrón general es real y repetible: los parásitos intracelulares obligados y algunas amebas de vida libre y levaduras tienden a ser ricos en AT, mientras que las actinobacterias y muchas bacterias del suelo tienden a ser ricas en GC. Las causas subyacentes son debatidas e incluyen sesgo mutacional, diferencias en la maquinaria de reparación del ADN, y selección relacionada con el estilo de vida y el ambiente.
Términos Clave y Variables
Variables utilizadas en la fórmula
| Símbolo | Significado |
|---|---|
| \(N_G\) | Número de bases de guanina (G) contadas en la secuencia. |
| \(N_C\) | Número de bases de citosina (C) contadas en la secuencia. |
| \(N_A\) | Número de bases de adenina (A) contadas en la secuencia. |
| \(N_T\) | Número de bases de timina (T) contadas en la secuencia. |
| \(N_G + N_A + N_T + N_C\) | Bases válidas totales — el denominador. Solo se cuentan caracteres inequívocos A, T, G y C; se excluyen espacios, dígitos, saltos de línea y líneas de encabezado FASTA, por lo que una secuencia que contiene códigos de ambigüedad puede tener un total por debajo de su longitud de carácter bruto. |
Términos
- Adenina (A) — una base púrica; se empareja con timina en el ADN mediante dos enlaces de hidrógeno.
- Timina (T) — una base pirimidínica encontrada en el ADN; se empareja con adenina.
- Guanina (G) — una base púrica; se empareja con citosina mediante tres enlaces de hidrógeno.
- Citosina (C) — una base pirimidínica; se empareja con guanina.
- Par de bases (bp) — un emparejamiento A–T o G–C en las dos cadenas de un dúplex; también la unidad estándar de longitud de ADN.
- Cadena complementaria — la cadena opuesta producida reemplazando cada base con su pareja (A↔T, G↔C) e invirtiendo el orden. Porque G siempre se empareja con C, una secuencia y su complemento tienen contenido GC idéntico — puedes calcular %GC de cualquiera de las cadenas y obtener la misma respuesta.
- Contenido GC (%GC) — el porcentaje de todas las bases válidas que son G o C, como se indica en la fórmula anterior.
- Contenido AT — la cantidad complementaria para secuencias que contienen solo A, T, G y C: \(\text{AT\%} = 100 - \text{GC\%}\).
- Temperatura de fusión (Tm) — la temperatura a la cual la mitad de una población de dúplex de ADN se ha separado en cadenas individuales. Aumenta con el contenido de GC pero también depende de la longitud, sal, concentración y contexto de secuencia.
- Cebador PCR — un oligonucleótido sintético corto (comúnmente alrededor de 18–25 nt) que se hibrida con un molde y proporciona el extremo 3′ desde el cual una polimerasa se extiende. Su contenido de GC y Tm son las dos propiedades de composición que los diseñadores verifican primero.
- Isocora — un tramo largo de ADN genómico (cientos de kilobases) con un contenido de GC relativamente uniforme que difiere de tramos vecinos. Los genomas de mamíferos se describen clásicamente como un mosaico de tales regiones pobres en GC y ricas en GC.
- Código de ambigüedad N — el símbolo IUPAC para "cualquier base" (A, C, G o T), usado donde una lectura de secuenciación es incierta o un hueco de ensamblado se rellena. Otros códigos IUPAC como R (A o G), Y (C o T) y W (A o T) funcionan de la misma manera. Porque una N podría ser G, C, A o T, no puede ser puntuada y normalmente se excluye tanto del numerador como del denominador — una secuencia rellenada con muchas Ns reportará %GC solo para las bases resueltas.
- Uracilo (U) — la pirimidina que reemplaza a la timina en el ARN; se empareja con adenina como lo hace T. Las secuencias de ARN deben convertirse a su forma de ADN (reemplazar cada U con T) antes de calcular el contenido de GC, de lo contrario los caracteres U no se reconocen como bases válidas y el denominador es incorrecto. Tenga en cuenta que el valor de GC en sí no se ve afectado por la sustitución, ya que U contribuye al contenido de AT, no a GC.
Preguntas frecuentes
¿Por qué importa el contenido GC? Influye en la estabilidad del ADN y en su temperatura de fusión, ayuda a identificar regiones ricas en genes y resulta clave al diseñar cebadores para que se unan de forma fiable durante la PCR.
¿Qué ocurre con los caracteres no válidos? Letras como la N o la U, los huecos y los espacios se eliminan automáticamente. Solo se conservan y se cuentan las bases A, T, G y C, de modo que los espacios de una secuencia pegada no alteran tu resultado.
¿Acepta secuencias de ARN? La calculadora solo reconoce las bases del ADN (A, T, G, C). El uracilo (U) del ARN se filtraría, así que conviértelo en T antes de calcular para obtener una lectura precisa.