GC İçeriği Hesaplama Aracı Ne İşe Yarar?
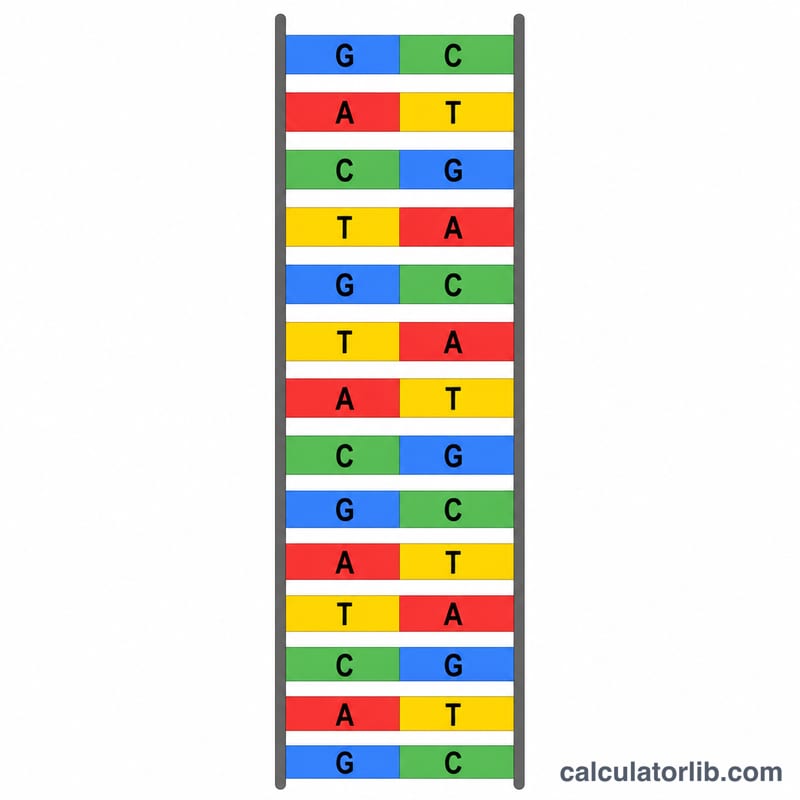
Bu araç, herhangi bir DNA dizisinin GC içeriğini hesaplar; yani guanin (G) veya sitozin (C) olan bazların yüzdesini verir. GC içeriği, moleküler biyolojide genomları karşılaştırmak, PCR primerleri tasarlamak ve çift sarmallı DNA'nın erime sıcaklığı ile kararlılığını öngörmek için kullanılan temel bir ölçüttür. G–C eşleşmeleri üç hidrojen bağıyla birbirine bağlandığından (A–T eşleşmelerinde ise iki bağ vardır), G ve C bakımından zengin diziler genellikle ısıl açıdan daha kararlıdır.
Nasıl Kullanılır?
- DNA Dizisi: Dizinizi A, T, G ve C harflerini kullanarak yapıştırın veya yazın.
- Giriş büyük/küçük harfe duyarlı değildir — "atgc" ile "ATGC" aynı sonucu verir.
- A, T, G veya C dışındaki karakterler (boşluklar, rakamlar, N harfi, satır sonları) hesaplamadan önce otomatik olarak temizlenir ve araç kaç geçersiz karakter çıkardığını size bildirir.
Örneğin ATGCATGCATGC girdiğinizde anında bir yüzde elde edersiniz.
Formül
Araç, temizlenmiş dizinizdeki G ve C bazlarını sayar ve bunu toplam geçerli baz sayısına böler:
$$\text{GC İçeriği (\%)} = \frac{N_G + N_C}{N_G + N_A + N_T + N_C} \times 100$$Aynı mantıkla A ve T sayılarını kullanarak tamamlayıcı AT içeriğini de hesaplar. Geçerli baz bulunmazsa sonuç basitçe 0 olur.
Örnek Hesaplama
Örnek dizi olarak ATGCATGCATGC ele alalım:
- Toplam baz = 12
- G sayısı = 3, C sayısı = 3, dolayısıyla GC sayısı = 6
- GC İçeriği = \((6 \div 12) \times 100 = \) %50
- AT sayısı = 6, dolayısıyla AT İçeriği = %50
Bunun gibi dengeli bir dizide GC ve AT içeriği eşittir.
Yaygın Organizmaların Tipik GC İçeriği
Genomik GC içeriği, yaşam ağacı boyunca büyük ölçüde değişir; tüm bazların kabaca beşte biri ile üçte dörde yakını G veya C olabilir. Aşağıdaki tablo, iyi çalışılmış referans organizmalar için yaygın olarak alıntı yapılan tüm genom ortalamaları listeler. Tüm rakamlar yayınlanmış referans dizilerinden yuvarlanmış yaklaşık genom çapında ortalamalardır; kesin değer suşa, izolataya, derleme sürümüne ve organelsel (mitokondriyal, plastid) ve tekrarlanan/yerleştirilmemiş sekansın dahil olup olmadığına bağlıdır. Aynı genomdaki bireysel genler, promoterler, intronlar ve isokhorlar ortalamadan 20 yüzde puan veya daha fazla sapabilir, bu nedenle bu sayıları belirli bir sekans için bir hedef olarak değil, yönelim olarak kullanın.
| Organizma | Genom türü | Yakl. %GC | Neden burada konumlanır |
|---|---|---|---|
| Plasmodium falciparum (sıtma paraziti) | Nükleer genom, apikomplekan protozoon | ~19% | Bilinen en AT yüksek genomlarından biri; aşırı AT yanlılığı kodlama bölgelerine uzanır ve sekanslarının PCR ve klonlanmasını kötü ünlü derecede zor hale getirir. |
| Dictyostelium discoideum (sosyal ameba) | Nükleer genom, amebozoan | ~22% | Güçlü şekilde AT yüksek, orijinal derlemesini karmaşık hale getiren A ve T'nin uzun homopoimer izleriyle. |
| Arabidopsis thaliana (Arabidopsis) | Nükleer genom, çiçekli bitki | ~36% | Birçok bitki nükleer genomu için tipiktir; kodlama eksonları, intergenik ortalamasından daha GC yüksektir. |
| Saccharomyces cerevisiae (fırıncı mayası) | Nükleer genom, tomurcuklanan maya | ~38% | Kompakt, gen yoğun ökaryotik genom, ölçülü şekilde AT yüksek arka planla. |
| Homo sapiens (insan) | Nükleer genom, memeli | ~41% | GC fakir ve GC zengin isokhorların mozaiği; gen açısından zengin bölgeler ve CpG adaları genom ortalamasının çok üzerindedir. |
| Drosophila melanogaster (meyve sineği) | Nükleer genom, böcek | ~42% | Yakın dengeli bileşim; heterokromatik ve tekrarlanan bölgeler, ökromatinden daha AT yüksektir. |
| Escherichia coli K-12 | Dairesel bakteri kromozomu | ~50.8% | Klasik dengeli bileşim referans genomu, bunun bu kadar uygun bir klonlama ve ekspresyon konağı olmasının nedeninin bir parçasıdır. |
| Mycobacterium tuberculosis H37Rv | Dairesel bakteri kromozomu (aktinobakteri) | ~65.6% | Çoğu aktinobakteri gibi GC yüksek; kodon kullanımı üçüncü pozisyonda G/C doğru ağır şekilde çarpıktır. |
| Streptomyces coelicolor A3(2) | Doğrusal bakteri kromozomu (aktinobakteri) | ~72% | Rutin olarak çalışılan en GC zengin genomlar arasında; amplifikasyon genellikle GC uyumlu tamponlar, DMSO veya betain gerektirir. |
Geniş desen gerçek ve tekrarlanabilir: zorunlu hücre içi parazitler ve bazı serbest yaşayan amebalar ve mayalar AT yüksek eğilim gösterirken, aktinobakteriler ve birçok toprak bakteri GC yüksek eğilim gösterir. Temel nedenler tartışmalıdır ve mutasyonel yanlılık, DNA onarım sistemi farklılıkları ve yaşam tarzı ve çevre ile ilgili seçimi içerir.
Anahtar Terimler ve Değişkenler
Formülde kullanılan değişkenler
| Sembol | Anlamı |
|---|---|
| \(N_G\) | Sekansda sayılan guanin (G) bazlarının sayısı. |
| \(N_C\) | Sekansda sayılan sitozin (C) bazlarının sayısı. |
| \(N_A\) | Sekansda sayılan adenin (A) bazlarının sayısı. |
| \(N_T\) | Sekansda sayılan timin (T) bazlarının sayısı. |
| \(N_G + N_A + N_T + N_C\) | Toplam geçerli bazlar — payda. Yalnızca belirsiz olmayan A, T, G ve C karakterleri sayılır; boşluklar, alanlar, rakamlar, satır sonları ve FASTA başlık satırları hariç tutulur, bu nedenle belirsizlik kodları içeren bir sekans, ham karakter uzunluğunun altında bir toplama sahip olabilir. |
Terimler
- Adenin (A) — bir pürin baz; DNA'da timin ile iki hidrojen bağı aracılığıyla eşleşir.
- Timin (T) — DNA'da bulunan bir pirimidin bazı; adenin ile eşleşir.
- Guanin (G) — bir pürin baz; sitozin ile üç hidrojen bağı aracılığıyla eşleşir.
- Sitozin (C) — bir pirimidin bazı; guanin ile eşleşir.
- Baz çifti (bp) — bir dubleks'in iki ipliği boyunca bir A–T veya G–C eşleşmesi; ayrıca DNA uzunluğunun standart birimi.
- Tamamlayıcı iplik — her bazı ortağı ile değiştirerek (A↔T, G↔C) ve sırayı ters çevirerek üretilen karşıt iplik. G her zaman C ile eşleştiği için, bir sekans ve tamamlayıcısı aynı GC içeriğine sahiptir — %GC'yi herhangi bir iplikten hesaplayabilir ve aynı cevabı alabilirsiniz.
- GC içeriği (%GC) — yukarıda verilen formülün verdiği G veya C olan tüm geçerli bazların yüzdesi.
- AT içeriği — yalnızca A, T, G ve C içeren sekanslar için tamamlayıcı nicelik: \(\text{AT\%} = 100 - \text{GC\%}\).
- Erime sıcaklığı (Tm) — DNA dubleks popülasyonunun yarısının tek ipliğe ayrıldığı sıcaklık. GC içeriği ile artar ancak uzunluk, tuz, konsantrasyon ve sekans bağlamına da bağlıdır.
- PCR primeri — bir şablona tavlanan ve bir polimerazın uzattığı 3′ ucunu sağlayan kısa bir sentetik oligonükleotid (yaygın olarak yaklaşık 18–25 nt). GC içeriği ve Tm, tasarımcıların ilk kontrol ettiği iki bileşim özelliğidir.
- İsokhor — komşu bölümlerden farklı, nispeten eşit bir GC içeriğine sahip uzun bir genomik DNA bölümü (yüzlerce kilobaz). Memeli genomlar, klasik olarak bu tür GC fakir ve GC zengin bölgelerin mozaiği olarak tanımlanır.
- Belirsizlik kodu N — "herhangi bir baz" (A, C, G veya T) için IUPAC sembolü, bir sekans okuması belirsiz olduğunda veya bir derleme açığı doldurulduğunda kullanılır. R (A veya G), Y (C veya T) ve W (A veya T) gibi diğer IUPAC kodları aynı şekilde çalışır. Bir N, G, C, A veya T olabildiği için, puanlanamaz ve normalde hem paydan hem paydadan hariç tutulur — birçok N ile doldurulmuş bir sekans, %GC'yi yalnızca çözülen bazlar için rapor verir.
- Ürasil (U) — RNA'da timini değiştiren pirimidin; adenin ile T gibi eşleşir. RNA sekansları, bu nedenle GC içeriği hesaplanmadan önce DNA biçimlerine dönüştürülmelidir (her U'yu T ile değiştirin), aksi takdirde U karakterleri geçerli bazlar olarak tanınmaz ve payda yanlıştır. GC değerinin kendisinin, U GC'ye değil AT içeriğine katkıda bulunduğundan, ikame tarafından etkilenmediğini unutmayın.
Sıkça Sorulan Sorular
GC içeriği neden önemlidir? DNA'nın kararlılığını ve erime sıcaklığını etkiler, gen bakımından zengin bölgeleri belirlemeye yardımcı olur ve PCR sırasında primerlerin güvenilir biçimde bağlanması için tasarımlarında kullanılır.
Geçersiz karakterlere ne olur? N, U, boşluk gibi harfler ve aralıklar otomatik olarak çıkarılır. Yalnızca A, T, G ve C tutulup sayıldığından, yapıştırdığınız dizilerdeki boşluklar sonucunuzu bozmaz.
RNA dizilerini kabul eder mi? Araç yalnızca DNA bazlarını (A, T, G, C) tanır. RNA'daki urasil (U) filtrelenip atılır; bu nedenle doğru bir sonuç için önce U'ları T'ye çevirin.