Was der GC-Gehalt-Rechner leistet
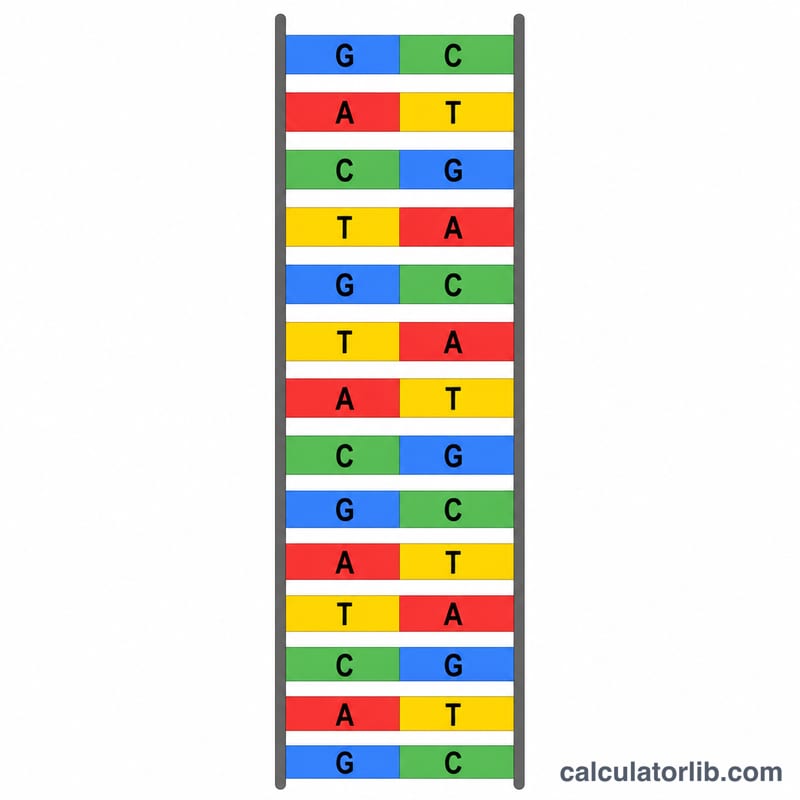
Dieses Tool berechnet den GC-Gehalt einer beliebigen DNA-Sequenz – den prozentualen Anteil der Basen, die entweder Guanin (G) oder Cytosin (C) sind. Der GC-Gehalt ist eine grundlegende Kenngröße der Molekularbiologie: Er wird zum Vergleich von Genomen, zum Entwurf von PCR-Primern sowie zur Vorhersage der Schmelztemperatur und Stabilität doppelsträngiger DNA verwendet. Da G–C-Paare durch drei Wasserstoffbrücken verbunden sind (A–T-Paare dagegen durch zwei), sind Sequenzen mit einem höheren G- und C-Anteil in der Regel thermisch stabiler.
So verwenden Sie den Rechner
- DNA-Sequenz: Fügen Sie Ihre Sequenz ein oder geben Sie sie mit den Buchstaben A, T, G und C ein.
- Die Eingabe unterscheidet nicht zwischen Groß- und Kleinschreibung – „atgc“ und „ATGC“ liefern dasselbe Ergebnis.
- Alle Zeichen, die nicht A, T, G oder C sind (Leerzeichen, Zahlen, N, Zeilenumbrüche), werden vor der Berechnung automatisch entfernt. Der Rechner gibt an, wie viele ungültige Zeichen er entfernt hat.
Wenn Sie beispielsweise ATGCATGCATGC eingeben, erhalten Sie sofort einen Prozentwert.
Die Formel
Der Rechner zählt die G- und C-Basen in Ihrer bereinigten Sequenz und teilt durch die Gesamtzahl der gültigen Basen:
$$\text{GC\%} = \frac{N_G + N_C}{N_G + N_A + N_T + N_C} \times 100$$
Außerdem gibt er den komplementären AT-Gehalt an, nach derselben Logik mit den Anzahlen von A und T. Sind keine gültigen Basen vorhanden, lautet das Ergebnis schlicht 0.
Rechenbeispiel
Nehmen wir die Beispielsequenz ATGCATGCATGC:
- Gesamtzahl der Basen = 12
- Anzahl G = 3, Anzahl C = 3, also GC-Anzahl = 6
- GC-Gehalt = $$(6 \div 12) \times 100 = 50\%$$ 50%
- AT-Anzahl = 6, also AT-Gehalt = 50%
Eine ausgewogene Sequenz wie diese hat einen gleich hohen GC- und AT-Gehalt.
Typischer GC-Gehalt häufiger Organismen
Der genomische GC-Gehalt variiert im Stammbaum des Lebens enorm: Von etwa einem Fünftel bis zu fast drei Vierteln aller Basen sind G oder C. Die folgende Tabelle listet häufig angegebene Durchschnittswerte ganzer Genome gut untersuchter Referenzorganismen auf. Alle Angaben sind ungefähre genomweite Durchschnittswerte, gerundet aus veröffentlichten Referenzassemblies; der genaue Wert hängt vom Stamm, vom Isolat, von der Assembly-Version und davon ab, ob organelleigene (mitochondriale, plastidäre) sowie repetitive/nicht zugeordnete Sequenzen einbezogen sind. Einzelne Gene, Promotoren, Introns und Isochoren innerhalb desselben Genoms können um 20 Prozentpunkte oder mehr vom Durchschnitt abweichen. Verstehen Sie diese Zahlen daher als Orientierung und nicht als Zielwert für eine bestimmte Sequenz.
| Organismus | Genomtyp | Ca. %GC | Warum der Wert so liegt |
|---|---|---|---|
| Plasmodium falciparum (Malariaerreger) | Kerngenom, apikomplexer Einzeller | ~19% | Eines der AT-reichsten bekannten Genome; die extreme AT-Verzerrung reicht bis in die codierenden Bereiche und macht PCR und Klonierung seiner Sequenzen bekanntermaßen schwierig. |
| Dictyostelium discoideum (soziale Amöbe) | Kerngenom, Amoebozoon | ~22% | Stark AT-reich, mit langen Homopolymer-Abschnitten aus A und T, die die ursprüngliche Assemblierung erschwerten. |
| Arabidopsis thaliana (Acker-Schmalwand) | Kerngenom, Blütenpflanze | ~36% | Typisch für viele pflanzliche Kerngenome; codierende Exons sind GC-reicher als der intergene Durchschnitt. |
| Saccharomyces cerevisiae (Bäckerhefe) | Kerngenom, Sprosshefe | ~38% | Kompaktes, genreiches eukaryotisches Genom mit mäßig AT-reichem Hintergrund. |
| Homo sapiens (Mensch) | Kerngenom, Säugetier | ~41% | Mosaik aus GC-armen und GC-reichen Isochoren; genreiche Regionen und CpG-Inseln liegen weit über dem Genomdurchschnitt. |
| Drosophila melanogaster (Fruchtfliege) | Kerngenom, Insekt | ~42% | Nahezu ausgewogene Zusammensetzung; heterochromatische und repetitive Regionen sind AT-reicher als das Euchromatin. |
| Escherichia coli K-12 | Zirkuläres bakterielles Chromosom | ~50,8% | Das klassische Referenzgenom mit ausgewogener Zusammensetzung – mit ein Grund, warum es ein so praktischer Klonierungs- und Expressionswirt ist. |
| Mycobacterium tuberculosis H37Rv | Zirkuläres bakterielles Chromosom (Actinobakterium) | ~65,6% | GC-reich wie die meisten Actinobakterien; die Codon-Nutzung ist an der dritten Position stark zu G/C verschoben. |
| Streptomyces coelicolor A3(2) | Lineares bakterielles Chromosom (Actinobakterium) | ~72% | Eines der GC-reichsten Genome, mit denen routinemäßig gearbeitet wird; für die Amplifikation sind meist GC-taugliche Puffer, DMSO oder Betain nötig. |
Das grobe Muster ist real und reproduzierbar: Obligat intrazelluläre Parasiten sowie einige freilebende Amöben und Hefen tendieren zu AT-reichen Genomen, während Actinobakterien und viele Bodenbakterien zu GC-reichen Genomen tendieren. Die zugrunde liegenden Ursachen sind umstritten; dazu zählen Mutationsverzerrungen, Unterschiede in der DNA-Reparaturmaschinerie sowie Selektion im Zusammenhang mit Lebensweise und Umwelt.
Wichtige Begriffe und Variablen
In der Formel verwendete Variablen
| Symbol | Bedeutung |
|---|---|
| \(N_G\) | Anzahl der in der Sequenz gezählten Guanin-Basen (G). |
| \(N_C\) | Anzahl der in der Sequenz gezählten Cytosin-Basen (C). |
| \(N_A\) | Anzahl der in der Sequenz gezählten Adenin-Basen (A). |
| \(N_T\) | Anzahl der in der Sequenz gezählten Thymin-Basen (T). |
| \(N_G + N_A + N_T + N_C\) | Gesamtzahl der gültigen Basen – der Nenner. Gezählt werden nur eindeutige Zeichen A, T, G und C; Lücken, Leerzeichen, Ziffern, Zeilenumbrüche und FASTA-Kopfzeilen werden ausgeschlossen. Eine Sequenz mit Mehrdeutigkeitscodes kann daher eine Gesamtzahl unterhalb ihrer tatsächlichen Zeichenlänge haben. |
Begriffe
- Adenin (A) – eine Purinbase; paart sich in der DNA über zwei Wasserstoffbrücken mit Thymin.
- Thymin (T) – eine in der DNA vorkommende Pyrimidinbase; paart sich mit Adenin.
- Guanin (G) – eine Purinbase; paart sich über drei Wasserstoffbrücken mit Cytosin.
- Cytosin (C) – eine Pyrimidinbase; paart sich mit Guanin.
- Basenpaar (bp) – eine A–T- oder G–C-Paarung zwischen den beiden Strängen eines Doppelstrangs; zugleich die Standardeinheit für die DNA-Länge.
- Komplementärstrang – der gegenüberliegende Strang, der entsteht, indem jede Base durch ihren Partner ersetzt (A↔T, G↔C) und die Reihenfolge umgekehrt wird. Da G stets mit C paart, haben eine Sequenz und ihr Komplement denselben GC-Gehalt – Sie können den GC-Gehalt von beiden Strängen aus berechnen und erhalten dasselbe Ergebnis.
- GC-Gehalt (%GC) – der prozentuale Anteil aller gültigen Basen, die G oder C sind, gemäß der obigen Formel.
- AT-Gehalt – die komplementäre Größe für Sequenzen, die nur A, T, G und C enthalten: \(\text{AT\%} = 100 - \text{GC\%}\).
- Schmelztemperatur (Tm) – die Temperatur, bei der die Hälfte einer DNA-Doppelstrang-Population in Einzelstränge getrennt vorliegt. Sie steigt mit dem GC-Gehalt, hängt aber auch von Länge, Salzgehalt, Konzentration und Sequenzkontext ab.
- PCR-Primer – ein kurzes synthetisches Oligonukleotid (üblicherweise etwa 18–25 nt), das an eine Matrize bindet und das 3′-Ende bereitstellt, von dem aus eine Polymerase verlängert. Sein GC-Gehalt und seine Tm sind die beiden Zusammensetzungseigenschaften, die beim Design zuerst geprüft werden.
- Isochore – ein langer Abschnitt genomischer DNA (mehrere hundert Kilobasen) mit relativ einheitlichem GC-Gehalt, der sich von benachbarten Abschnitten unterscheidet. Säugetiergenome werden klassisch als Mosaik solcher GC-armer und GC-reicher Regionen beschrieben.
- Mehrdeutigkeitscode N – das IUPAC-Symbol für „beliebige Base“ (A, C, G oder T), das verwendet wird, wenn ein Sequenzierungs-Read unsicher ist oder eine Assemblierungslücke aufgefüllt wird. Andere IUPAC-Codes wie R (A oder G), Y (C oder T) und W (A oder T) funktionieren entsprechend. Da ein N G, C, A oder T sein könnte, lässt es sich nicht bewerten und wird normalerweise sowohl aus dem Zähler als auch aus dem Nenner ausgeschlossen – bei einer Sequenz mit vielen N wird der GC-Gehalt nur für die aufgelösten Basen angegeben.
- Uracil (U) – das Pyrimidin, das in der RNA Thymin ersetzt; es paart sich ebenso wie T mit Adenin. RNA-Sequenzen müssen daher vor der Berechnung des GC-Gehalts in ihre DNA-Form umgewandelt werden (jedes U durch T ersetzen). Andernfalls werden die U-Zeichen nicht als gültige Basen erkannt und der Nenner stimmt nicht. Beachten Sie, dass der GC-Wert selbst durch die Ersetzung nicht verändert wird, da U zum AT-Gehalt beiträgt, nicht zum GC-Gehalt.
Häufig gestellte Fragen
Warum ist der GC-Gehalt wichtig? Er beeinflusst die DNA-Stabilität und die Schmelztemperatur, hilft dabei, genreiche Regionen zu erkennen, und wird beim Primer-Design berücksichtigt, damit die Primer bei der PCR zuverlässig binden.
Was geschieht mit ungültigen Zeichen? Buchstaben wie N, U, Lücken oder Leerraum werden automatisch entfernt. Nur A, T, G und C werden beibehalten und gezählt, sodass Leerzeichen in eingefügten Sequenzen Ihr Ergebnis nicht verfälschen.
Werden RNA-Sequenzen akzeptiert? Der Rechner erkennt nur DNA-Basen (A, T, G, C). Uracil (U) aus RNA würde herausgefiltert; wandeln Sie U daher zuerst in T um, um einen korrekten Wert zu erhalten.