GC含量計算器的功能
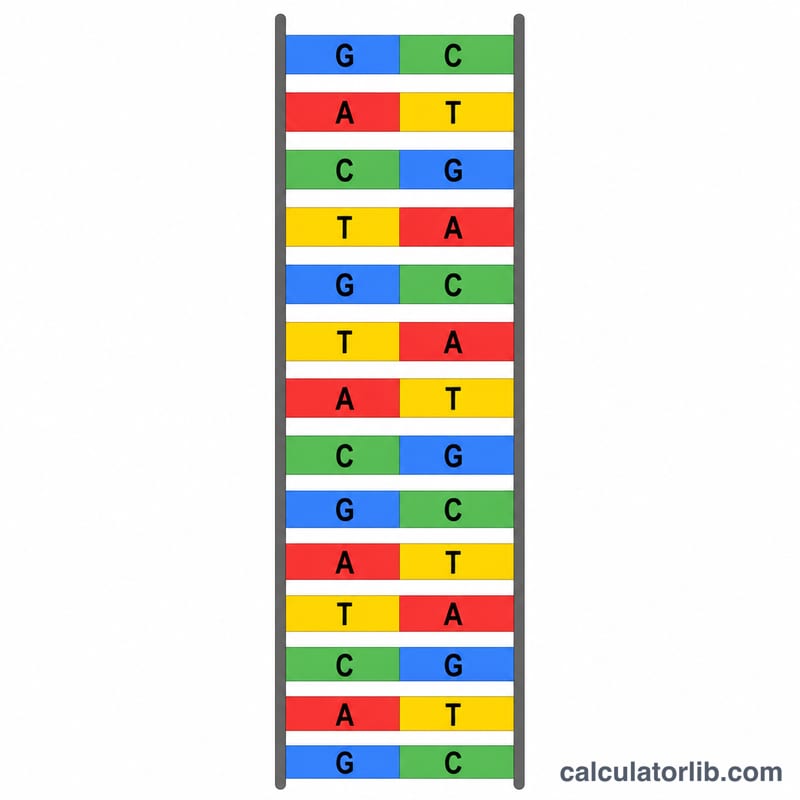
這個工具可以計算任何DNA序列的GC含量,也就是序列中屬於鳥嘌呤(G)或胞嘧啶(C)的鹼基所佔的百分比。GC含量是分子生物學中的基本指標,常用於比較不同基因組、設計PCR引子,以及預測雙股DNA的解鏈溫度與穩定性。由於G–C配對之間有三個氫鍵(A–T配對則只有兩個),G與C比例較高的序列通常具有更佳的熱穩定性。
使用方法
- DNA序列:貼上或輸入您的序列,使用 A、T、G、C 這四個字母即可。
- 輸入不分大小寫,「atgc」與「ATGC」會得到相同的結果。
- 凡是非 A、T、G、C 的字元(空格、數字、N、換行等)都會在計算前自動移除,計算器並會顯示總共清除了多少個無效字元。
例如輸入 ATGCATGCATGC,即可立即得到百分比結果。
計算公式
計算器會統計清理後序列中的 G 與 C 鹼基數量,再除以有效鹼基總數:
$$\text{GC含量(\%)} = \frac{N_G + N_C}{N_G + N_A + N_T + N_C} \times 100$$
它同時也會以相同邏輯,用 A 與 T 的數量計算出對應的 AT 含量。若序列中沒有任何有效鹼基,結果則為 0。
計算範例
以範例序列 ATGCATGCATGC 為例:
- 鹼基總數 = 12
- G數量 = 3,C數量 = 3,因此 GC數量 = 6
- GC含量 = $$\left(\frac{6}{12}\right) \times 100 = \textbf{50\%}$$
- AT數量 = 6,因此 AT含量 = 50%
像這樣均衡的序列,GC含量與AT含量恰好相等。
常見生物的典型GC含量
基因組GC含量在整個生命樹中差異巨大,從大約五分之一到將近四分之三的所有鹼基為G或C。下表列出了對於研究良好的參考生物常引用的全基因組平均值。所有數據是從已發佈的參考組裝中四捨五入的近似基因組範圍平均值;確切值取決於菌株、分離株、組裝版本,以及是否包含細胞器(線粒體、質體)和重複/未定位序列。同一基因組內的單個基因、啟動子、內含子和等亞基因組可以從平均值偏離20個百分點或更多,因此請使用這些數字作為方向指導,而不是任何特定序列的目標。
| 生物 | 基因組類型 | 約%GC | 原因 |
|---|---|---|---|
| Plasmodium falciparum(瘧疾寄生蟲) | 核基因組,頂複門原生動物 | ~19% | 已知最AT豐富的基因組之一;極端AT偏差延伸到編碼區,使其序列的PCR和克隆異常困難。 |
| Dictyostelium discoideum(社會性阿米巴) | 核基因組,阿米巴蟲類 | ~22% | 強烈AT豐富,具有A和T的長同聚體鏈,使其原始組裝複雜化。 |
| Arabidopsis thaliana(擬南芥) | 核基因組,開花植物 | ~36% | 典型於許多植物核基因組;編碼外顯子比基因間平均值更富含GC。 |
| Saccharomyces cerevisiae(麵包酵母) | 核基因組,出芽酵母 | ~38% | 緊湊、基因密集的真核基因組,具有中等程度AT豐富的背景。 |
| Homo sapiens(人類) | 核基因組,哺乳動物 | ~41% | GC貧乏和GC豐富等亞基因組的鑲嵌;富含基因的區域和CpG島遠高於基因組平均值。 |
| Drosophila melanogaster(果蠅) | 核基因組,昆蟲 | ~42% | 接近平衡的組成;異色質和重複區域比常染色質更富含AT。 |
| Escherichia coli K-12 | 圓形細菌染色體 | ~50.8% | 經典平衡組成參考基因組,這是它為何是如此便利的克隆和表達宿主的原因的一部分。 |
| Mycobacterium tuberculosis H37Rv | 圓形細菌染色體(放線菌) | ~65.6% | 如大多數放線菌一樣富含GC;密碼子使用在第三位置大幅傾向於G/C。 |
| Streptomyces coelicolor A3(2) | 線性細菌染色體(放線菌) | ~72% | 在常規使用的最富含GC的基因組中;擴增通常需要GC友好緩衝液、DMSO或甜菜鹼。 |
這一寬泛的模式是真實且可重複的:專性細胞內寄生蟲以及某些自由生活的阿米巴原蟲和酵母趨向AT豐富,而放線菌和許多土壤細菌趨向GC豐富。基本原因存在爭議,包括突變偏差、DNA修復機制差異,以及與生活方式和環境相關的選擇。
關鍵術語和變量
公式中使用的變量
| 符號 | 含義 |
|---|---|
| \(N_G\) | 序列中計數的鳥嘌呤(G)鹼基數。 |
| \(N_C\) | 序列中計數的胞嘧啶(C)鹼基數。 |
| \(N_A\) | 序列中計數的腺嘌呤(A)鹼基數。 |
| \(N_T\) | 序列中計數的胸腺嘧啶(T)鹼基數。 |
| \(N_G + N_A + N_T + N_C\) | 總有效鹼基——分母。只有明確的A、T、G和C字符被計數;間隙、空格、數字、換行符和FASTA標頭行被排除,因此包含模糊代碼的序列的總數可能低於其原始字符長度。 |
術語
- 腺嘌呤(A)——一個嘌呤鹼基;在DNA中通過兩個氫鍵與胸腺嘧啶配對。
- 胸腺嘧啶(T)——在DNA中發現的嘧啶鹼基;與腺嘌呤配對。
- 鳥嘌呤(G)——一個嘌呤鹼基;通過三個氫鍵與胞嘧啶配對。
- 胞嘧啶(C)——一個嘧啶鹼基;與鳥嘌呤配對。
- 鹼基對(bp)——雙鏈兩條鏈上的一個A–T或G–C配對;也是DNA長度的標準單位。
- 互補鏈——通過將每個鹼基替換為其配對物(A↔T, G↔C)並反轉順序而產生的相對鏈。因為G總是與C配對,一個序列及其互補序列具有相同的GC含量——您可以從任何一條鏈計算%GC並得到相同的答案。
- GC含量(%GC)——上述公式給出的所有有效鹼基中G或C的百分比。
- AT含量——對於僅包含A、T、G和C的序列的互補量:\(\text{AT\%} = 100 - \text{GC\%}\)。
- 熔解溫度(Tm)——DNA雙鏈群體一半已分離成單鏈的溫度。它隨GC含量上升,但也取決於長度、鹽、濃度和序列背景。
- PCR引物——一個短的合成寡核苷酸(通常約18–25 nt),與模板退火並提供聚合酶延伸的3′端。其GC含量和Tm是設計人員首先檢查的兩個組成特性。
- 等亞基因組——一長段基因組DNA(數百個千鹼基),具有相對均勻的GC含量,與相鄰的區段不同。哺乳動物基因組通常被描述為這樣的GC貧乏和GC豐富區域的鑲嵌。
- 模糊代碼N——IUPAC的「任何鹼基」(A、C、G或T)符號,用於測序讀數不確定或組裝間隙被填充的地方。其他IUPAC代碼如R (A或G)、Y (C或T)和W (A或T)的工作方式相同。因為N可能是G、C、A或T,它無法評分,通常從分子和分母中排除——用許多N填充的序列將僅報告已解決鹼基的%GC。
- 尿嘧啶(U)——在RNA中代替胸腺嘧啶的嘧啶;它與腺嘌呤配對,就像T一樣。因此,RNA序列在計算GC含量之前必須轉換為其DNA形式(將每個U替換為T),否則U字符不被識別為有效鹼基,分母是錯誤的。注意GC值本身不受替換影響,因為U對AT含量有貢獻,而不是GC。
常見問題
GC含量為什麼重要?它會影響DNA的穩定性與解鏈溫度,有助於辨識富含基因的區域,在設計引子時也能確保引子在PCR過程中穩定結合。
無效字元會怎麼處理?像 N、U、間隙或空白字元都會自動移除,只保留並計算 A、T、G、C,因此貼上序列時夾帶的空格不會影響您的結果。
可以輸入RNA序列嗎?本計算器只辨識DNA鹼基(A、T、G、C)。RNA中的尿嘧啶(U)會被過濾掉,因此請先將 U 轉換為 T,才能得到正確的數值。