Leaky ReLU एक्टिवेशन फंक्शन कैलकुलेटर

Leaky ReLU एक्टिवेशन फंक्शन कैलकुलेटर

उभरता AI Skill PRO

गणना दर्ज करें

सूत्र (फॉर्मूला)

f(x)={xif x>0α·xif x≤0f(\text{x}) = \begin{cases} \text{x} & \text{if } \text{x} > 0 \\[0.5em] {\alpha} \cdot \text{x} & \text{if } \text{x} \le 0 \end{cases}
गणना के चरण दिखाएँ (1)
  1. नमूना किए गए x मान

    xi=x का प्रारंभिक मान+i·स्टेप,i=0,1,…,संख्या−1x_i = \text{x का प्रारंभिक मान} + i \cdot \text{स्टेप}, \quad i = 0, 1, \dots, \text{संख्या} - 1

    प्रत्येक बिंदु i (0 से शुरू) दिए गए बिंदुओं की संख्या के लिए x = startX + i*stepX का उपयोग करता है।

उपयोग आँकड़े

विज्ञापन

परिणाम

x पर Leaky ReLU = 3
3
f(x) = x यदि x > 0, अन्यथा α·x
बिंदुओं की संख्या 101
α (लीक ढलान) 0.01
पहला f(x) (x = -4) -0.04
अंतिम f(x) (x = 1) 1
x f(x)
-4 -0.04
-3.95 -0.0395
-3.9 -0.039
-3.85 -0.0385
-3.8 -0.038
-3.75 -0.0375
-3.7 -0.037
-3.65 -0.0365
-3.6 -0.036
-3.55 -0.0355
-3.5 -0.035
-3.45 -0.0345
-3.4 -0.034
-3.35 -0.0335
-3.3 -0.033
-3.25 -0.0325
-3.2 -0.032
-3.15 -0.0315
-3.1 -0.031
-3.05 -0.0305
-3 -0.03
-2.95 -0.0295
-2.9 -0.029
-2.85 -0.0285
-2.8 -0.028
-2.75 -0.0275
-2.7 -0.027
-2.65 -0.0265
-2.6 -0.026
-2.55 -0.0255
-2.5 -0.025
-2.45 -0.0245
-2.4 -0.024
-2.35 -0.0235
-2.3 -0.023
-2.25 -0.0225
-2.2 -0.022
-2.15 -0.0215
-2.1 -0.021
-2.05 -0.0205
-2 -0.02
-1.95 -0.0195
-1.9 -0.019
-1.85 -0.0185
-1.8 -0.018
-1.75 -0.0175
-1.7 -0.017
-1.65 -0.0165
-1.6 -0.016
-1.55 -0.0155
-1.5 -0.015
-1.45 -0.0145
-1.4 -0.014
-1.35 -0.0135
-1.3 -0.013
-1.25 -0.0125
-1.2 -0.012
-1.15 -0.0115
-1.1 -0.011
-1.05 -0.0105
-1 -0.01
-0.95 -0.0095
-0.9 -0.009
-0.85 -0.0085
-0.8 -0.008
-0.75 -0.0075
-0.7 -0.007
-0.65 -0.0065
-0.6 -0.006
-0.55 -0.0055
-0.5 -0.005
-0.45 -0.0045
-0.4 -0.004
-0.35 -0.0035
-0.3 -0.003
-0.25 -0.0025
-0.2 -0.002
-0.15 -0.0015
-0.1 -0.001
-0.05 -0.0005
0 0
0.05 0.05
0.1 0.1
0.15 0.15
0.2 0.2
0.25 0.25
0.3 0.3
0.35 0.35
0.4 0.4
0.45 0.45
0.5 0.5
0.55 0.55
0.6 0.6
0.65 0.65
0.7 0.7
0.75 0.75
0.8 0.8
0.85 0.85
0.9 0.9
0.95 0.95
1 1

इस पेज पर त्रुटि की रिपोर्ट करें

Leaky ReLU एक्टिवेशन फंक्शन क्या है?

Leaky ReLU (Leaky Rectified Linear Unit) डीप न्यूरल नेटवर्क में इस्तेमाल होने वाला एक लोकप्रिय एक्टिवेशन फंक्शन है। सामान्य ReLU की तरह यह पॉज़िटिव इनपुट को सीधे आगे भेज देता है, लेकिन नेगेटिव इनपुट को शून्य पर सपाट करने के बजाय उन्हें एक छोटा-सा नॉन-ज़ीरो ढलान \(\alpha\) देता है। इससे नेगेटिव प्री-एक्टिवेशन के लिए भी एक हल्का ग्रेडिएंट बहता रहता है और "dying ReLU" की समस्या से बचाव होता है — वह स्थिति जहाँ न्यूरॉन हमेशा शून्य देने लगते हैं और सीखना बंद कर देते हैं।
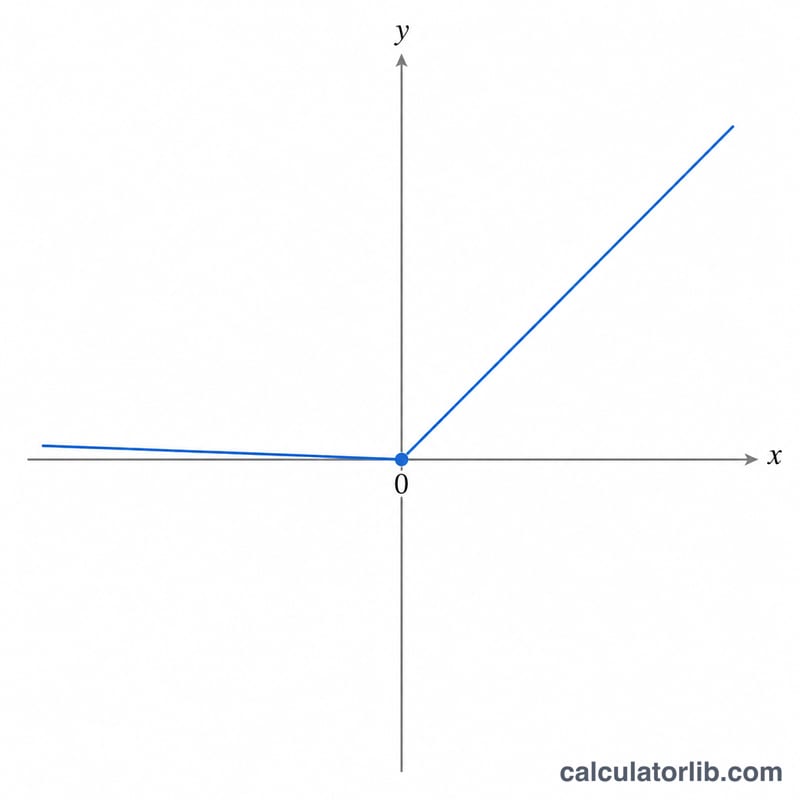
x और y अक्षों पर Leaky ReLU सक्रियण फलन का ग्राफ
Leaky ReLU वक्र: मूल बिंदु से होकर गुजरती एक सीधी रेखा, ऋणात्मक इनपुट के लिए छोटा ढाल और धनात्मक इनपुट के लिए इकाई ढाल।

फॉर्मूला

किसी इनपुट \(x\) और लीक ढलान \(\alpha\) के लिए आउटपुट होता है

$$f(x) = \begin{cases} x & \text{if } x > 0 \\[0.5em] \alpha \cdot x & \text{if } x \le 0 \end{cases}$$

डिफ़ॉल्ट लीक \(\alpha = 0.01\) है। दो खास मामले ध्यान देने लायक हैं: \(\alpha = 0\) होने पर यह सामान्य ReLU (\(\max(0, x)\)) बन जाता है, और \(\alpha = 1\) होने पर फंक्शन आइडेंटिटी रेखा \(f(x) = x\) में बदल जाता है।

इस कैलकुलेटर का उपयोग कैसे करें

\(x\) का प्रारंभिक मान, बिंदुओं के बीच का स्टेप साइज़, कितने बिंदु बनाने हैं उनकी संख्या, और लीक ढलान \(\alpha\) दर्ज करें। यह टूल क्रम

$$x_i = \text{startX} + i \cdot \text{stepX}, \quad i = 0, 1, \dots, \text{count} - 1$$

बनाता है, हर बिंदु पर \(f\) का मान निकालता है, और \((x, f(x))\) जोड़ों की सूची के साथ कर्व का प्लॉट दिखाता है। आप किसी एक \(x\) मान को टाइप करके सीधे \(f(x)\) का एक मान भी पा सकते हैं।

विज्ञापन

हल किया हुआ उदाहरण

\(\alpha = 0.01\) के साथ: \(x = -4\) पर इनपुट नॉन-पॉज़िटिव है, इसलिए \(f = 0.01 \times (-4) = -0.04\)। \(x = 0\) पर \(f = 0\)। \(x = 3\) पर इनपुट पॉज़िटिव है, इसलिए \(f = 3\)। डिफ़ॉल्ट मानों (\(\text{startX} = -4\), \(\text{stepX} = 0.05\), \(\text{count} = 101\)) के साथ स्वीप \(x = -4\) (\(f = -0.04\)) से शुरू होकर \(x = +1.0\) (\(f = 1.0\)) तक चलती है, और 81वें बिंदु (\(i = 80\)) पर शून्य को पार करती है।

अक्सर पूछे जाने वाले सवाल

Leaky ReLU, ReLU से कैसे अलग है? ReLU हर नेगेटिव इनपुट के लिए ठीक 0 देता है; जबकि Leaky ReLU एक छोटा नेगेटिव मान \(\alpha \cdot x\) देता है, जिससे ग्रेडिएंट बना रहता है।

\(\alpha\) का अच्छा मान क्या है? 0.01 आम डिफ़ॉल्ट है। Parametric ReLU जैसे वैरिएंट ट्रेनिंग के दौरान \(\alpha\) को खुद सीख लेते हैं।

क्या \(\alpha\) नेगेटिव हो सकता है? गणितीय रूप से हाँ, लेकिन यह असामान्य है और सामान्य नेटवर्क के लिए इसकी सलाह नहीं दी जाती।


अंतिम अपडेट:

गणित और सांख्यिकी में सबसे लोकप्रिय

गणित और सांख्यिकी के सभी कैलकुलेटर देखें