पॉइंट एस्टीमेट कैलकुलेटर क्या है?
पॉइंट एस्टीमेट यानी बिंदु आकलन किसी अज्ञात जनसंख्या पैरामीटर के लिए एक ही सबसे बेहतर अनुमानित मान होता है — यहाँ यह पैरामीटर है एक अनुपात (proportion)। जब आपके पास n परीक्षणों में से x सफलताएँ हों, तो यह कैलकुलेटर सही अनुपात p के कई प्रचलित बिंदु आकलन निकाल देता है। इनमें सबसे जाना-पहचाना है मैक्सिमम लाइकलीहुड एस्टीमेट (MLE), जो बस x/n होता है। लेकिन जब नमूना छोटा हो या गिनती चरम पर हो (0 या n सफलताएँ), तब लाप्लास, जेफ्रीज़ और विल्सन-समायोजित जैसे स्मूद किए गए आकलन ज़्यादा भरोसेमंद साबित होते हैं।
इसका उपयोग कैसे करें
सफलताओं की संख्या (x) और कुल परीक्षणों की संख्या (n) दर्ज करें। कैलकुलेटर तुरंत कच्चा नमूना अनुपात और साथ ही तीन सुधारे हुए आकलन दिखा देता है। बड़े और सामान्य व्यवहार वाले नमूनों के लिए MLE का उपयोग करें; जब n छोटा हो या x का मान 0 या n के करीब हो, तब लाप्लास या विल्सन को प्राथमिकता दें, क्योंकि ये बिल्कुल 0 या 1 जैसे अव्यावहारिक मान देने से बचते हैं।
सूत्रों की व्याख्या
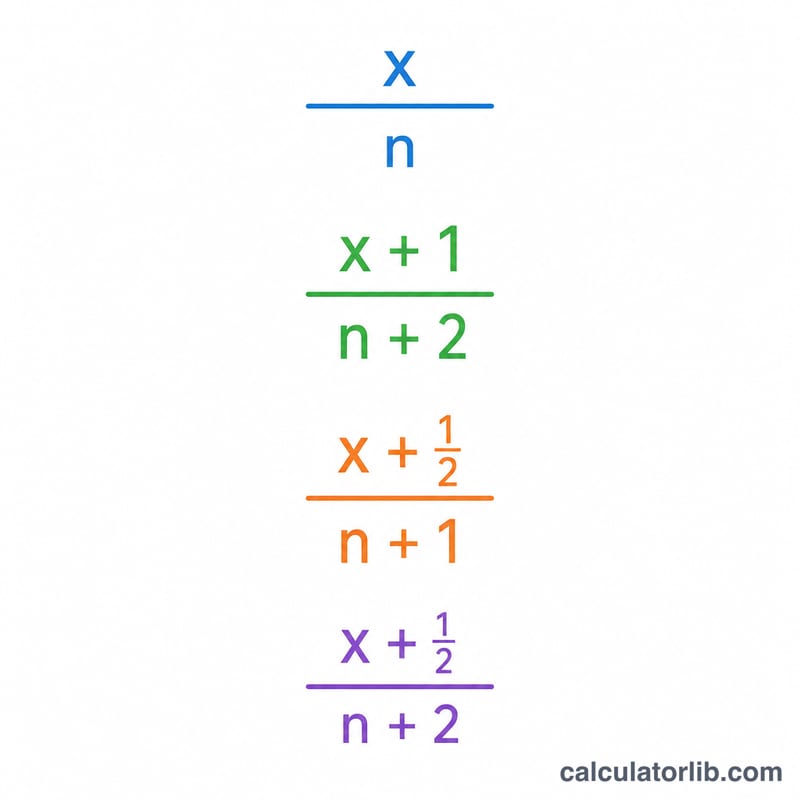
MLE: $$\hat{p} = \frac{x}{n}$$ लाप्लास ("ऐड-वन"): $$\frac{x + 1}{n + 2}$$ जेफ्रीज़: $$\frac{x + 0.5}{n + 1}$$ विल्सन बिंदु आकलन: $$\frac{x + z^{2}/2}{n + z^{2}}$$ जो विल्सन स्कोर अंतराल का केंद्र होता है, जहाँ 95% विश्वास स्तर के लिए \(z = 1.96\) होता है। हर स्मूदिंग पद आकलन को हल्के से 0.5 की ओर खींचता है, जिससे छोटे नमूनों में पूर्वाग्रह (bias) और विचरण (variance) दोनों कम हो जाते हैं।
हल किया हुआ उदाहरण
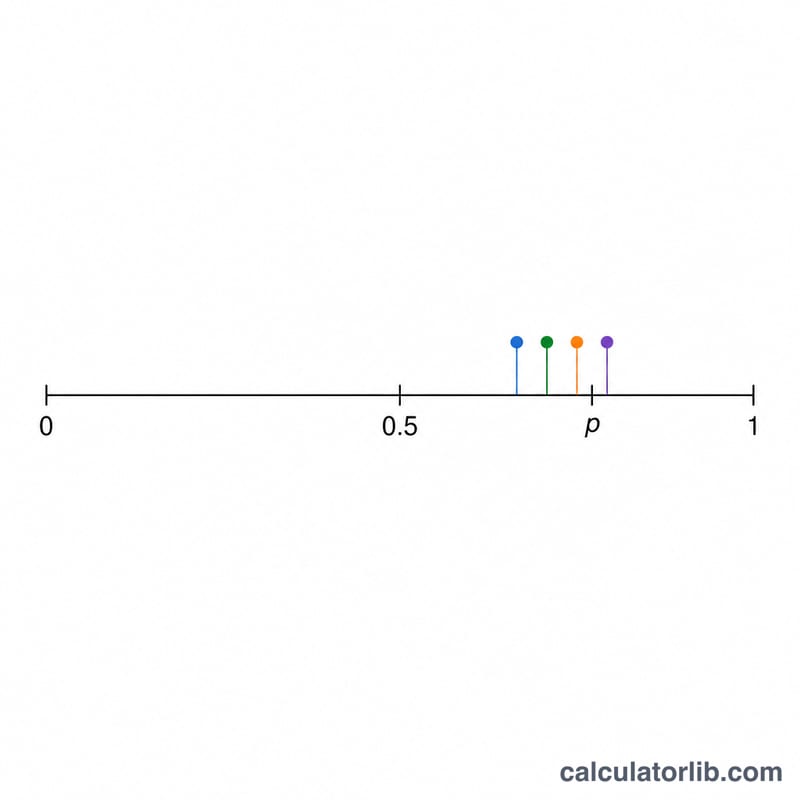
मान लीजिए 10 परीक्षणों में से 8 सफल होते हैं। MLE \(= 8/10 = 0.8\)। लाप्लास $$= \frac{8+1}{10+2} = \frac{9}{12} = 0.75$$ जेफ्रीज़ $$= \frac{8+0.5}{10+1} = \frac{8.5}{11} \approx 0.7727$$ विल्सन के लिए \(z^{2}=3.8416\) के साथ: $$\frac{8 + 1.9208}{10 + 3.8416} = \frac{9.9208}{13.8416} \approx 0.7168$$ ध्यान दें कि स्मूद किए गए सभी आकलन कच्चे मान 0.8 को बीच की ओर खींच लेते हैं।
अक्सर पूछे जाने वाले सवाल
मुझे कौन-सा आकलन बताना चाहिए? अधिकांश रिपोर्टिंग के लिए MLE (नमूना अनुपात) मानक माना जाता है। छोटे नमूनों या दुर्लभ घटनाओं के लिए लाप्लास या विल्सन ज़्यादा भरोसेमंद होते हैं।
विल्सन में z का उपयोग क्यों होता है? विल्सन का बिंदु आकलन विल्सन स्कोर विश्वास अंतराल का मध्यबिंदु होता है, जो आपके चुने हुए विश्वास स्तर के z-मान पर निर्भर करता है (1.96 ≈ 95%)।
अगर x = 0 या x = n हो तो क्या होगा? ऐसे में MLE 0 या 1 देता है, जो अक्सर अव्यावहारिक होता है; जबकि स्मूद किए गए आकलन हमेशा 0 और 1 के बीच का ही मान लौटाते हैं।