टोकन से वर्ड कैलकुलेटर क्या है?
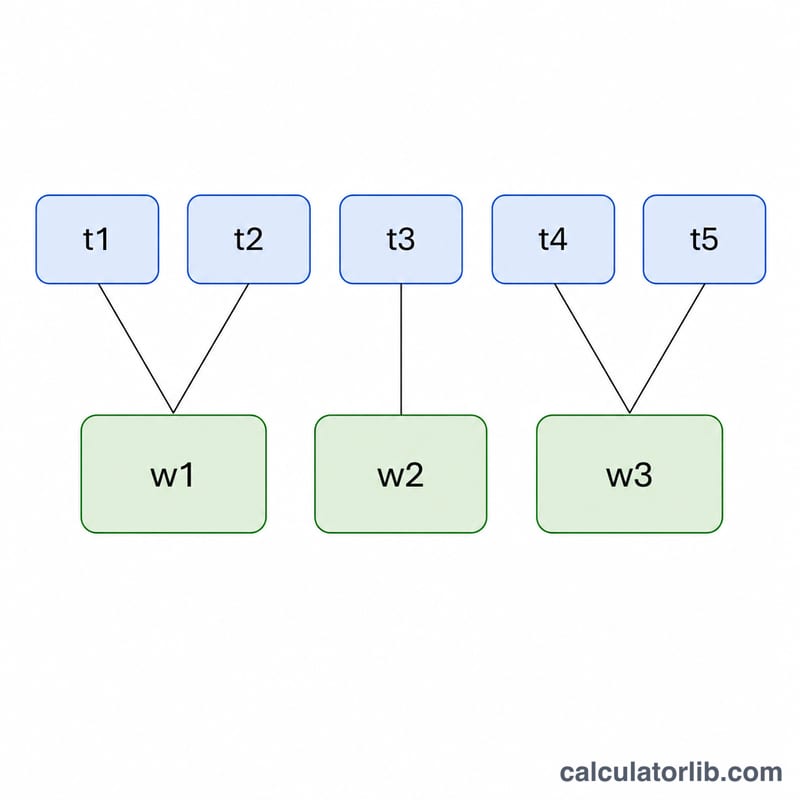
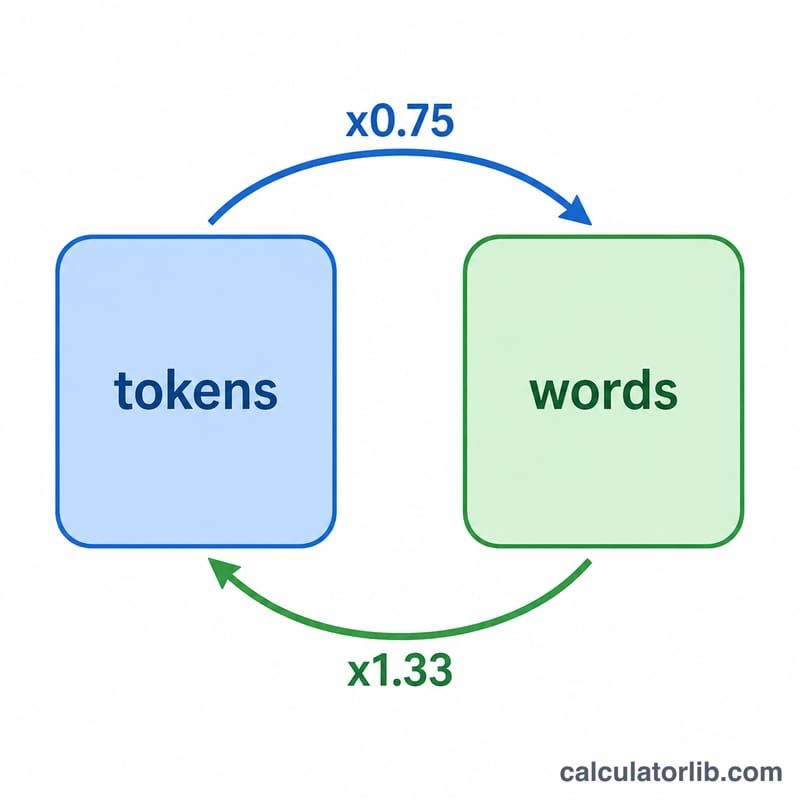
GPT, Claude और Gemini जैसे बड़े लैंग्वेज मॉडल (LLM) टेक्स्ट को शब्द-दर-शब्द नहीं पढ़ते — वे उसे टोकन में प्रोसेस करते हैं। टोकन टेक्स्ट का एक टुकड़ा होता है, जो एक पूरा शब्द, किसी शब्द का हिस्सा या यहाँ तक कि विराम-चिह्न भी हो सकता है। आम अंग्रेज़ी टेक्स्ट के लिए एक टोकन लगभग 0.75 शब्दों के बराबर होता है (यानी प्रति शब्द करीब 1.33 टोकन)। यह कैलकुलेटर टोकन की संख्या को अनुमानित शब्द-संख्या में, या शब्द-संख्या को संभावित टोकन खर्च में बदल देता है।
इसका इस्तेमाल कैसे करें
पहले दिशा चुनें — टोकन से वर्ड या वर्ड से टोकन — फिर अपनी संख्या डालें, और चाहें तो वर्ड-प्रति-टोकन अनुपात (डिफ़ॉल्ट 0.75) को अपने हिसाब से बदल लें। टूल तुरंत बदला हुआ आँकड़ा और इस्तेमाल किया गया अनुपात दिखा देता है। कोड या गैर-अंग्रेज़ी टेक्स्ट के लिए (जिसमें आमतौर पर ज़्यादा टोकन लगते हैं) अनुपात घटाएँ, और सरल, दोहराव वाली अंग्रेज़ी के लिए इसे बढ़ा दें।
फ़ॉर्मूला समझें
यह कन्वर्ज़न एक सीधा अनुपात है। टोकन से शब्दों का अनुमान लगाने के लिए: $$\text{Words} = \text{Tokens} \times \text{Words per Token}$$ शब्दों से टोकन का अनुमान लगाने के लिए: $$\text{Tokens} = \frac{\text{Words}}{\text{Words per Token}}$$ डिफ़ॉल्ट अनुपात 0.75 के साथ, 1,000 टोकन ≈ 750 शब्द, और 1,000 शब्द ≈ 1,333 टोकन। ये सिर्फ़ अनुमान हैं: असल टोकनाइज़ेशन मॉडल, भाषा और कंटेंट पर निर्भर करता है।
उदाहरण के साथ समझें
मान लीजिए किसी API कॉल में बताया गया कि उसने 1,000 टोकन इस्तेमाल किए। डिफ़ॉल्ट अनुपात से: $$1000 \times 0.75 = 750 \text{ शब्द}$$ वहीं अगर आपने 1,500 शब्दों का निबंध लिखा है और जानना चाहते हैं कि इसमें कितने टोकन लगेंगे: $$1500 \div 0.75 = 2{,}000 \text{ टोकन}$$ — यह मॉडल की कॉन्टेक्स्ट विंडो के अंदर रहने या API खर्च का बजट बनाने में मदद करता है।
सामान्य टोकन-से-शब्द रूपांतरण
नीचे दी गई तालिका में लगभग 0.75 शब्द प्रति टोकन का सामान्य अनुमान नियम इस्तेमाल किया गया है (लगभग 4 अंग्रेज़ी अक्षर प्रति टोकन), इसलिए \(\text{शब्द} = \text{टोकन} \times 0.75\)। पृष्ठों की गणना एक सिंगल-स्पेस्ड पृष्ठ पर लगभग 500 शब्दों के आधार पर की गई है। सभी मान अनुमानित हैं; वास्तविक गिनती टोकनाइज़र, भाषा और सामग्री पर निर्भर करती है।
| टोकन | लगभग शब्द (×0.75) | लगभग पृष्ठ (~500 शब्द/पृष्ठ) |
|---|---|---|
| 100 | 75 | 0.15 |
| 500 | 375 | 0.75 |
| 1,000 | 750 | 1.5 |
| 4,000 | 3,000 | 6 |
| 8,000 | 6,000 | 12 |
| 32,000 | 24,000 | 48 |
| 128,000 | 96,000 | 192 |
| 200,000 | 150,000 | 300 |
इसके उलट, शब्दों को अनुपात से भाग दें: \(\text{टोकन} = \text{शब्द} \div 0.75\)। उदाहरण के लिए, 1,500 शब्द ≈ \(1500 \div 0.75 = 2000\) टोकन।
सामग्री प्रकार के अनुसार प्रति टोकन शब्द
अलग-अलग प्रकार का पाठ टोकन में अलग तरह से बँटता है। नीचे दिए अनुपात मोटे अनुमान नियम हैं और टोकनाइज़र तथा मॉडल के अनुसार बदलते हैं, इसलिए परिणामों को अनुमान मानें और जब सटीकता ज़रूरी हो तो अपने प्रदाता का आधिकारिक टोकनाइज़र उपयोग करें।
| सामग्री प्रकार | प्रति टोकन सामान्य शब्द (लगभग) | 1,000 टोकन में शब्द (लगभग) |
|---|---|---|
| सामान्य अंग्रेज़ी गद्य | ~0.75 | ~750 |
| तकनीकी या कानूनी अंग्रेज़ी | ~0.65–0.70 | ~650–700 |
| सोर्स कोड | ~0.5–0.6 | ~500–600 |
| गैर-अंग्रेज़ी या गैर-लैटिन लिपियाँ | ~0.3–0.5 | ~300–500 |
| संख्याओं और विशेष चिह्नों से भरपूर पाठ | अक्सर ~0.5 से कम (अत्यधिक परिवर्तनशील) | अक्सर ~500 से कम |
अंतर क्यों? आम अंग्रेज़ी शब्द अक्सर एक ही टोकन होते हैं, जबकि दुर्लभ शब्द, लंबे तकनीकी शब्द, चिह्न, अंक और कई गैर-लैटिन अक्षर कई छोटे हिस्सों में बँट जाते हैं। कोड में व्हाइटस्पेस, विराम चिह्न और चिह्न भी गिने जाते हैं, जिससे प्रति टोकन शब्द कम हो जाते हैं। कैलकुलेटर में अपनी सामग्री प्रकार से मेल खाता अनुपात फ़ील्ड बदलें।
मुख्य शब्द: टोकन, कॉन्टेक्स्ट विंडो और टोकनाइज़र
- टोकन
- वह बुनियादी इकाई जिसे भाषा मॉडल पढ़ता और लिखता है। टोकन पूरा शब्द, शब्द का हिस्सा, विराम चिह्न या स्पेस-सहित शब्द का टुकड़ा हो सकता है।
- टोकनाइज़र
- वह घटक जो पाठ को टोकन के क्रम में बदलता है (और वापस भी)। हर मॉडल परिवार का अपना टोकनाइज़र और शब्दावली होती है, इसलिए एक ही पाठ से अलग टोकन संख्या आ सकती है।
- बाइट-पेयर एन्कोडिंग (BPE)
- एक आम टोकनाइज़ेशन विधि जो छोटी इकाइयों (जैसे बाइट या अक्षर) से शुरू होती है और सबसे अधिक बार आने वाली आसन्न जोड़ियों को बार-बार मिलाकर बड़े टोकन बनाती है, ताकि एक ऐसी शब्दावली बने जिसमें आम शब्द एक टोकन हों और दुर्लभ शब्द टुकड़ों में बँटें।
- कॉन्टेक्स्ट विंडो
- एक अनुरोध में मॉडल अधिकतम जितने टोकन संभाल सकता है, यह सीमा आम तौर पर प्रॉम्प्ट, बातचीत का इतिहास और उत्पन्न उत्तर को मिलाकर गिनी जाती है।
- इनपुट बनाम आउटपुट टोकन
- इनपुट टोकन वे हैं जो आप मॉडल को भेजते हैं (प्रॉम्प्ट, दस्तावेज़, इतिहास); आउटपुट टोकन वे हैं जिन्हें मॉडल उत्पन्न करता है। प्रदाता अक्सर इन्हें अलग-अलग गिनते हैं और इनका शुल्क और सीमा अलग तरह से तय कर सकते हैं।
- प्रति टोकन शब्द अनुपात
- एक टोकन द्वारा दर्शाए गए शब्दों की औसत संख्या। अंग्रेज़ी गद्य के लिए लगभग 0.75 एक आम अनुमान नियम है (लगभग 1 टोकन ≈ 4 अक्षर), लेकिन यह एक सन्निकटन है जो भाषा और सामग्री प्रकार के साथ बदलता है।
अक्सर पूछे जाने वाले सवाल
क्या प्रति टोकन 0.75 शब्द हमेशा सटीक होता है? नहीं — यह अंग्रेज़ी के लिए एक मोटा-मोटी अनुमान वाला नियम है। कोड, संख्याएँ और दूसरी भाषाओं में अक्सर प्रति शब्द ज़्यादा टोकन लगते हैं, इसलिए उनके लिए कम अनुपात रखें।
टोकन क्यों मायने रखते हैं? LLM की कीमत और कॉन्टेक्स्ट लिमिट शब्दों में नहीं, टोकन में मापी जाती है, इसलिए कन्वर्ट करने से लागत और फ़िट का अंदाज़ा लगाने में आसानी होती है।
सटीक गिनती कैसे पाऊँ? मॉडल का आधिकारिक टोकनाइज़र इस्तेमाल करें (जैसे OpenAI के लिए tiktoken)। यह कैलकुलेटर एक तेज़ अनुमान देता है, सटीक गिनती नहीं।