这个计算器能做什么
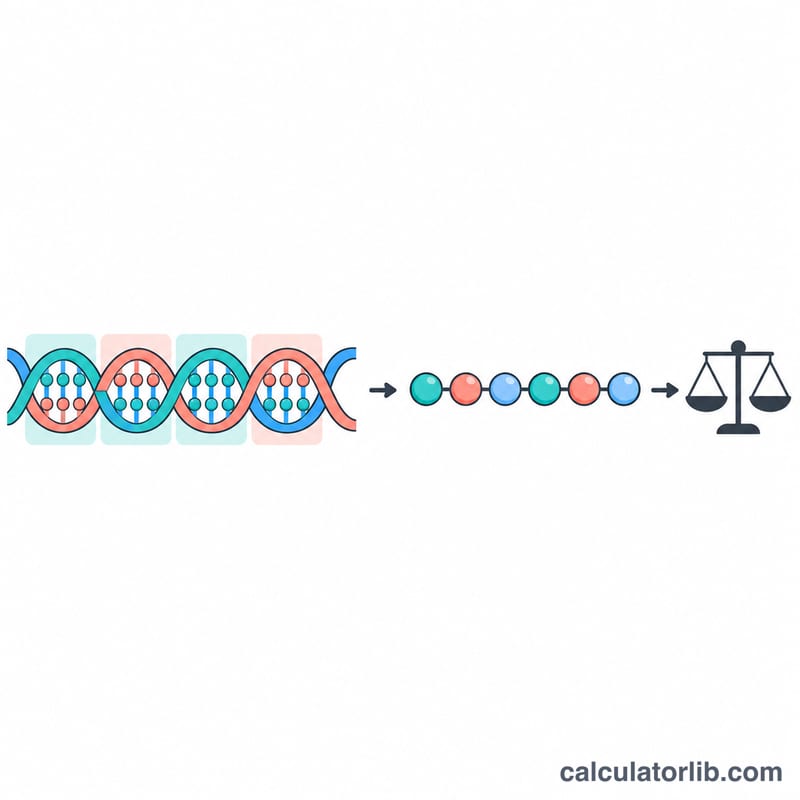
本工具读取DNA编码序列(5′→3′),按你选择的阅读框,使用标准密码子表进行翻译,并计算所得蛋白质的平均分子量。它支持纯序列或FASTA格式文本,会把U当作T处理,并自动忽略空格和数字。知道以kDa为单位的分子量,可以帮助你设计SDS-PAGE胶浓度、选择纯化层析柱、估算消光系数和产量,也能核对表达的重组蛋白条带大小是否与预期一致。
使用方法
粘贴你的编码序列,选择阅读框1、2或3,再决定翻译是否在第一个终止密码子处停止(单个基因通常这样选),还是跳过终止密码子继续翻译。结果会显示以kDa和Da表示的分子量、氨基酸数量、GC含量以及翻译得到的蛋白质序列。
公式说明
每个氨基酸贡献的是其残基质量,即游离氨基酸质量减去肽键形成时脱去的一分子水。再加回一分子水,对应N端的H和C端的OH。
$$\text{MW} = \sum_i n_i \, m_i + 18.01524$$其中 \(n_i\) 表示氨基酸 \(i\) 的数量,\(m_i\) 表示其平均残基质量(单位Da)。换算关系为 \(\text{kDa} = \text{Da}/1000\)。
计算示例
以阅读框1中的 ATGGGCTAA 为例。它依次读作 ATG(Met,甲硫氨酸)、GGC(Gly,甘氨酸)、TAA(终止密码子),因此蛋白质为 Met-Gly。
$$\text{MW} = 131.1926 + 57.0519 + 18.0152 = 206.2597\,\text{Da} = 0.2063\,\text{kDa}$$氨基酸平均残基质量
本计算器将每个氨基酸残基的平均(同位素加权)质量相加,即氨基酸减去一分子因肽键形成而失去的水,然后再加上一分子水(18.01524 Da),用于整条链的游离N端(H)和C端(OH)。数值单位为道尔顿(Da)。
| 氨基酸 | 三字母 | 单字母 | 平均残基质量(Da) |
|---|---|---|---|
| 甘氨酸 | Gly | G | 57.0519 |
| 丙氨酸 | Ala | A | 71.0788 |
| 丝氨酸 | Ser | S | 87.0782 |
| 脯氨酸 | Pro | P | 97.1167 |
| 缬氨酸 | Val | V | 99.1326 |
| 苏氨酸 | Thr | T | 101.1051 |
| 半胱氨酸 | Cys | C | 103.1388 |
| 亮氨酸 | Leu | L | 113.1594 |
| 异亮氨酸 | Ile | I | 113.1594 |
| 天冬酰胺 | Asn | N | 114.1038 |
| 天冬氨酸 | Asp | D | 115.0886 |
| 谷氨酰胺 | Gln | Q | 128.1307 |
| 赖氨酸 | Lys | K | 128.1741 |
| 谷氨酸 | Glu | E | 129.1155 |
| 甲硫氨酸 | Met | M | 131.1926 |
| 组氨酸 | His | H | 137.1411 |
| 苯丙氨酸 | Phe | F | 147.1766 |
| 精氨酸 | Arg | R | 156.1875 |
| 酪氨酸 | Tyr | Y | 163.1760 |
| 色氨酸 | Trp | W | 186.2132 |
每条链加水一次: 18.01524 Da。
手工计算示例:二肽 Met-Gly 的质量为 \(131.1926 + 57.0519 + 18.01524 = 206.25974\) Da。
标准遗传密码子表
这是标准(通用)细胞核遗传密码,按氨基酸分组。密码子以DNA形式书写(A、C、G、T);如果您的序列是RNA,则U按T读取。ATG(Met)是常用的起始密码子,TAA、TAG和TGA是终止密码子。某些细胞器(例如线粒体)和少数生物使用变异密码,本标准表不涵盖这些情况。
| 氨基酸 | 密码子 | 数量 |
|---|---|---|
| Phe (F) | TTT, TTC | 2 |
| Leu (L) | TTA, TTG, CTT, CTC, CTA, CTG | 6 |
| Ile (I) | ATT, ATC, ATA | 3 |
| Met (M) | ATG(起始密码子) | 1 |
| Val (V) | GTT, GTC, GTA, GTG | 4 |
| Ser (S) | TCT, TCC, TCA, TCG, AGT, AGC | 6 |
| Pro (P) | CCT, CCC, CCA, CCG | 4 |
| Thr (T) | ACT, ACC, ACA, ACG | 4 |
| Ala (A) | GCT, GCC, GCA, GCG | 4 |
| Tyr (Y) | TAT, TAC | 2 |
| His (H) | CAT, CAC | 2 |
| Gln (Q) | CAA, CAG | 2 |
| Asn (N) | AAT, AAC | 2 |
| Lys (K) | AAA, AAG | 2 |
| Asp (D) | GAT, GAC | 2 |
| Glu (E) | GAA, GAG | 2 |
| Cys (C) | TGT, TGC | 2 |
| Trp (W) | TGG | 1 |
| Arg (R) | CGT, CGC, CGA, CGG, AGA, AGG | 6 |
| Gly (G) | GGT, GGC, GGA, GGG | 4 |
| 终止 | TAA, TAG, TGA | 3 |
总计:61个有义密码子 + 3个终止密码子 = 64。
解读您的蛋白质质量
结果是您的序列所编码的未修饰多肽的理论平均质量。1 kDa = 1000 Da,因此33,000 Da的结果即为33 kDa。作为粗略的合理性检查,平均氨基酸贡献约110 Da,因此\(\text{MW (Da)} \approx N_{\text{aa}} \times 110\):100个残基的蛋白质约为11 kDa,300个残基的蛋白质约为33 kDa。真实蛋白质与此估算的偏差取决于其组成。
为什么SDS-PAGE条带可能与计算质量不同
- 标签和融合蛋白:His6标签增加约0.8 kDa的残基,再加上任何连接子;较大的融合伴侣增加的质量要多得多。请检查您的序列是否包含该标签,以及您是否翻译了它。
- 信号肽切除:分泌蛋白或膜蛋白通常会失去N端信号序列(通常约15–30个残基),因此成熟蛋白比完整翻译产物更轻。
- 翻译后修饰:糖基化、磷酸化、脂化、蛋白水解加工、起始Met的去除以及二硫键(每个约−2.016 Da)都会改变真实质量。糖基化可增加数kDa并使条带弥散。
- 错误的阅读框或链:不同的阅读框会产生完全不同的蛋白质,常在终止密码子处提前结束。如果结果明显过小,请尝试阅读框1–3,并考虑您序列的反向互补序列。
- 凝胶行为:SDS-PAGE只是近似值(通常误差在约10%以内);高度酸性、碱性或疏水性的蛋白质可能迁移异常。
- 终止密码子:内部或末端终止密码子的处理方式(由终止密码子选项设定)会改变计入的残基数量。
平均质量与单同位素质量
本计算器使用平均质量,即按各元素的天然同位素丰度加权。它们对应于同位素峰形的质心,适用于质谱中较大的蛋白质。单同位素质量仅使用每种元素丰度最高的同位素(例如12C),通常用于肽段和高分辨率仪器;它略低于平均质量,且差值随分子大小增大而增加。请勿直接比较这两者。
本工具旨在用于表达和纯化实验的研究与规划;它仅提供一般信息,不构成医疗或诊断建议。
常见问题
结果包含标签或修饰吗?不包含。只计算翻译出的氨基酸,所以如果有序列之外的标签,请自行加上其质量;另外,磷酸化、糖基化或信号肽切除都会改变实际观察到的分子大小。
为什么算出的分子量不对?请检查阅读框是否正确,以及输入的是编码链而不是反向互补链。
这是单同位素质量吗?不是,这里给出的是平均质量,与凝胶电泳和SEC(凝胶过滤)的估算值更接近,而不是单同位素质量。