Qué hace esta calculadora
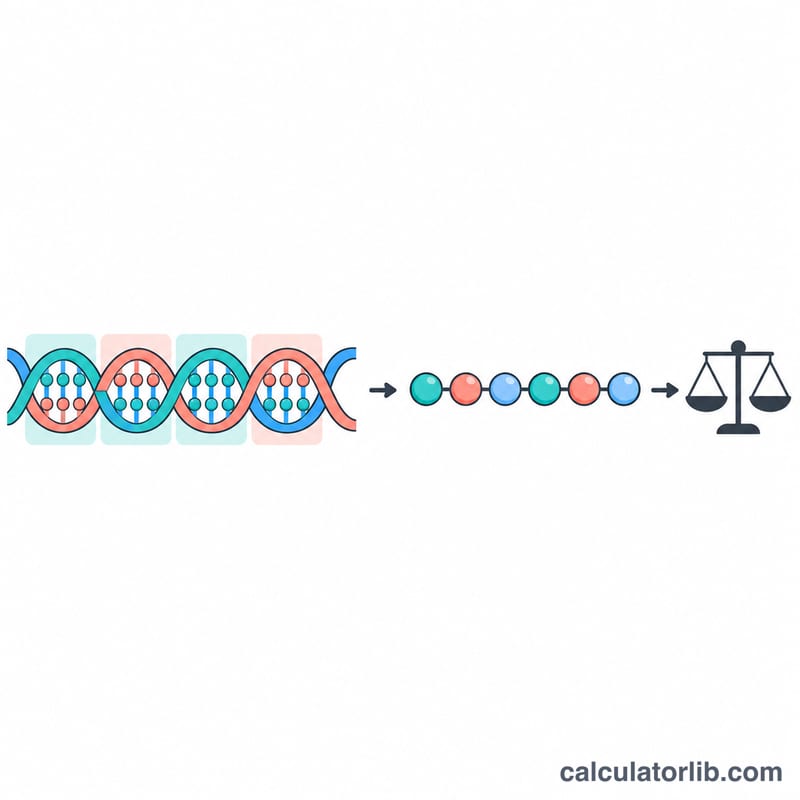
Esta herramienta lee una secuencia codificante de ADN (5′→3′), la traduce con el código genético estándar en el marco de lectura que elijas y calcula el peso molecular medio de la proteína resultante. Admite secuencias en texto plano o en formato FASTA, trata la U como T e ignora espacios en blanco y dígitos. Conocer la masa en kDa te ayuda a planificar geles SDS-PAGE, elegir columnas de purificación, estimar el coeficiente de extinción y el rendimiento, y comprobar que la construcción expresada coincide con el tamaño de banda esperado.
Cómo usarla
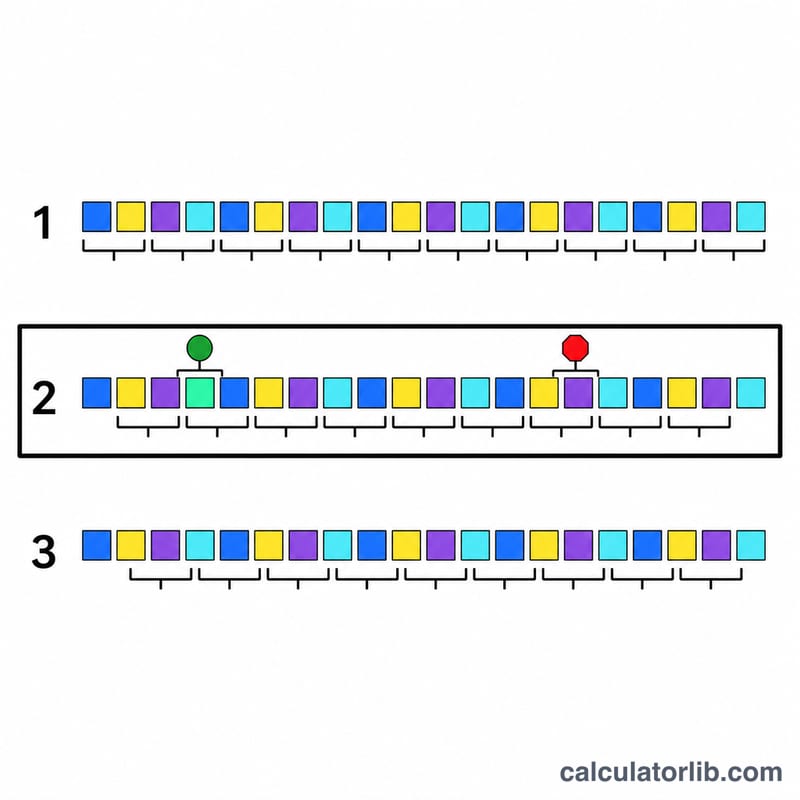
Pega tu secuencia codificante, selecciona el marco 1, 2 o 3 y decide si la traducción debe detenerse en el primer codón de parada (lo habitual en un solo gen) o saltarse las paradas y continuar. El resultado muestra el peso en kDa y Da, el número de aminoácidos, el contenido de GC y la secuencia proteica traducida.
Explicación de la fórmula
Cada aminoácido aporta su masa de residuo, que es la masa del aminoácido libre menos una molécula de agua perdida en el enlace peptídico. Al final se suma una molécula de agua por el H del extremo N-terminal y el OH del extremo C-terminal.
$$\text{MW} = \sum_i n_i \, m_i + 18.01524$$Aquí \(n_i\) es el número de aminoácidos de tipo \(i\) y \(m_i\) es su masa media de residuo en Da. Después, \(\text{kDa} = \text{Da}/1000\).
Ejemplo resuelto
Tomemos ATGGGCTAA en el marco 1. Se lee ATG (Met), GGC (Gly), TAA (parada), así que la proteína es Met-Gly.
$$\text{MW} = 131.1926 + 57.0519 + 18.0152 = 206.2597\,\text{Da} = 0.2063\,\text{kDa}$$Masas residuales promedio de los aminoácidos
La calculadora suma la masa promedio (ponderada por isótopos) de cada residuo de aminoácido, es decir, el aminoácido menos una molécula de agua perdida en la formación del enlace peptídico, y luego añade una molécula de agua (18,01524 Da) correspondiente al extremo N-terminal libre (H) y al extremo C-terminal (OH) de la cadena completa. Los valores se expresan en daltones (Da).
| Aminoácido | 3 letras | 1 letra | Masa residual promedio (Da) |
|---|---|---|---|
| Glicina | Gly | G | 57,0519 |
| Alanina | Ala | A | 71,0788 |
| Serina | Ser | S | 87,0782 |
| Prolina | Pro | P | 97,1167 |
| Valina | Val | V | 99,1326 |
| Treonina | Thr | T | 101,1051 |
| Cisteína | Cys | C | 103,1388 |
| Leucina | Leu | L | 113,1594 |
| Isoleucina | Ile | I | 113,1594 |
| Asparagina | Asn | N | 114,1038 |
| Ácido aspártico | Asp | D | 115,0886 |
| Glutamina | Gln | Q | 128,1307 |
| Lisina | Lys | K | 128,1741 |
| Ácido glutámico | Glu | E | 129,1155 |
| Metionina | Met | M | 131,1926 |
| Histidina | His | H | 137,1411 |
| Fenilalanina | Phe | F | 147,1766 |
| Arginina | Arg | R | 156,1875 |
| Tirosina | Tyr | Y | 163,1760 |
| Triptófano | Trp | W | 186,2132 |
Agua añadida una vez por cadena: 18,01524 Da.
Ejemplo manual: el dipéptido Met-Gly tiene una masa de \(131.1926 + 57.0519 + 18.01524 = 206.25974\) Da.
Tabla estándar del código genético de codones
Esta es el código genético estándar (universal) nuclear, agrupado por aminoácido. Los codones se escriben como ADN (A, C, G, T); si su secuencia es ARN, la U se lee como T. ATG (Met) es el codón de inicio habitual, y TAA, TAG y TGA son los codones de parada. Algunos orgánulos (p. ej., las mitocondrias) y algunos organismos usan códigos variantes, que esta tabla estándar no cubre.
| Aminoácido | Codones | Número |
|---|---|---|
| Phe (F) | TTT, TTC | 2 |
| Leu (L) | TTA, TTG, CTT, CTC, CTA, CTG | 6 |
| Ile (I) | ATT, ATC, ATA | 3 |
| Met (M) | ATG (codón de inicio) | 1 |
| Val (V) | GTT, GTC, GTA, GTG | 4 |
| Ser (S) | TCT, TCC, TCA, TCG, AGT, AGC | 6 |
| Pro (P) | CCT, CCC, CCA, CCG | 4 |
| Thr (T) | ACT, ACC, ACA, ACG | 4 |
| Ala (A) | GCT, GCC, GCA, GCG | 4 |
| Tyr (Y) | TAT, TAC | 2 |
| His (H) | CAT, CAC | 2 |
| Gln (Q) | CAA, CAG | 2 |
| Asn (N) | AAT, AAC | 2 |
| Lys (K) | AAA, AAG | 2 |
| Asp (D) | GAT, GAC | 2 |
| Glu (E) | GAA, GAG | 2 |
| Cys (C) | TGT, TGC | 2 |
| Trp (W) | TGG | 1 |
| Arg (R) | CGT, CGC, CGA, CGG, AGA, AGG | 6 |
| Gly (G) | GGT, GGC, GGA, GGG | 4 |
| Parada | TAA, TAG, TGA | 3 |
Total: 61 codones con sentido + 3 codones de parada = 64.
Interpretación de la masa de su proteína
El resultado es la masa promedio teórica del polipéptido no modificado codificado por su secuencia. 1 kDa = 1000 Da, por lo que un resultado de 33.000 Da equivale a 33 kDa. Como comprobación aproximada, el aminoácido promedio aporta unos 110 Da, así que \(\text{MW (Da)} \approx N_{\text{aa}} \times 110\): una proteína de 100 residuos pesa unos 11 kDa y una de 300 residuos unos 33 kDa. Las proteínas reales se desvían de esta estimación según su composición.
Por qué la banda de SDS-PAGE puede diferir de la masa calculada
- Etiquetas y fusiones: una etiqueta His6 añade aproximadamente 0,8 kDa de residuos más el conector, si lo hay; las proteínas de fusión más grandes añaden mucho más. Compruebe si su secuencia incluye la etiqueta y si la tradujo.
- Escisión del péptido señal: las proteínas secretadas o de membrana suelen perder una secuencia señal N-terminal (normalmente de unos 15–30 residuos), por lo que la proteína madura es más ligera que la traducción completa.
- Modificaciones postraduccionales: la glicosilación, la fosforilación, la lipidación, el procesamiento proteolítico, la eliminación de la Met iniciadora y los puentes disulfuro (unos −2,016 Da cada uno) cambian la masa real. La glicosilación puede añadir varios kDa y difuminar una banda.
- Marco o cadena incorrectos: un marco de lectura diferente produce una proteína completamente distinta, que a menudo termina antes de tiempo en un codón de parada. Si el resultado es muy pequeño, pruebe los marcos 1–3 y considere el complemento inverso de su secuencia.
- Comportamiento en el gel: el SDS-PAGE es solo aproximado (a menudo dentro de unos 10 %); las proteínas muy ácidas, básicas o hidrofóbicas pueden migrar de forma anómala.
- Codones de parada: la forma en que se trata una parada interna o terminal (definida por la opción de codón de parada) cambia el número de residuos contabilizados.
Masa promedio frente a masa monoisotópica
Esta calculadora usa masas promedio, que ponderan cada elemento según su abundancia isotópica natural. Corresponden al centroide de la envolvente isotópica y son adecuadas para proteínas grandes en espectrometría de masas. La masa monoisotópica usa solo el isótopo más abundante de cada elemento (p. ej., 12C) y suele utilizarse para péptidos e instrumentos de alta resolución; es ligeramente inferior a la masa promedio, y la diferencia aumenta con el tamaño. No compare directamente ambas.
Esta herramienta está pensada para la investigación y la planificación de experimentos de expresión y purificación; proporciona información general únicamente, no consejo médico ni diagnóstico.
Preguntas frecuentes
¿Incluye etiquetas (tags) o modificaciones? No. Solo se cuentan los aminoácidos traducidos, así que suma la masa de cualquier etiqueta que no esté en tu secuencia. Ten en cuenta que la fosforilación, la glicosilación o el corte del péptido señal modifican el tamaño observado.
¿Por qué me sale una masa incorrecta? Revisa el marco de lectura y comprueba que tu secuencia sea la hebra codificante y no el complementario inverso.
¿La masa es monoisotópica? No, es la masa media, que se ajusta mejor a las estimaciones en gel y en cromatografía de exclusión molecular (SEC) que los valores monoisotópicos.