什么是大模型显存需求计算器?
这个工具能帮你估算加载并运行大语言模型(LLM)进行推理时,大约需要多少 GPU 显存(VRAM)。显存占用主要取决于两个因素:模型的参数量,以及存储每个权重所采用的数值精度。此外,我们还引入了一个安全/开销系数,用来覆盖 KV 缓存、激活值和 CUDA 上下文等在纯权重之外额外消耗的显存。
如何使用
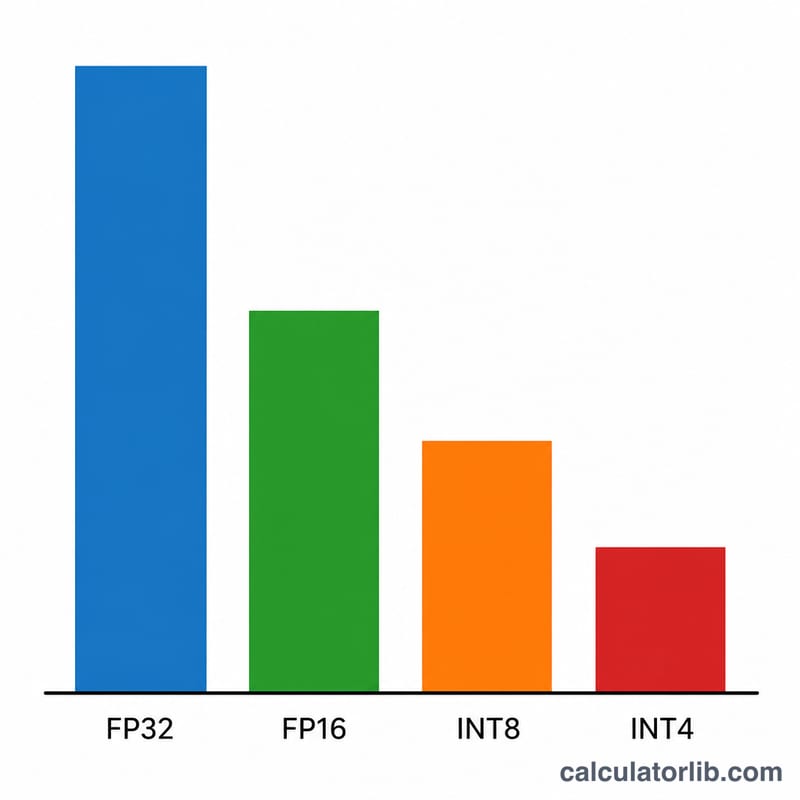
先填入模型规模,单位为「十亿参数」(例如 7B 模型填 7,Llama-3 70B 填 70)。接着选择数值精度:FP32 每个权重占 4 字节,FP16/BF16 占 2 字节,INT8 占 1 字节,INT4 量化则只占 0.5 字节。最后设置开销系数——对于短上下文推理,1.2(即预留 20% 缓冲)是一个比较合理的默认值;如果是长上下文或需要批量推理,则应适当调高。
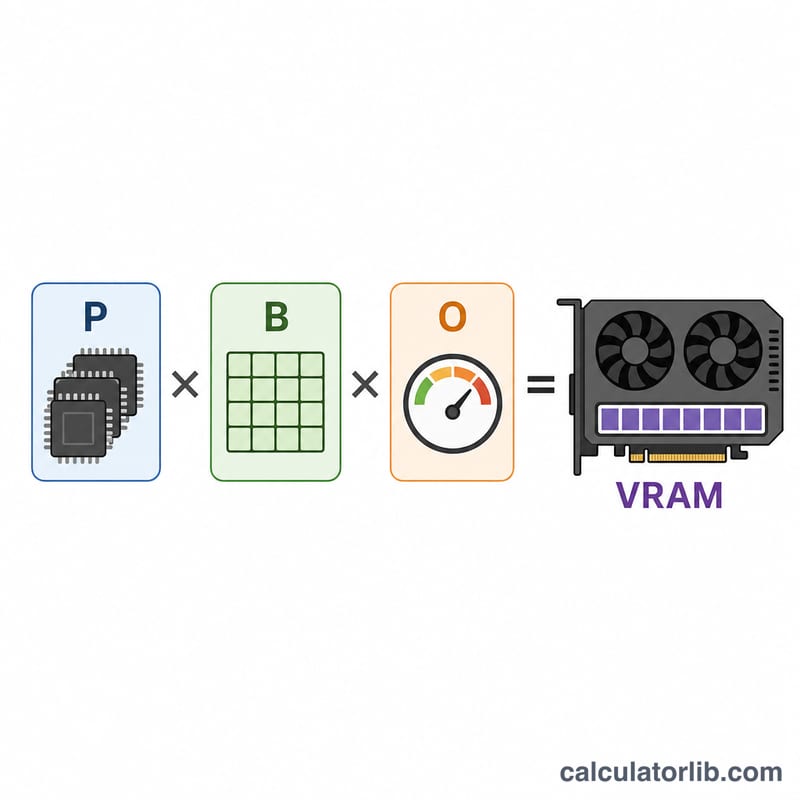
计算公式解析
$$\text{显存(GB)} = \text{参数量(十亿)} \times \text{每参数字节数} \times \text{开销系数}$$由于 10 亿字节 ≈ 1 GB,所以用「十亿为单位的参数量」乘以「每参数字节数」就能直接得到 GB 数。再乘以开销系数,即可把运行时的额外显存一并算进去。
实例演算
以一个 7B 模型、采用 FP16 精度、开销系数为 1.2 为例:$$7 \times 2 \times 1.2 = 16.8 \text{ GB}$$一张 24 GB 的显卡可以轻松容纳。同样的模型若改用 INT4:$$7 \times 0.5 \times 1.2 = 4.2 \text{ GB}$$连 8 GB 的 GPU 都能流畅运行。
常见模型规模与精度的显存估算
表格采用计算器的公式,默认开销系数为 1.2:\(\text{VRAM (GB)} = \text{Params (B)} \times \text{Bytes/Param} \times 1.2\)。每个参数的字节数:FP16 为 2,INT8 为 1,INT4 为 0.5。“适用于”注释将每个结果与单张 GPU 的标称容量进行比较,实际可用容量会略低一些。
| 模型规模 | FP16 (GB) | INT8 (GB) | INT4 (GB) |
|---|---|---|---|
| 7B | 16.8 | 8.4 | 4.2 |
| 13B | 31.2 | 15.6 | 7.8 |
| 34B | 81.6 | 40.8 | 20.4 |
| 70B | 168 | 84 | 42 |
| 405B | 972 | 486 | 243 |
各显存等级可容纳的估算结果
- 7B:FP16 需要 24 GB 显卡(16.8 GB 超出 16 GB)。INT8 可放入 16 GB。INT4 可放入 8 GB。
- 13B:FP16 需要 48 GB。INT8(15.6 GB)仅勉强放入 16 GB,因此 24 GB 更为宽裕。INT4(7.8 GB)在 8 GB 上非常紧张,因此 16 GB 是实际可行的选择。
- 34B:FP16(81.6 GB)超过单张 80 GB 显卡,因此需要多张 GPU。INT8 可放入 48 GB。INT4 可放入 24 GB。
- 70B:FP16(168 GB)至少需要三张 80 GB GPU。INT8(84 GB)超过单张 80 GB 显卡,因此需要两张 GPU,例如 2×48 GB 或 2×80 GB。INT4(42 GB)可放入 48 GB。
- 405B:所有精度都需要多张 GPU。FP16 至少需要十三张 80 GB 显卡,INT8 至少需要七张,INT4 至少需要四张。
当估算值超过单张显卡的显存时,模型必须拆分到多张 GPU 上(张量并行或流水线并行)。此时互连速度和每张 GPU 的额外开销都会产生影响,因此应在简单除法的结果之上预留一些额外余量。
各精度格式的每参数字节数
| 格式 | 每参数字节数 | 典型用途 |
|---|---|---|
| FP32 | 4 | 训练基线、研究以及对数值精度敏感的工作;很少用于 LLM 推理服务 |
| FP16 / BF16 | 2 | 标准的全质量推理,也是已发布模型权重常用的存储格式 |
| FP8 / INT8 | 1 | 在支持的硬件和软件上高效服务,质量损失很小 |
| INT4 | 0.5 | 面向本地推理和消费级 GPU 的激进量化,会有一定质量损失 |
关于真实 4 位格式的说明:GGUF Q4_K_M、GPTQ 和 AWQ 等实际使用的 4 位方案会存储分组缩放因子及其他元数据。因此,它们每个权重所占字节数略高于 0.5,大约为 0.55 至 0.65。对于这些格式,可以适当提高开销系数,或者将 INT4 的结果视为略微低估。
按使用场景划分的典型开销系数
| 使用场景 | 开销系数 |
|---|---|
| 短上下文,单用户 | 约 1.2 |
| 长上下文或中等批处理 | 约 1.5 至 2.0 |
| 大批量处理或超长上下文服务 | 2.0 或更高 |
这些只是经验法则,并非固定标准。推理引擎、上下文长度和并发数决定了实际数值。
解读你的显存估算结果
该结果是一个近似的、偏下限性质的推理估算值。它计算了模型权重所需的显存,并按固定百分比加上 KV 缓存、激活值、CUDA 上下文和框架缓冲区的占用。它不是精确测量值,也不涵盖训练。训练还需要存储梯度和优化器状态,可能需要数倍的显存。
KV 缓存如何随规模变化
KV 缓存随上下文长度、批大小、层数以及键/值投影的隐藏维度线性增长:
$$\text{KV cache (bytes)} \approx 2 \times L \times d_{kv} \times T \times B \times b$$
其中 \(L\) 为层数,\(d_{kv}\) 为键/值宽度,\(T\) 为以 token 计的上下文长度,\(B\) 为批大小(并发序列数),\(b\) 为每个缓存元素的字节数。系数 2 对应键和值两部分。举例来说,一个采用标准多头注意力、32 层、隐藏维度 4096、上下文为 4096 个 token 且使用 FP16 缓存的模型,需要 \(2 \times 32 \times 4096 \times 4096 \times 2 = 2{,}147{,}483{,}648\) 字节,即每个序列约 2.1 GB。采用分组查询注意力的模型,其 \(d_{kv}\) 更小,因此缓存也小得多。在长上下文或多用户并发的情况下,缓存可能与模型权重相当甚至超过权重,此时应提高开销系数。
与可用显存进行比较
应将估算值与 GPU 的可用显存进行比较,而不是与标称值比较。驱动程序、CUDA 上下文以及显示输出(如果该 GPU 同时驱动显示器)都会占用一部分显存,推理引擎通常还会预留其余显存的一部分。标称 24 GB 的显卡,通常能提供给模型的显存明显更少。如果你的估算值与显卡容量相差在几个百分点之内,应假定无法装下。
多 GPU
采用张量并行时,权重和 KV 缓存会被拆分到各 GPU 上,因此每张卡大致承担其应得的份额。每张 GPU 仍需占用自身的 CUDA 上下文和缓冲区,通信缓冲区还会增加额外占用,因此所有 GPU 的总占用会比单 GPU 估算值略高。
混合专家模型
对于混合专家(MoE)模型,应输入总参数量,而不是激活参数量。每个 token 只有部分专家参与运算,这降低了计算量,但所有专家的权重通常都必须常驻显存,以便路由器可以选择其中任意一个专家。
以上内容仅供规划参考。请使用你自己的软件和工作负载检查实际占用情况。
常见问题
为什么实际占用比纯权重还要高?KV 缓存会随着上下文长度和批量大小而增长,框架本身也会为激活值和各类缓冲区预留空间——开销系数正是用来近似估算这部分额外消耗的。
这个估算包含训练吗?不包含。训练因为要保存优化器状态和梯度,所需显存大约是推理的 3~4 倍;本计算器只针对推理场景。
开销系数该怎么设?短提示词用 1.2 左右即可;长上下文或大批量推理则建议设为 1.5~2.0 甚至更高。