¿Qué es la función softmax?
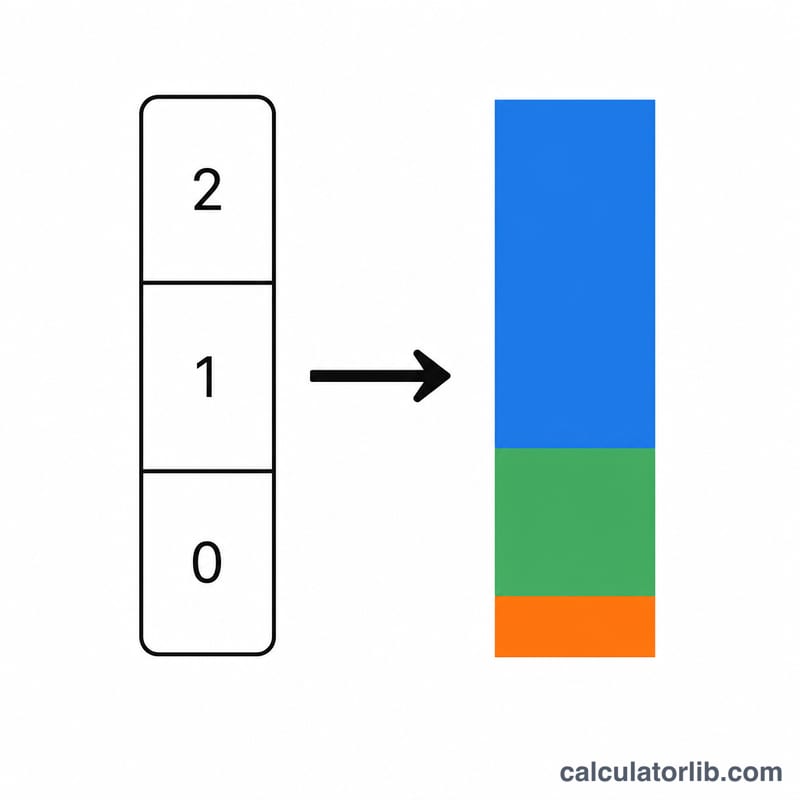
La función softmax toma un vector de K números reales y lo transforma en una distribución de probabilidad: cada salida queda estrictamente entre 0 y 1, y las K salidas suman exactamente 1. Es la función de activación habitual en la capa de salida de los clasificadores basados en redes neuronales, donde convierte las puntuaciones brutas del modelo (los logits) en probabilidades de clase. Al ser adimensional, las entradas son números puros, sin unidades.
Cómo usar esta calculadora
Escribe tu vector de entrada en el recuadro como una lista de números separados por comas, espacios o saltos de línea (por ejemplo, 1, 2, 3). Los números pueden ser positivos, negativos, cero o decimales. Pulsa calcular y obtendrás la probabilidad softmax de cada componente, la suma de las salidas (que debe valer 1) y el argmax: el índice (empezando en 1) de la mayor probabilidad.
La fórmula explicada
Para cada componente j, el softmax es \(\sigma(z)_j = e^{z_j} / \sum_{k} e^{z_k}\). Aplicar la exponencial hace que todos los términos sean positivos, y dividir por el total los normaliza para que sumen 1. Para garantizar la estabilidad numérica, esta calculadora resta el valor máximo m a cada elemento antes de exponenciar:
$$\sigma(z)_j = \frac{e^{\,z_j - m}}{\displaystyle\sum_{k} e^{\,z_k - m}}$$El factor común \(e^{-m}\) se cancela, de modo que el resultado es idéntico y, a la vez, se evita el desbordamiento (overflow) con entradas grandes.
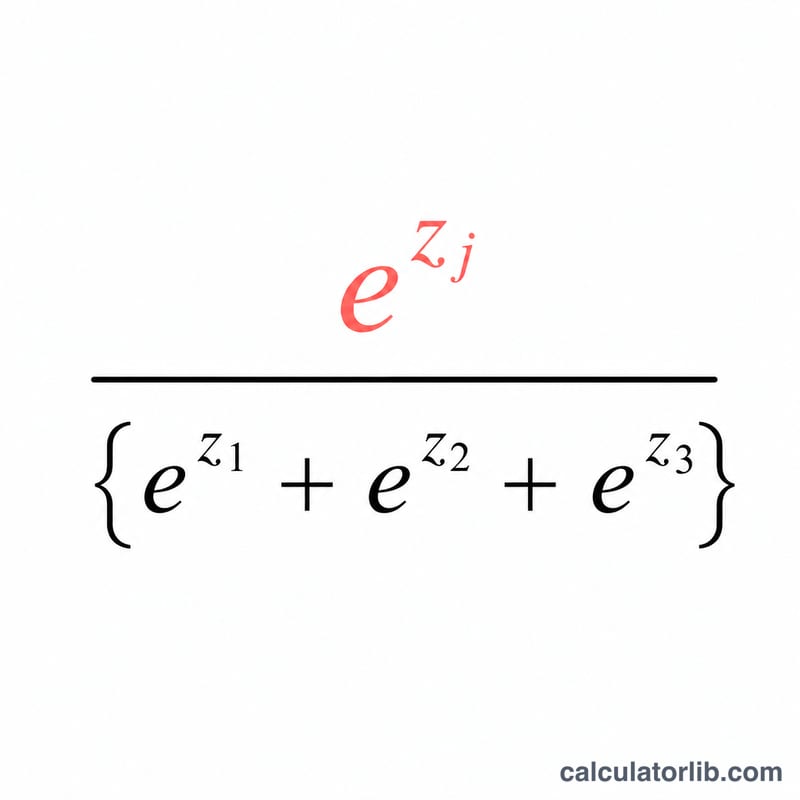
Ejemplo resuelto
Para \(z = (1, 2, 3)\): \(e^{1} = 2{,}71828\), \(e^{2} = 7{,}38906\), \(e^{3} = 20{,}08554\), que suman \(30{,}19287\). Al dividir cada uno se obtiene
$$\sigma = (0{,}09003,\ 0{,}24473,\ 0{,}66524)$$cuyo total es 1. El argmax es el índice 3, la mayor entrada, con una probabilidad de \(0{,}66524\).
Salida de Softmax para diferentes vectores de entrada
La tabla muestra las salidas de softmax para varios vectores de entrada, calculadas con \(\sigma(\mathbf{x})_i = e^{x_i - \max(\mathbf{x})} / \sum_j e^{x_j - \max(\mathbf{x})}\). Los valores se redondean a 4 decimales, y las salidas siempre suman 1.
| Vector de entrada | Salida de softmax | Argmax (posición) | Comentario |
|---|---|---|---|
| (1, 1, 1) | 0.3333, 0.3333, 0.3333 | Empate (todos iguales) | Las entradas iguales dan una distribución uniforme, 1/3 cada una. |
| (1, 2, 3) | 0.0900, 0.2447, 0.6652 | 3..ª | Las diferencias de 1 entre las entradas dan una salida moderadamente confiada. |
| (-1, 0, 1) | 0.0900, 0.2447, 0.6652 | 3.ª | Idéntico a (1, 2, 3) porque es el mismo vector desplazado en 2. |
| (0, 0, 5) | 0.0066, 0.0066, 0.9867 | 3.ª | Una entrada grande domina; las dos entradas iguales comparten el resto por igual. |
| (2, 4, 6) | 0.0159, 0.1173, 0.8668 | 3.ª | El vector (1, 2, 3) multiplicado por 2 es más pronunciado. |
| (10, 20, 30) | ≈0.0000 (2.06×10⁻⁹), ≈0.0000 (4.54×10⁻⁵), 1.0000 (0.99995) | 3.ª | Casi one-hot. El truco de restar el máximo evita el desbordamiento con entradas grandes. |
Efecto de escalado: multiplicar cada entrada por un factor mayor que 1 amplía las diferencias entre ellas, de modo que la entrada más grande gana probabilidad y la distribución se vuelve más pronunciada. El ranking (argmax) nunca cambia. Escalar por un factor entre 0 y 1 aplana la distribución hacia la uniformidad.
Preguntas frecuentes
¿Por qué las salidas siempre suman 1? Porque cada exponencial se divide entre la suma de todas las exponenciales; esa normalización garantiza que el total sea 1.
¿Qué ocurre si todas las entradas son iguales? El resultado es una distribución uniforme en la que cada salida vale \(1/K\).
¿Sumar una constante a cada entrada cambia el resultado? No. El softmax es invariante a desplazamientos: sumar la misma constante c a todas las entradas no altera la salida, y por eso restar el máximo es totalmente seguro.