Hàm softmax là gì?
Hàm softmax nhận vào một vector gồm K số thực và biến nó thành một phân phối xác suất: mọi giá trị đầu ra đều nằm trong khoảng từ 0 đến 1, và tổng của cả K giá trị bằng đúng 1. Đây là hàm kích hoạt tiêu chuẩn ở lớp đầu ra của các mô hình phân loại trong mạng nơ-ron, nơi nó chuyển các điểm số thô của mô hình (logits) thành xác suất cho từng lớp. Vì hàm này không có thứ nguyên nên các giá trị đầu vào chỉ là những con số thuần túy, không kèm đơn vị.
Cách dùng máy tính này
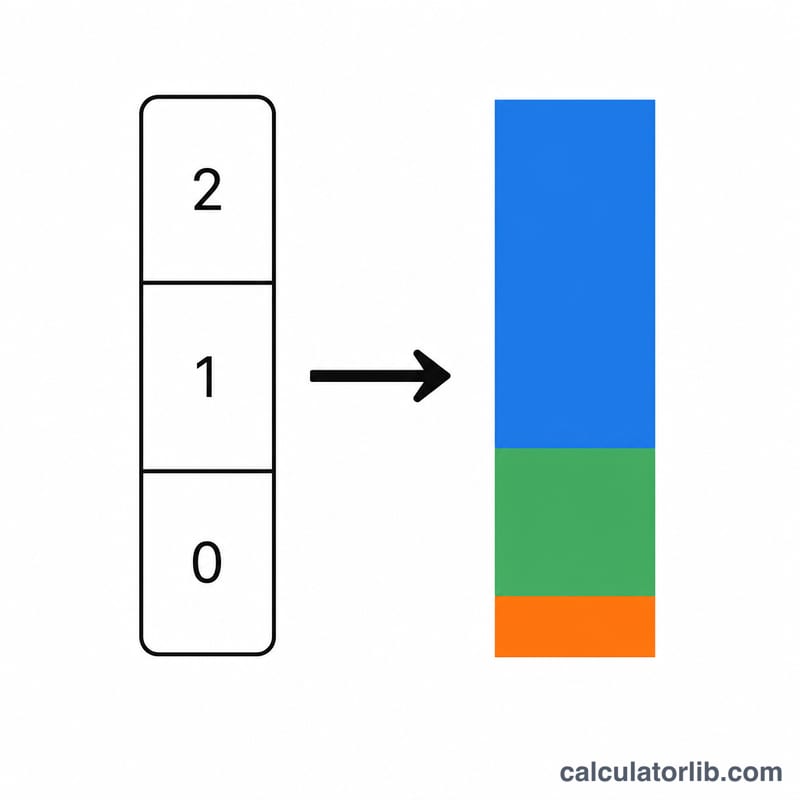
Hãy nhập vector của bạn vào ô như một dãy số, phân tách bằng dấu phẩy, khoảng trắng hoặc xuống dòng (ví dụ 1, 2, 3). Các số có thể là số dương, số âm, số 0 hay số thập phân. Nhấn nút tính, bạn sẽ nhận được xác suất softmax cho từng thành phần, tổng các giá trị đầu ra (phải bằng 1) và argmax — chỉ số (bắt đầu từ 1) của xác suất lớn nhất.
Giải thích công thức
Với mỗi thành phần j, công thức softmax là \(\sigma(z)_j = e^{z_j} / \sum_k e^{z_k}\). Việc lấy lũy thừa cơ số e làm cho mọi số hạng đều dương, còn việc chia cho tổng sẽ chuẩn hóa chúng để tổng bằng 1. Để đảm bảo ổn định về mặt số học, máy tính này trừ giá trị lớn nhất \(m\) khỏi từng phần tử trước khi lấy lũy thừa:
$$\sigma(\mathbf{x})_i = \frac{e^{\,x_i - \max(\mathbf{x})}}{\displaystyle\sum_{j=1}^{K} e^{\,x_j - \max(\mathbf{x})}}$$Thừa số chung \(e^{-m}\) bị triệt tiêu, cho kết quả y hệt nhưng tránh được tràn số khi đầu vào quá lớn.
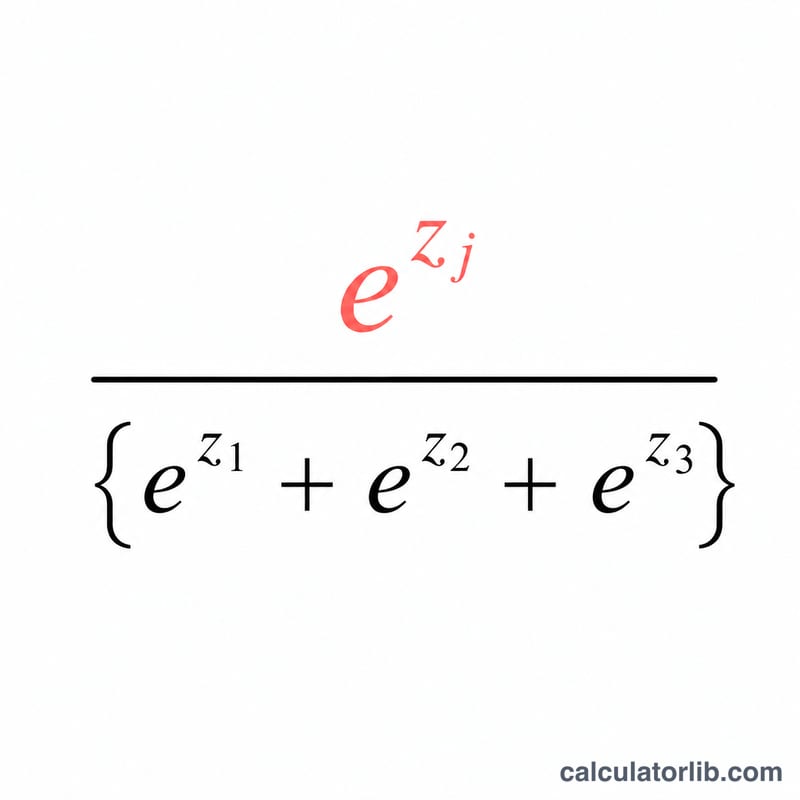
Ví dụ minh họa
Với \(z = (1, 2, 3)\): \(e^{1} = 2{,}71828\), \(e^{2} = 7{,}38906\), \(e^{3} = 20{,}08554\), cộng lại bằng \(30{,}19287\). Chia mỗi giá trị ta được \(\sigma = (0{,}09003,\ 0{,}24473,\ 0{,}66524)\), tổng bằng 1. Argmax là chỉ số 3 — đầu vào lớn nhất — với xác suất \(0{,}66524\).
Đầu ra Softmax cho các vectơ đầu vào khác nhau
Bảng cho thấy đầu ra softmax của một số vectơ đầu vào, được tính theo \(\sigma(\mathbf{x})_i = e^{x_i - \max(\mathbf{x})} / \sum_j e^{x_j - \max(\mathbf{x})}\). Các giá trị được làm tròn đến 4 chữ số thập phân, và các đầu ra luôn có tổng bằng 1.
| Vectơ đầu vào | Đầu ra Softmax | Argmax (vị trí) | Nhận xét |
|---|---|---|---|
| (1, 1, 1) | 0.3333, 0.3333, 0.3333 | Hòa (tất cả bằng nhau) | Các đầu vào bằng nhau cho phân phối đều, mỗi giá trị 1/3. |
| (1, 2, 3) | 0.0900, 0.2447, 0.6652 | thứ 3 | Khoảng cách 1 giữa các đầu vào cho đầu ra có độ tin cậy vừa phải. |
| (-1, 0, 1) | 0.0900, 0.2447, 0.6652 | thứ 3 | Giống hệt (1, 2, 3) vì đây là cùng vectơ được dịch chuyển đi 2. |
| (0, 0, 5) | 0.0066, 0.0066, 0.9867 | thứ 3 | Một đầu vào lớn chiếm ưu thế; hai đầu vào bằng nhau chia đều phần còn lại. |
| (2, 4, 6) | 0.0159, 0.1173, 0.8668 | thứ 3 | Vectơ (1, 2, 3) nhân với 2 cho kết quả sắc nét hơn. |
| (10, 20, 30) | ≈0.0000 (2.06×10⁻⁹), ≈0.0000 (4.54×10⁻⁵), 1.0000 (0.99995) | thứ 3 | Gần như one-hot. Kỹ thuật trừ giá trị lớn nhất tránh tràn số với đầu vào lớn. |
Hiệu ứng co giãn: nhân mọi đầu vào với một hệ số lớn hơn 1 làm tăng khoảng cách giữa chúng, nên phần tử lớn nhất có thêm xác suất và phân phối trở nên sắc nét hơn. Thứ tự xếp hạng (argmax) không bao giờ thay đổi. Nhân với hệ số nằm giữa 0 và 1 làm phân phối phẳng hơn, tiến về phân phối đều.
Câu hỏi thường gặp
Vì sao tổng các giá trị đầu ra luôn bằng 1? Vì mỗi lũy thừa đều được chia cho tổng của tất cả các lũy thừa, nên quá trình chuẩn hóa đảm bảo tổng luôn bằng 1.
Nếu tất cả đầu vào bằng nhau thì sao? Kết quả sẽ là một phân phối đều, trong đó mỗi giá trị đầu ra đều bằng \(1/K\).
Cộng thêm một hằng số vào mọi đầu vào có làm thay đổi kết quả không? Không. Softmax bất biến với phép dịch: cộng cùng một hằng số \(c\) vào tất cả các đầu vào không làm thay đổi kết quả — và đó chính là lý do việc trừ đi giá trị lớn nhất là an toàn.