什麼是 Softmax 函數?
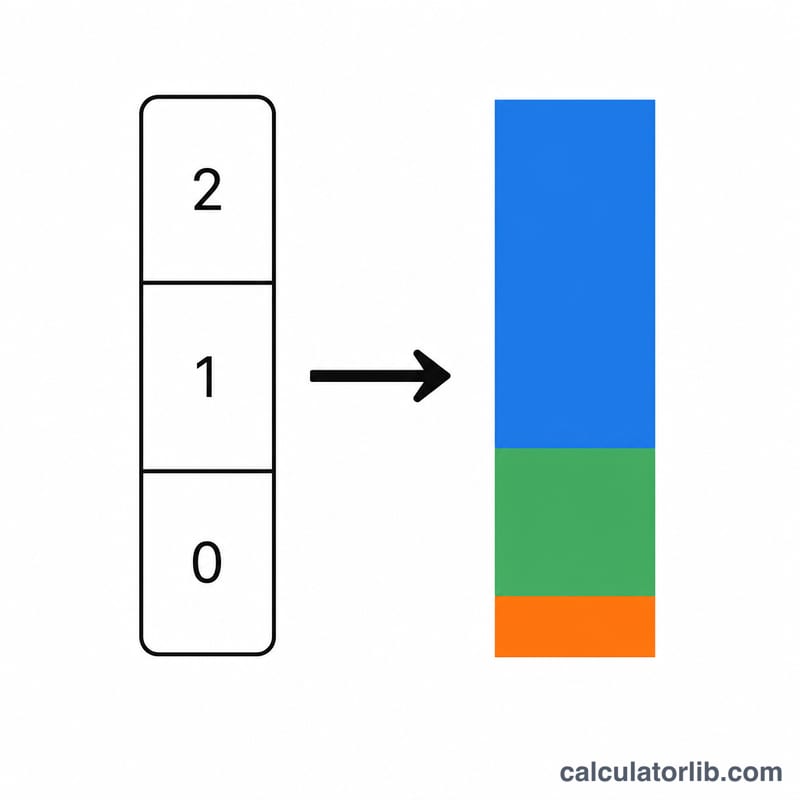
Softmax 函數會接收一個含有 K 個實數的向量,並將其轉換為一組機率分布:每個輸出值都嚴格落在 0 與 1 之間,而且全部 K 個輸出值相加恰好等於 1。它是神經網路分類器輸出層最常用的激活函數,能把模型輸出的原始分數(logits)轉換成各類別的機率。由於 Softmax 本身是無量綱的,因此輸入值都是純數值,不帶任何單位。
如何使用本計算機
在輸入框中填入你的向量,數字之間以逗號、空格或換行分隔皆可(例如 1, 2, 3)。數字可以是正數、負數、零或小數。按下計算後,你會得到每個元素對應的 Softmax 機率、所有輸出值的總和(理論上應等於 1),以及 argmax——也就是最大機率所在位置的索引(從 1 開始計算)。
公式解析
對於第 j 個元素,Softmax 的計算方式為 \(\sigma(z)_j = e^{z_j} / \sum_{k} e^{z_k}\)。取指數可讓每一項都變成正值,再除以總和進行正規化,使所有結果加總為 1。為了確保數值穩定,本計算機在取指數之前會先從每個元素中減去最大值 \(m\):
$$\sigma(z)_j = \frac{e^{z_j-m}}{\displaystyle\sum_{k} e^{z_k-m}}$$由於共同因子 \(e^{-m}\) 會互相抵消,因此結果完全相同,同時又能避免在輸入值過大時發生溢位。
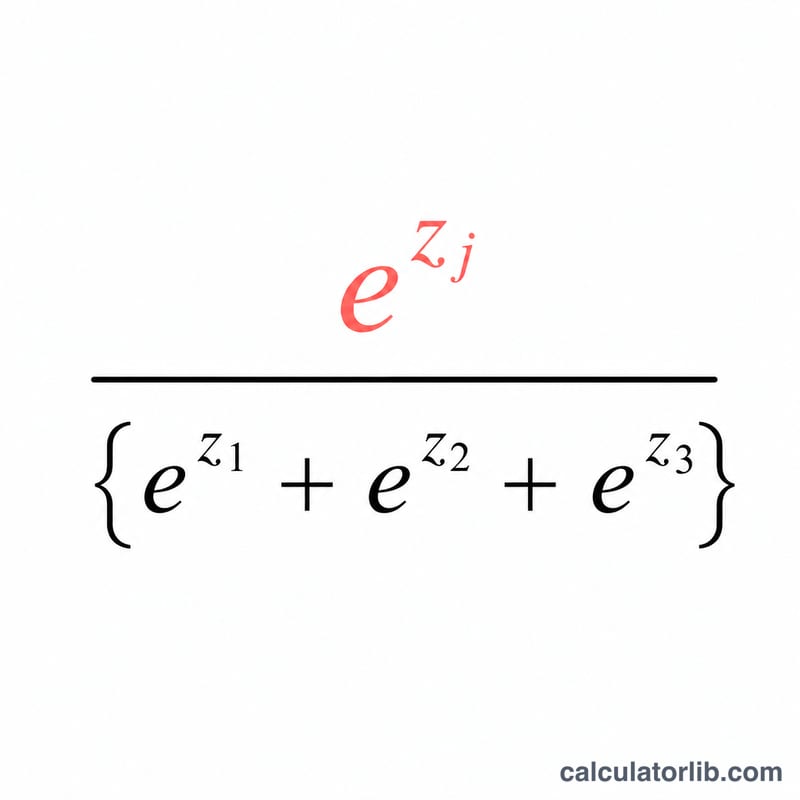
實際範例
以 \(z = (1, 2, 3)\) 為例:\(e^{1} = 2.71828\)、\(e^{2} = 7.38906\)、\(e^{3} = 20.08554\),總和為 \(30.19287\)。各項分別除以總和後得到
$$\sigma = (0.09003,\ 0.24473,\ 0.66524)$$加總恰好為 1。argmax 為索引 3,對應最大的輸入值,其機率為 \(0.66524\)。
不同輸入向量的 Softmax 輸出
下表顯示數個輸入向量的 softmax 輸出,計算公式為 \(\sigma(\mathbf{x})_i = e^{x_i - \max(\mathbf{x})} / \sum_j e^{x_j - \max(\mathbf{x})}\)。數值四捨五入至小數點後 4 位,且輸出值總和恆為 1。
| 輸入向量 | Softmax 輸出 | 最大值位置(argmax) | 說明 |
|---|---|---|---|
| (1, 1, 1) | 0.3333, 0.3333, 0.3333 | 平手(全部相等) | 輸入值相等時,分布為均勻分布,每項為 1/3。 |
| (1, 2, 3) | 0.0900, 0.2447, 0.6652 | 第 3 個 | 輸入值之間相差 1 時,輸出的信心程度中等。 |
| (-1, 0, 1) | 0.0900, 0.2447, 0.6652 | 第 3 個 | 與 (1, 2, 3) 相同,因為這是同一向量平移 2 後的結果。 |
| (0, 0, 5) | 0.0066, 0.0066, 0.9867 | 第 3 個 | 一個較大的輸入值佔主導;兩個相等的輸入值平均分享剩餘機率。 |
| (2, 4, 6) | 0.0159, 0.1173, 0.8668 | 第 3 個 | 向量 (1, 2, 3) 乘以 2 後,分布更為集中。 |
| (10, 20, 30) | ≈0.0000 (2.06×10⁻⁹), ≈0.0000 (4.54×10⁻⁵), 1.0000 (0.99995) | 第 3 個 | 幾乎為獨熱(one-hot)分布。減去最大值的技巧可避免輸入值較大時發生溢位。 |
縮放效應:將每個輸入值乘以大於 1 的倍數,會拉大它們之間的差距,使最大的項獲得更高的機率,分布因而變得更集中。排序(argmax)永遠不會改變。以介於 0 與 1 之間的倍數縮放,則會使分布趨向均勻。
常見問題
為什麼輸出值的總和永遠是 1?因為每一項指數值都會除以所有指數值的總和,這種正規化處理保證了總和必定為 1。
如果所有輸入值都相等會怎樣?結果會是均勻分布,每個輸出值都等於 \(1/K\)。
對每個輸入值都加上一個常數,會改變結果嗎?不會。Softmax 具有平移不變性:對所有輸入值同時加上相同的常數 \(c\),輸出結果不變——這正是為什麼減去最大值是安全做法的原因。