什么是 Softmax 函数?
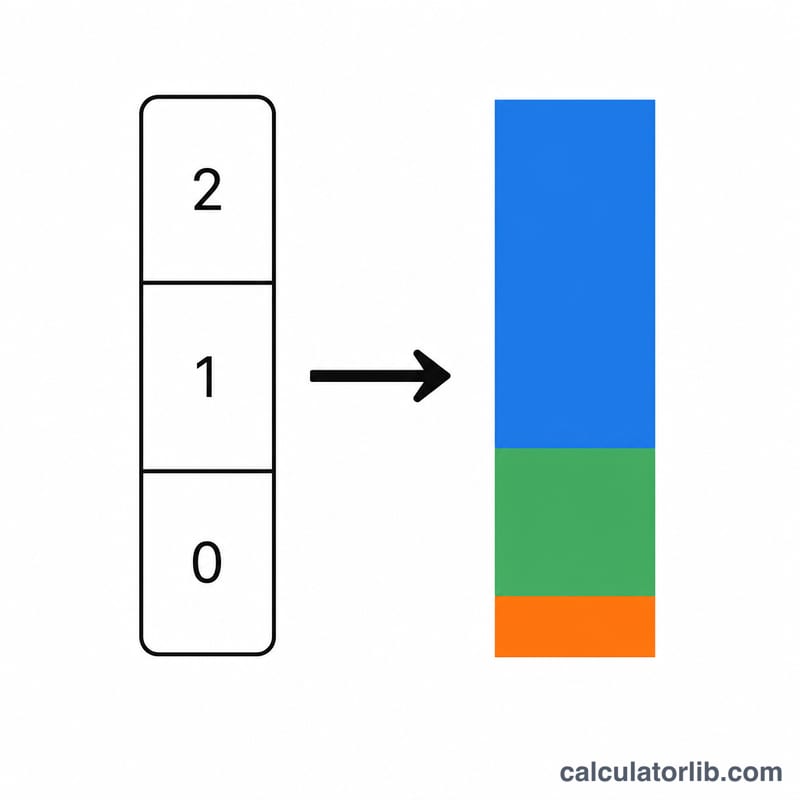
Softmax 函数可以把一个包含 K 个实数的向量转换成一组概率分布:每个输出值都严格介于 0 和 1 之间,且全部 K 个输出值相加恰好等于 1。它是神经网络分类器输出层最常用的激活函数,能够把模型的原始得分(logits)转换为各个类别的概率。由于 Softmax 是无量纲的,所以输入值都是没有单位的纯数字。
如何使用本计算器
在输入框中填入你的向量,数字之间用逗号、空格或换行分隔即可(例如 1, 2, 3)。这些数字可以是正数、负数、零或小数。点击计算后,你将得到每个分量对应的 Softmax 概率、所有输出值的总和(应等于 1),以及 argmax——即最大概率所在的位置(从 1 开始计数的索引)。
公式详解
对于第 j 个分量,Softmax 的计算公式为 \(\sigma(z)_j = e^{z_j} / \sum_{k} e^{z_k}\)。取指数运算可以让每一项都变成正数,再除以总和进行归一化,使它们相加等于 1。为了保证数值稳定,本计算器会在取指数之前,先从每个元素中减去最大值 \(m\):
$$\sigma(z)_j = \frac{e^{\,z_j - m}}{\displaystyle\sum_{k} e^{\,z_k - m}}$$其中的公共因子 \(e^{-m}\) 会在上下相约后抵消,因此结果完全相同,同时还能避免输入值过大时发生溢出。
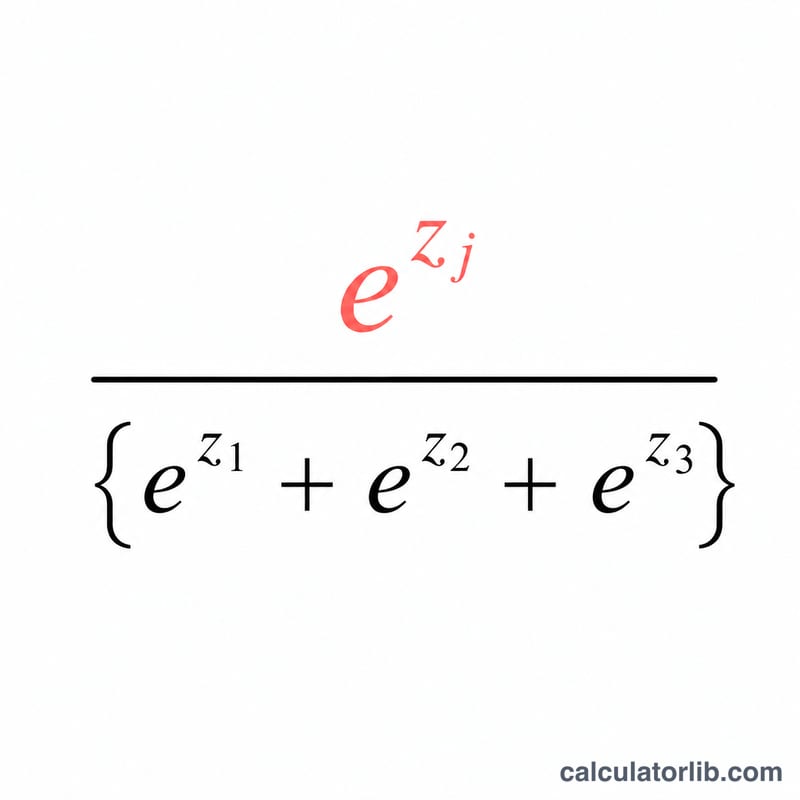
实例演示
以 \(z = (1, 2, 3)\) 为例:\(e^{1} = 2.71828\),\(e^{2} = 7.38906\),\(e^{3} = 20.08554\),三者之和为 \(30.19287\)。用每一项分别除以这个总和,得到 \(\sigma = (0.09003, 0.24473, 0.66524)\),它们相加正好等于 1。argmax 为索引 3,对应最大的输入值,其概率为 \(0.66524\)。
不同输入向量的 Softmax 输出
下表给出了若干输入向量的 softmax 输出,计算公式为 \(\sigma(\mathbf{x})_i = e^{x_i - \max(\mathbf{x})} / \sum_j e^{x_j - \max(\mathbf{x})}\)。数值四舍五入至 4 位小数,且输出结果之和始终为 1。
| 输入向量 | Softmax 输出 | 最大值位置(Argmax) | 说明 |
|---|---|---|---|
| (1, 1, 1) | 0.3333, 0.3333, 0.3333 | 并列(全部相等) | 输入值相等时分布均匀,每项为 1/3。 |
| (1, 2, 3) | 0.0900, 0.2447, 0.6652 | 第 3 位 | 输入值之间相差 1 时,输出的置信度中等。 |
| (-1, 0, 1) | 0.0900, 0.2447, 0.6652 | 第 3 位 | 与 (1, 2, 3) 相同,因为它是同一向量平移 2 之后得到的。 |
| (0, 0, 5) | 0.0066, 0.0066, 0.9867 | 第 3 位 | 一个较大的输入占据主导;两个相等的输入平均分配剩余概率。 |
| (2, 4, 6) | 0.0159, 0.1173, 0.8668 | 第 3 位 | 向量 (1, 2, 3) 乘以 2 后分布更加尖锐。 |
| (10, 20, 30) | ≈0.0000 (2.06×10⁻⁹), ≈0.0000 (4.54×10⁻⁵), 1.0000 (0.99995) | 第 3 位 | 接近独热(one-hot)分布。最大值减法技巧可避免大输入值下的溢出。 |
缩放效应:将每个输入乘以大于 1 的系数会扩大它们之间的差距,因此最大项获得更多概率,分布变得更尖锐。排序(argmax)永远不会改变。乘以 0 到 1 之间的系数则会使分布趋向均匀。
常见问题
为什么输出值的总和始终等于 1?因为每个指数项都被所有指数项的总和除过一次,这种归一化处理保证了它们相加必然为 1。
如果所有输入值都相等会怎样?结果会是一个均匀分布,每个输出值都等于 \(1/K\)。
给每个输入都加上同一个常数,结果会改变吗?不会。Softmax 具有平移不变性:给所有输入加上相同的常数 \(c\),输出结果保持不变——这正是「减去最大值」这一做法安全可靠的原因。