यह कैलकुलेटर क्या करता है
माध्य और मानक विचलन कैलकुलेटर आपके दिए गए संख्याओं की सूची से माध्य (औसत), प्रसरण (variance) और मानक विचलन (standard deviation) निकालकर देता है। माध्य बताता है कि आपका डेटा किस केंद्र के आसपास टिका है, जबकि मानक विचलन यह मापता है कि मान उस केंद्र से कितने फैले हुए हैं। छोटा मानक विचलन यानी मान माध्य के आसपास सिमटे हुए हैं; बड़ा मानक विचलन यानी मान दूर-दूर तक बिखरे हुए हैं।
इसका उपयोग कैसे करें
अपनी संख्याएँ इनपुट बॉक्स में टाइप करें या पेस्ट करें — इन्हें कॉमा या स्पेस से अलग करें। अगर आपका डेटा किसी बड़े समूह में से लिया गया एक हिस्सा (नमूना) है तो Sample चुनें, और अगर यह पूरे समूह को दर्शाता है तो Population चुनें। इसके बाद कैलकुलेटर आपको माध्य, प्रसरण, मानक विचलन, संख्याओं की गिनती और उनका योग दिखा देगा।
सूत्रों की समझ
सबसे पहले माध्य \(\bar{x}\) निकालें, जहाँ \(n\) मानों की गिनती है और \(x_i\) हर एक मान है:
$$\bar{x} = \frac{1}{n}\sum_{i=1}^{n} x_i$$इसके बाद हर मान का माध्य से अंतर (विचलन) निकालें, उसका वर्ग करें, और इन वर्गों का औसत लें। सैंपल वाले सूत्र में \(n-1\) से भाग दिया जाता है, जबकि पॉपुलेशन वाले सूत्र में \(n\) से:
$$s = \sqrt{\frac{1}{n-1}\sum_{i=1}^{n}(x_i - \bar{x})^2} \qquad \sigma = \sqrt{\frac{1}{n}\sum_{i=1}^{n}(x_i - \mu)^2}$$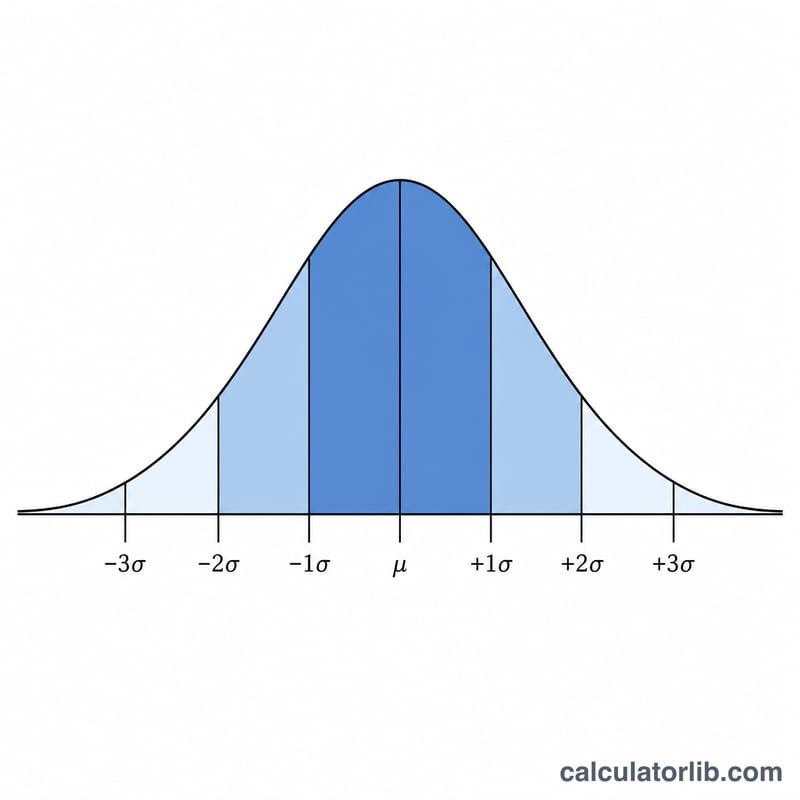
हल किया हुआ उदाहरण
मान लीजिए डेटा सेट है 2, 4, 4, 4, 5, 5, 7, 9। इसमें \(n = 8\) मान हैं जिनका योग 40 है, इसलिए माध्य होगा:
$$\bar{x} = \frac{2+4+4+4+5+5+7+9}{8} = 5$$5 से लिए गए विचलनों के वर्गों का योग 32 आता है। पॉपुलेशन सूत्र का उपयोग करने पर:
$$\sigma = \sqrt{\frac{32}{8}} = \sqrt{4} = 2$$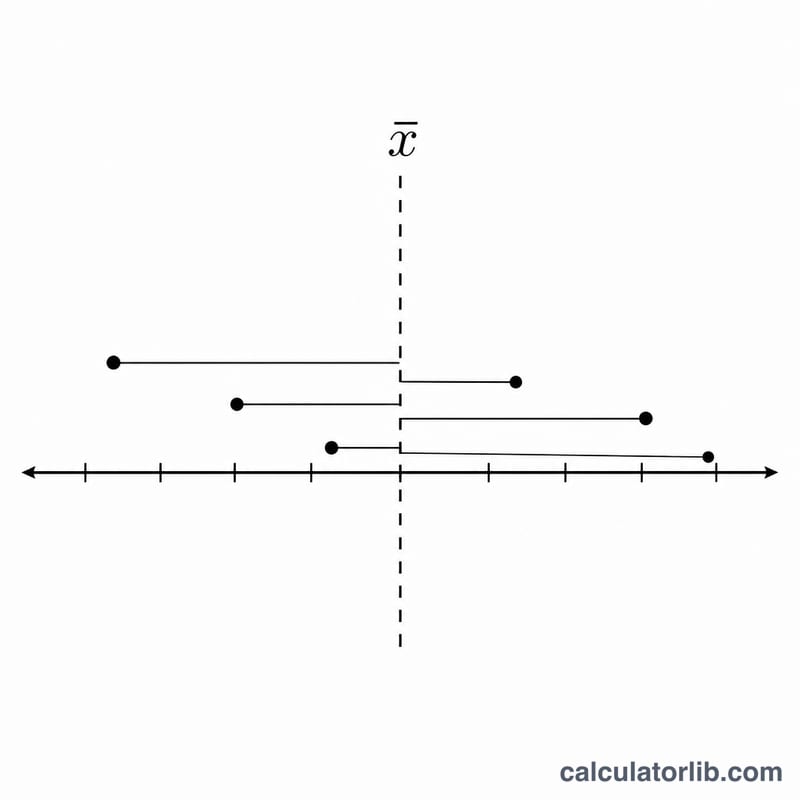
और हल किए गए उदाहरण
ये उदाहरण हर बार वही प्रक्रिया अपनाते हैं: माध्य \(\bar{x}\) निकालें, उसे प्रत्येक मान में से घटाकर विचलन प्राप्त करें, उन विचलनों का वर्ग करें, उन्हें जोड़ें, प्रतिदर्श (सैंपल) के लिए \(n-1\) से या समष्टि (पॉपुलेशन) के लिए \(n\) से भाग दें, और अंत में वर्गमूल लें। मानक विचलन के इन दोनों संस्करणों के बीच एकमात्र अंतर यह है कि आप किससे भाग देते हैं।
उदाहरण 1 — एक ही डेटा पर प्रतिदर्श बनाम समष्टि
डेटा समुच्चय (8 मान): 2, 4, 4, 4, 5, 5, 7, 9।
चरण 1 — माध्य:
$$\bar{x} = \frac{2+4+4+4+5+5+7+9}{8} = \frac{40}{8} = 5$$चरण 2 — वर्गित विचलन:
| \(x_i\) | \(x_i - \bar{x}\) | \((x_i - \bar{x})^2\) |
|---|---|---|
| 2 | -3 | 9 |
| 4 | -1 | 1 |
| 4 | -1 | 1 |
| 4 | -1 | 1 |
| 5 | 0 | 0 |
| 5 | 0 | 0 |
| 7 | 2 | 4 |
| 9 | 4 | 16 |
चरण 3 — वर्गों का योग:
$$\sum_{i=1}^{n}(x_i - \bar{x})^2 = 9+1+1+1+0+0+4+16 = 32$$चरण 4 — प्रसरण और मानक विचलन। \(n = 8\) के साथ:
प्रतिदर्श (\(n-1 = 7\) से भाग दें):
$$s^2 = \frac{32}{7} \approx 4.5714 \qquad s = \sqrt{4.5714} \approx 2.1381$$समष्टि (\(n = 8\) से भाग दें):
$$\sigma^2 = \frac{32}{8} = 4 \qquad \sigma = \sqrt{4} = 2$$अतः वही डेटा प्रतिदर्श मानक विचलन 2.1381 और समष्टि मानक विचलन 2 देता है। प्रतिदर्श मान थोड़ा बड़ा है क्योंकि छोटी संख्या \(n-1\) से भाग देने पर परिणाम बढ़ जाता है — यह वह मानक सुधार है जिसका उपयोग तब किया जाता है जब डेटा किसी बड़े समूह से लिया गया केवल एक प्रतिदर्श ही होता है।
उदाहरण 2 — दशमलव और ऋणात्मक मान
डेटा समुच्चय (5 मान): -2, -1, 0, 3, 5।
माध्य:
$$\bar{x} = \frac{-2 + (-1) + 0 + 3 + 5}{5} = \frac{5}{5} = 1$$वर्गित विचलन:
| \(x_i\) | \(x_i - \bar{x}\) | \((x_i - \bar{x})^2\) |
|---|---|---|
| -2 | -3 | 9 |
| -1 | -2 | 4 |
| 0 | -1 | 1 |
| 3 | 2 | 4 |
| 5 | 4 | 16 |
वर्गों का योग:
$$\sum_{i=1}^{n}(x_i - \bar{x})^2 = 9+4+1+4+16 = 34$$प्रसरण और मानक विचलन (\(n = 5\) के साथ):
$$s^2 = \frac{34}{4} = 8.5 \qquad s = \sqrt{8.5} \approx 2.9155$$$$\sigma^2 = \frac{34}{5} = 6.8 \qquad \sigma = \sqrt{6.8} \approx 2.6077$$ऋणात्मक मानों को बिलकुल धनात्मक मानों की तरह ही संभाला जाता है — विचलनों का वर्ग करने से चिह्न हट जाता है, इसलिए माध्य से नीचे का कोई मान उतना ही फैलाव देता है जितना उसी दूरी पर माध्य से ऊपर का कोई मान।
उदाहरण 3 — समान अंतराल पर स्थित मान
डेटा समुच्चय (5 मान): 10, 20, 30, 40, 50।
माध्य:
$$\bar{x} = \frac{10+20+30+40+50}{5} = \frac{150}{5} = 30$$वर्गित विचलन: विचलन हैं -20, -10, 0, 10, 20, अतः वर्ग हैं 400, 100, 0, 100, 400।
$$\sum_{i=1}^{n}(x_i - \bar{x})^2 = 400+100+0+100+400 = 1000$$प्रसरण और मानक विचलन (\(n = 5\) के साथ):
$$s^2 = \frac{1000}{4} = 250 \qquad s = \sqrt{250} \approx 15.8114$$$$\sigma^2 = \frac{1000}{5} = 200 \qquad \sigma = \sqrt{200} \approx 14.1421$$भले ही मान पूरी तरह समान अंतराल पर स्थित हों, मानक विचलन स्वयं वह अंतराल (10) नहीं है — यह माध्य से दूरी का एक मूल-माध्य-वर्ग माप है, जो यहाँ पूरी समष्टि के लिए लगभग 14.14 आता है।
अपने परिणाम की व्याख्या करना
मानक विचलन आपको किसी डेटा मान और माध्य के बीच की विशिष्ट दूरी बताता है, जो आपके डेटा की उन्हीं इकाइयों में व्यक्त होती है। छोटा मानक विचलन इसका अर्थ है कि मान माध्य के आसपास घनी रूप से एकत्रित हैं; बड़ा मानक विचलन इसका अर्थ है कि वे व्यापक रूप से बिखरे हुए हैं। अकेले में यह संख्या तब सबसे उपयोगी होती है जब इसकी तुलना माध्य के साथ और उसी तरीके से मापे गए अन्य डेटा समुच्चयों के फैलाव के साथ की जाए।
आनुभविक (68–95–99.7) नियम
जब कोई डेटा समुच्चय लगभग प्रसामान्य रूप से वितरित (नॉर्मली डिस्ट्रिब्यूटेड) होता है (परिचित सममित घंटी के आकार का), तो मानक विचलन \(\sigma\) माध्य \(\bar{x}\) के आसपास डेटा के पूर्वानुमेय अनुपातों को रेखांकित करता है:
- लगभग 68% मान माध्य के \(\pm 1\sigma\) के भीतर आते हैं — अंतराल \(\bar{x} - \sigma\) से \(\bar{x} + \sigma\) तक।
- लगभग 95% मान \(\pm 2\sigma\) के भीतर आते हैं।
- लगभग 99.7% मान \(\pm 3\sigma\) के भीतर आते हैं।
उदाहरण के लिए, यदि मापों के किसी समुच्चय का \(\bar{x} = 100\) और \(\sigma = 15\) है, तो लगभग 68% डेटा 85 और 115 के बीच होता है, लगभग 95% डेटा 70 और 130 के बीच होता है, और लगभग सारा डेटा 55 और 145 के बीच होता है। यह नियम एक सन्निकटन है जो केवल लगभग घंटी के आकार वाले डेटा के लिए ही सही होता है — अत्यधिक विषम (स्क्यूड) या भारी-पुच्छ (हेवी-टेल्ड) वितरणों के लिए वास्तविक प्रतिशत काफी भिन्न हो सकते हैं।
यह तय करना कि कोई मान विशिष्ट है या बाह्यमान (आउटलायर)
किसी एकल मान का आकलन करने के लिए, मापें कि वह माध्य से कितने मानक विचलन दूर स्थित है। यह मानकीकृत अंक, या z-अंक है:
$$z = \frac{x - \bar{x}}{\sigma}$$जिस मान का \(|z|\) लगभग 1 से कम है वह बहुत सामान्य है; \(|z|\) 2 के निकट कुछ हद तक असामान्य है (प्रसामान्य डेटा का केवल लगभग 5% ही \(\pm 2\sigma\) से परे होता है); और \(|z|\) 3 या उससे अधिक होना दुर्लभ है (प्रसामान्य डेटा का 0.3% से कम), यही कारण है कि \(\pm 2\sigma\) या \(\pm 3\sigma\) संभावित बाह्यमानों को चिह्नित करने के लिए सामान्य अनौपचारिक सीमाएँ हैं। ये डेटा की जाँच के लिए परिपाटियाँ हैं, कोई निश्चित परीक्षण नहीं — एक बड़ा z-अंक ऐसे बिंदु का संकेत देता है जिसकी जाँच करना उचित है, स्वतः ही कोई त्रुटि नहीं।
विचरण गुणांक (कोएफिशिएंट ऑफ वेरिएशन) — सापेक्ष फैलाव
चूँकि मानक विचलन के साथ इकाइयाँ जुड़ी होती हैं, भिन्न पैमानों या इकाइयों वाले डेटा समुच्चयों के फैलाव की तुलना करना भ्रामक हो सकता है। विचरण गुणांक (CV) इसे माध्य के एक अंश (या प्रतिशत) के रूप में पुनः मापता है:
$$\text{CV} = \frac{\sigma}{\bar{x}}$$जिस डेटा समुच्चय का \(\bar{x} = 30\) और \(\sigma \approx 15.81\) है, उसका \(\text{CV} \approx 15.81 / 30 \approx 0.527\) है, अर्थात लगभग 52.7% — एक अपेक्षाकृत उच्च फैलाव। 5% का CV इंगित करता है कि मान माध्य के निकट घनी रूप से समूहित हैं, जबकि 50% या अधिक उच्च सापेक्ष परिवर्तनशीलता को इंगित करता है। CV केवल धनात्मक माध्य वाले अनुपात पैमाने पर मापे गए डेटा के लिए ही सार्थक है; जब माध्य शून्य या शून्य के निकट होता है तो यह अपरिभाषित या अस्थिर होता है, और इसका उपयोग ऐसे डेटा के लिए नहीं किया जाना चाहिए जो ऋणात्मक हो सकता है (जैसे सेल्सियस में तापमान या लाभ-हानि के आँकड़े)।
अक्सर पूछे जाने वाले सवाल
Sample और Population में क्या फर्क है? जब आपके डेटा में समूह का हर सदस्य शामिल हो, तब पॉपुलेशन मानक विचलन का उपयोग करें। जब आपका डेटा केवल एक नमूना हो, तब सैंपल मानक विचलन का उपयोग करें, जो \(n-1\) से भाग देता है और असली फैलाव का ज़्यादा सटीक (कम पक्षपाती) अनुमान देता है।
विचलनों का वर्ग क्यों करते हैं? वर्ग करने से हर विचलन धनात्मक हो जाता है और बड़ी त्रुटियों को ज़्यादा महत्व मिलता है; अंत में वर्गमूल लेने पर नतीजा वापस मूल इकाइयों में आ जाता है।
प्रसरण (variance) मुझे क्या बताता है? प्रसरण विचलनों के वर्गों का औसत होता है और मानक विचलन के वर्ग के बराबर होता है। यह कई सांख्यिकीय सूत्रों में काम आता है, पर इसे वर्ग इकाइयों में व्यक्त किया जाता है।