Что делает этот калькулятор
Калькулятор среднего значения и стандартного отклонения принимает список чисел и возвращает среднее (среднее арифметическое), дисперсию и стандартное отклонение. Среднее показывает центр ваших данных, а стандартное отклонение — насколько сильно значения разбросаны вокруг этого центра. Небольшое стандартное отклонение означает, что значения плотно сгруппированы возле среднего; большое — что они разбросаны широко.
Как пользоваться
Введите или вставьте числа в поле ввода, разделяя их запятыми или пробелами. Выберите Выборка, если ваши данные — это часть, взятая из большей совокупности, или Генеральная совокупность, если они охватывают всю группу целиком. Калькулятор рассчитает среднее, дисперсию, стандартное отклонение, количество значений и сумму.
Разбор формул
Сначала вычисляем среднее \(\bar{x}\), где \(n\) — количество значений, а \(x_i\) — каждое отдельное значение:
$$\bar{x} = \frac{1}{n}\sum_{i=1}^{n} x_i$$Затем для каждого значения находим отклонение от среднего, возводим его в квадрат и усредняем полученные квадраты. В выборочной версии делим на \(n-1\), а в версии для генеральной совокупности — на \(n\):
$$s = \sqrt{\frac{1}{n-1}\sum_{i=1}^{n}(x_i - \bar{x})^2} \qquad \sigma = \sqrt{\frac{1}{n}\sum_{i=1}^{n}(x_i - \mu)^2}$$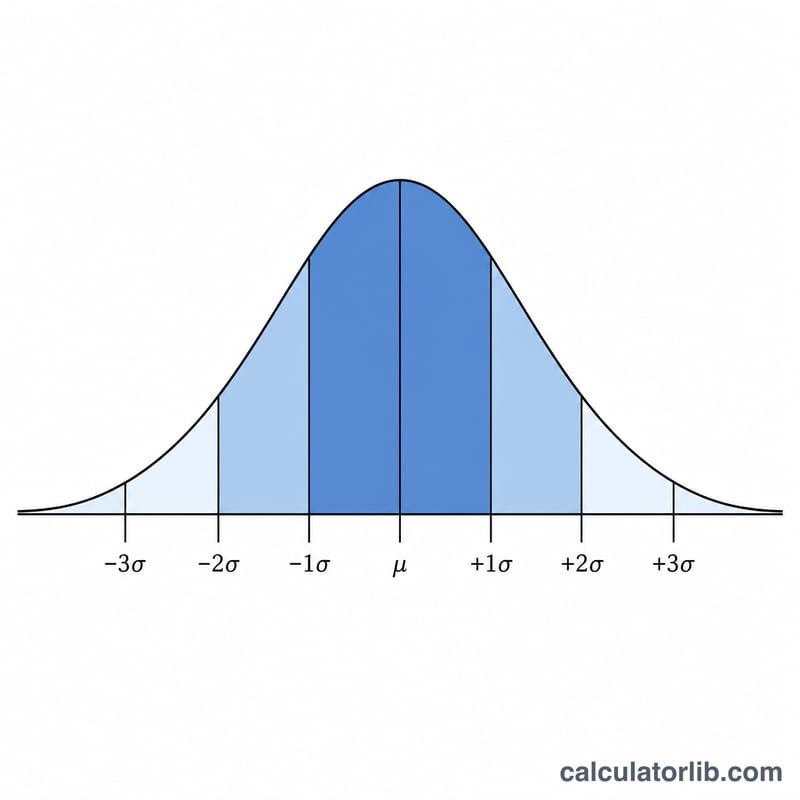
Пример с решением
Возьмём набор данных 2, 4, 4, 4, 5, 5, 7, 9. Здесь \(n = 8\) значений, сумма которых равна 40, поэтому среднее равно:
$$\bar{x} = \frac{2+4+4+4+5+5+7+9}{8} = 5$$Сумма квадратов отклонений от 5 составляет 32. По формуле для генеральной совокупности:
$$\sigma = \sqrt{\frac{32}{8}} = \sqrt{4} = 2$$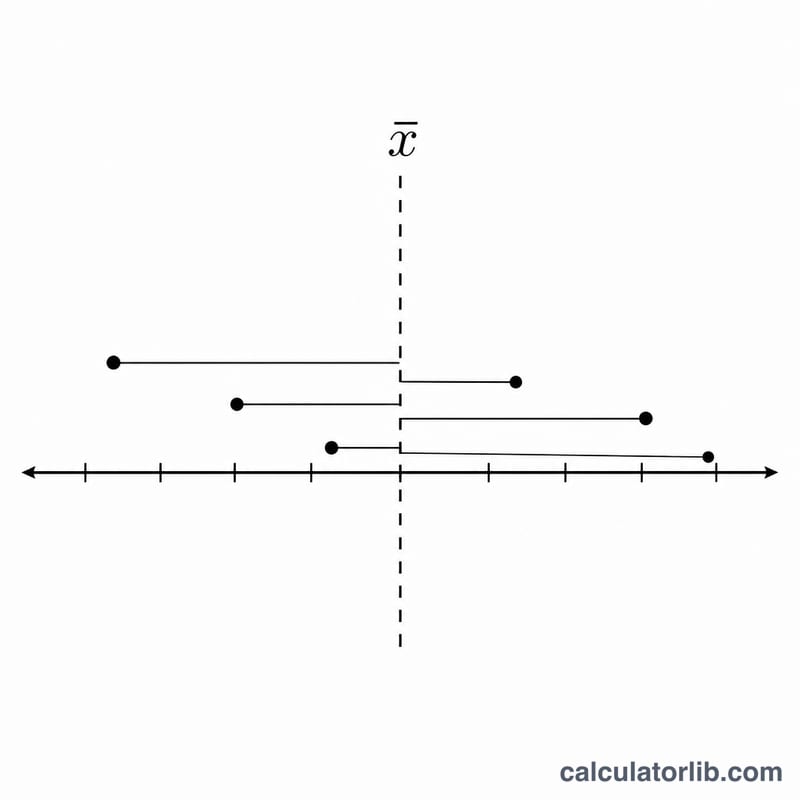
Частые вопросы
В чём разница между выборкой и генеральной совокупностью? Используйте стандартное отклонение генеральной совокупности, когда ваши данные включают всех членов группы. Используйте выборочное стандартное отклонение, которое делит на \(n-1\), когда данные представляют лишь часть совокупности, — так получается менее смещённая оценка реального разброса.
Зачем возводить отклонения в квадрат? Возведение в квадрат делает каждое отклонение положительным и придаёт больший вес крупным ошибкам; извлечение квадратного корня в конце возвращает результат к исходным единицам измерения.
Что показывает дисперсия? Дисперсия — это среднее значение квадратов отклонений, равное квадрату стандартного отклонения. Она полезна во многих статистических формулах, но выражается в квадратных единицах.
Más ejemplos resueltos
Estos ejemplos utilizan el mismo procedimiento cada vez: calcular la media \(\bar{x}\), restarla a cada valor para obtener las desviaciones, elevar al cuadrado esas desviaciones, sumarlas, dividir entre \(n-1\) para una muestra o entre \(n\) para una población, y por último tomar la raíz cuadrada. La única diferencia entre las dos versiones de la desviación estándar es entre qué se divide.
Ejemplo 1 — muestra frente a población con los mismos datos
Conjunto de datos (8 valores): 2, 4, 4, 4, 5, 5, 7, 9.
Paso 1 — media:
$$\bar{x} = \frac{2+4+4+4+5+5+7+9}{8} = \frac{40}{8} = 5$$Paso 2 — desviaciones al cuadrado:
| \(x_i\) | \(x_i - \bar{x}\) | \((x_i - \bar{x})^2\) |
|---|---|---|
| 2 | -3 | 9 |
| 4 | -1 | 1 |
| 4 | -1 | 1 |
| 4 | -1 | 1 |
| 5 | 0 | 0 |
| 5 | 0 | 0 |
| 7 | 2 | 4 |
| 9 | 4 | 16 |
Paso 3 — suma de cuadrados:
$$\sum_{i=1}^{n}(x_i - \bar{x})^2 = 9+1+1+1+0+0+4+16 = 32$$Paso 4 — varianza y desviación estándar. Con \(n = 8\):
Muestra (dividir entre \(n-1 = 7\)):
$$s^2 = \frac{32}{7} \approx 4.5714 \qquad s = \sqrt{4.5714} \approx 2.1381$$Población (dividir entre \(n = 8\)):
$$\sigma^2 = \frac{32}{8} = 4 \qquad \sigma = \sqrt{4} = 2$$Así, los mismos datos dan una desviación estándar muestral de 2.1381 y una desviación estándar poblacional de 2. El valor muestral es ligeramente mayor porque dividir entre el número más pequeño \(n-1\) infla el resultado — esta es la corrección estándar que se utiliza cuando los datos son solo una muestra extraída de un grupo mayor.
Ejemplo 2 — valores decimales y negativos
Conjunto de datos (5 valores): -2, -1, 0, 3, 5.
Media:
$$\bar{x} = \frac{-2 + (-1) + 0 + 3 + 5}{5} = \frac{5}{5} = 1$$Desviaciones al cuadrado:
| \(x_i\) | \(x_i - \bar{x}\) | \((x_i - \bar{x})^2\) |
|---|---|---|
| -2 | -3 | 9 |
| -1 | -2 | 4 |
| 0 | -1 | 1 |
| 3 | 2 | 4 |
| 5 | 4 | 16 |
Suma de cuadrados:
$$\sum_{i=1}^{n}(x_i - \bar{x})^2 = 9+4+1+4+16 = 34$$Varianza y desviación estándar (con \(n = 5\)):
$$s^2 = \frac{34}{4} = 8.5 \qquad s = \sqrt{8.5} \approx 2.9155$$$$\sigma^2 = \frac{34}{5} = 6.8 \qquad \sigma = \sqrt{6.8} \approx 2.6077$$Los valores negativos se tratan exactamente igual que los positivos — elevar al cuadrado las desviaciones elimina el signo, de modo que un valor por debajo de la media aporta tanta dispersión como uno situado a la misma distancia por encima.
Ejemplo 3 — valores equiespaciados
Conjunto de datos (5 valores): 10, 20, 30, 40, 50.
Media:
$$\bar{x} = \frac{10+20+30+40+50}{5} = \frac{150}{5} = 30$$Desviaciones al cuadrado: las desviaciones son -20, -10, 0, 10, 20, por lo que los cuadrados son 400, 100, 0, 100, 400.
$$\sum_{i=1}^{n}(x_i - \bar{x})^2 = 400+100+0+100+400 = 1000$$Varianza y desviación estándar (con \(n = 5\)):
$$s^2 = \frac{1000}{4} = 250 \qquad s = \sqrt{250} \approx 15.8114$$$$\sigma^2 = \frac{1000}{5} = 200 \qquad \sigma = \sqrt{200} \approx 14.1421$$Aunque los valores están perfectamente equiespaciados, la desviación estándar no es el propio espaciado (10) — es una medida cuadrática media de la distancia respecto a la media, que aquí resulta ser de aproximadamente 14.14 para toda la población.
Cómo interpretar tu resultado
La desviación estándar te indica la distancia típica entre un valor de los datos y la media, expresada en las mismas unidades que tus datos. Una desviación estándar pequeña significa que los valores se agrupan estrechamente alrededor de la media; una grande significa que están muy dispersos. Por sí sola, la cifra resulta más útil cuando se compara con la media y con la dispersión de otros conjuntos de datos medidos de la misma manera.
La regla empírica (68–95–99.7)
Cuando un conjunto de datos está aproximadamente distribuido normalmente (la conocida forma de campana simétrica), la desviación estándar \(\sigma\) delimita proporciones predecibles de los datos alrededor de la media \(\bar{x}\):
- Alrededor del 68% de los valores caen dentro de \(\pm 1\sigma\) de la media — el intervalo de \(\bar{x} - \sigma\) a \(\bar{x} + \sigma\).
- Alrededor del 95% caen dentro de \(\pm 2\sigma\).
- Alrededor del 99.7% caen dentro de \(\pm 3\sigma\).
Por ejemplo, si un conjunto de mediciones tiene \(\bar{x} = 100\) y \(\sigma = 15\), entonces aproximadamente el 68% de los datos se sitúa entre 85 y 115, alrededor del 95% entre 70 y 130, y casi todos entre 55 y 145. Esta regla es una aproximación que solo se cumple para datos con forma más o menos de campana — para distribuciones muy sesgadas o de colas pesadas los porcentajes reales pueden diferir sustancialmente.
Decidir si un valor es típico o atípico
Para juzgar un solo valor, mide a cuántas desviaciones estándar se encuentra de la media. Esta es la puntuación estandarizada, o puntuación z:
$$z = \frac{x - \bar{x}}{\sigma}$$Un valor con \(|z|\) menor que aproximadamente 1 es muy corriente; \(|z|\) cercano a 2 es algo inusual (solo alrededor del 5% de los datos normales se sitúa más allá de \(\pm 2\sigma\)); y \(|z|\) de 3 o más es raro (menos del 0.3% de los datos normales), por lo que \(\pm 2\sigma\) o \(\pm 3\sigma\) son umbrales informales comunes para señalar posibles valores atípicos. Estas son convenciones para inspeccionar datos, no una prueba definitiva — una puntuación z grande indica un punto que merece examinarse, no automáticamente un error.
Coeficiente de variación — dispersión relativa
Dado que la desviación estándar lleva unidades, comparar la dispersión entre conjuntos de datos con diferentes escalas o unidades puede resultar engañoso. El coeficiente de variación (CV) lo reescala como una fracción (o porcentaje) de la media:
$$\text{CV} = \frac{\sigma}{\bar{x}}$$Un conjunto de datos con \(\bar{x} = 30\) y \(\sigma \approx 15.81\) tiene \(\text{CV} \approx 15.81 / 30 \approx 0.527\), es decir, alrededor del 52.7% — una dispersión relativamente alta. Un CV del 5% indica valores muy agrupados cerca de la media, mientras que un 50% o más indica una alta variabilidad relativa. El CV solo tiene sentido para datos medidos en una escala de razón con media positiva; es indefinido o inestable cuando la media es cero o cercana a cero, y no debe usarse para datos que puedan ser negativos (como temperaturas en grados Celsius o cifras de pérdidas y ganancias).