Bu hesaplayıcı ne işe yarar?
Ortalama ve Standart Sapma Hesaplayıcısı, girdiğiniz sayı listesini alır ve size ortalamayı, varyansı ve standart sapmayı verir. Ortalama, verilerinizin merkezini gösterirken; standart sapma, değerlerin bu merkez etrafında ne kadar dağıldığını ölçer. Küçük bir standart sapma, değerlerin ortalamaya sıkıca kümelendiği anlamına gelir; büyük bir değer ise verilerin geniş bir aralığa yayıldığını gösterir.
Nasıl kullanılır?
Sayılarınızı virgül veya boşlukla ayırarak giriş kutusuna yazın ya da yapıştırın. Verileriniz daha büyük bir grubun içinden alınmış bir alt küme ise Örneklem seçeneğini, tüm grubu temsil ediyorsa Kütle (Ana Kütle) seçeneğini işaretleyin. Hesaplayıcı bunun ardından ortalamayı, varyansı, standart sapmayı, değer sayısını ve toplamı size sunar.
Formüllerin açıklaması
Önce ortalamayı \(\bar{x}\) hesaplayın; burada \(n\) değer sayısını, \(x_i\) ise her bir değeri ifade eder:
$$\bar{x} = \frac{1}{n}\sum_{i=1}^{n} x_i$$Ardından her değerin ortalamadan sapmasını ölçün, karesini alın ve bu karelerin ortalamasını bulun. Örneklem sürümü \(n-1\)'e, kütle sürümü ise \(n\)'e böler:
$$s = \sqrt{\frac{1}{n-1}\sum_{i=1}^{n}(x_i - \bar{x})^2} \qquad \sigma = \sqrt{\frac{1}{n}\sum_{i=1}^{n}(x_i - \mu)^2}$$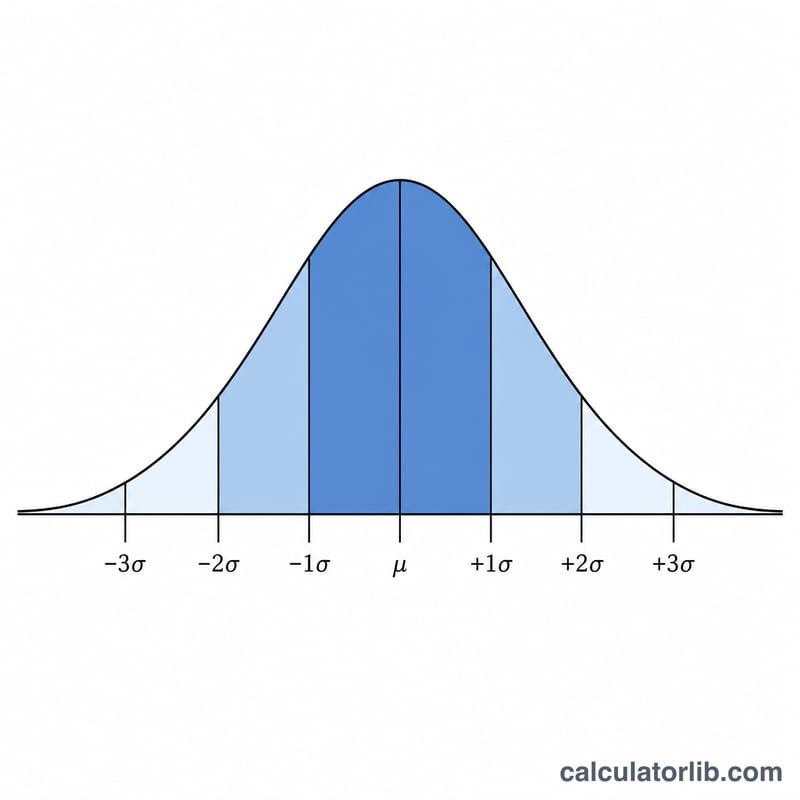
Çözümlü örnek
2, 4, 4, 4, 5, 5, 7, 9 veri kümesini ele alalım. Toplamı 40 olan \(n = 8\) değer vardır; dolayısıyla ortalama şöyledir:
$$\bar{x} = \frac{2+4+4+4+5+5+7+9}{8} = 5$$5'ten olan sapmaların kareleri toplamda 32 eder. Kütle formülünü kullanırsak:
$$\sigma = \sqrt{\frac{32}{8}} = \sqrt{4} = 2$$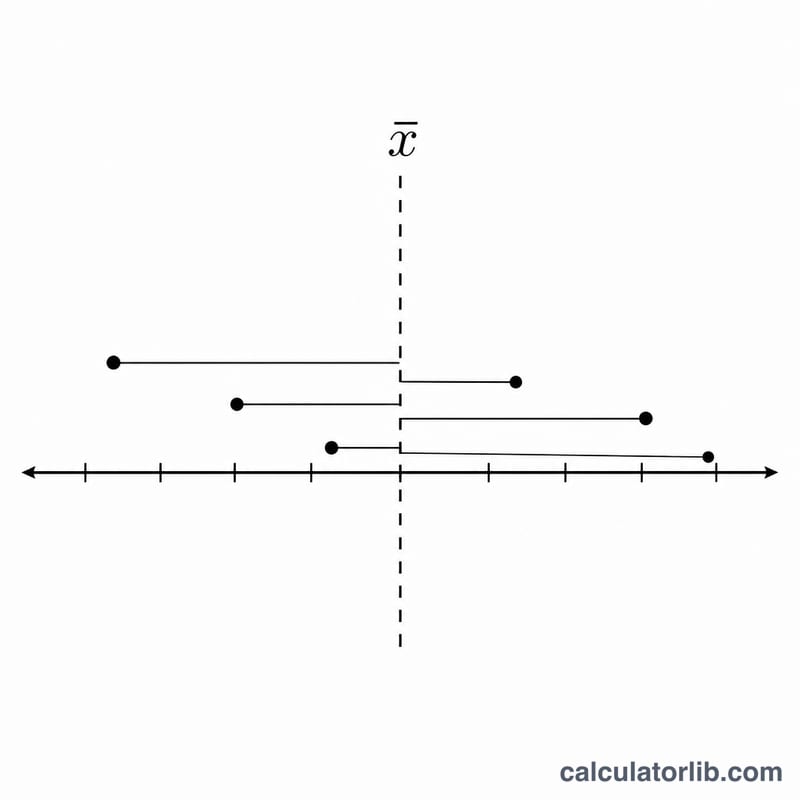
Daha Fazla Çözümlü Örnek
Bu örnekler her seferinde aynı yöntemi kullanır: ortalamayı \(\bar{x}\) bulun, her değerden çıkararak sapmaları elde edin, bu sapmaların karesini alın, hepsini toplayın, bir örneklem için \(n-1\)'e ya da bir anakütle için \(n\)'e bölün ve son olarak karekökünü alın. Standart sapmanın iki sürümü arasındaki tek fark neye böldüğünüzdür.
Örnek 1 — aynı veri üzerinde örneklem ile anakütle karşılaştırması
Veri kümesi (8 değer): 2, 4, 4, 4, 5, 5, 7, 9.
1. Adım — ortalama:
$$\bar{x} = \frac{2+4+4+4+5+5+7+9}{8} = \frac{40}{8} = 5$$2. Adım — kareli sapmalar:
| \(x_i\) | \(x_i - \bar{x}\) | \((x_i - \bar{x})^2\) |
|---|---|---|
| 2 | -3 | 9 |
| 4 | -1 | 1 |
| 4 | -1 | 1 |
| 4 | -1 | 1 |
| 5 | 0 | 0 |
| 5 | 0 | 0 |
| 7 | 2 | 4 |
| 9 | 4 | 16 |
3. Adım — karelerin toplamı:
$$\sum_{i=1}^{n}(x_i - \bar{x})^2 = 9+1+1+1+0+0+4+16 = 32$$4. Adım — varyans ve standart sapma. \(n = 8\) ile:
Örneklem (\(n-1 = 7\)'ye bölünür):
$$s^2 = \frac{32}{7} \approx 4.5714 \qquad s = \sqrt{4.5714} \approx 2.1381$$Anakütle (\(n = 8\)'e bölünür):
$$\sigma^2 = \frac{32}{8} = 4 \qquad \sigma = \sqrt{4} = 2$$Böylece aynı veri, 2.1381 örneklem standart sapması ve 2 anakütle standart sapması verir. Örneklem değeri biraz daha büyüktür, çünkü daha küçük olan \(n-1\) sayısına bölmek sonucu şişirir — bu, verinin yalnızca daha büyük bir gruptan çekilmiş bir örneklem olduğunda kullanılan standart düzeltmedir.
Örnek 2 — ondalıklı ve negatif değerler
Veri kümesi (5 değer): -2, -1, 0, 3, 5.
Ortalama:
$$\bar{x} = \frac{-2 + (-1) + 0 + 3 + 5}{5} = \frac{5}{5} = 1$$Kareli sapmalar:
| \(x_i\) | \(x_i - \bar{x}\) | \((x_i - \bar{x})^2\) |
|---|---|---|
| -2 | -3 | 9 |
| -1 | -2 | 4 |
| 0 | -1 | 1 |
| 3 | 2 | 4 |
| 5 | 4 | 16 |
Karelerin toplamı:
$$\sum_{i=1}^{n}(x_i - \bar{x})^2 = 9+4+1+4+16 = 34$$Varyans ve standart sapma (\(n = 5\) ile):
$$s^2 = \frac{34}{4} = 8.5 \qquad s = \sqrt{8.5} \approx 2.9155$$$$\sigma^2 = \frac{34}{5} = 6.8 \qquad \sigma = \sqrt{6.8} \approx 2.6077$$Negatif değerler tam olarak pozitif değerler gibi ele alınır — sapmaların karesi alındığında işaret ortadan kalkar, dolayısıyla ortalamanın altındaki bir değer, aynı uzaklıkta ortalamanın üstündeki bir değer kadar yayılıma katkıda bulunur.
Örnek 3 — eşit aralıklı değerler
Veri kümesi (5 değer): 10, 20, 30, 40, 50.
Ortalama:
$$\bar{x} = \frac{10+20+30+40+50}{5} = \frac{150}{5} = 30$$Kareli sapmalar: sapmalar -20, -10, 0, 10, 20 olduğundan, kareleri 400, 100, 0, 100, 400 olur.
$$\sum_{i=1}^{n}(x_i - \bar{x})^2 = 400+100+0+100+400 = 1000$$Varyans ve standart sapma (\(n = 5\) ile):
$$s^2 = \frac{1000}{4} = 250 \qquad s = \sqrt{250} \approx 15.8114$$$$\sigma^2 = \frac{1000}{5} = 200 \qquad \sigma = \sqrt{200} \approx 14.1421$$Değerler kusursuz biçimde eşit aralıklı olsa bile, standart sapma aralığın kendisi (10) değildir — bu, ortalamadan olan uzaklığın karekök-ortalama-kare ölçüsüdür ve burada tüm anakütle için yaklaşık 14.14 olarak hesaplanır.
Sonucunuzu Yorumlama
Standart sapma, bir veri değeri ile ortalama arasındaki tipik uzaklığı, verinizle aynı birimlerle ifade ederek size gösterir. Küçük bir standart sapma, değerlerin ortalama etrafında sıkıca toplandığı anlamına gelir; büyük bir standart sapma ise geniş biçimde dağıldıkları anlamına gelir. Tek başına bu sayı, en çok ortalamayla ve aynı şekilde ölçülen diğer veri kümelerinin yayılımıyla karşılaştırıldığında yararlıdır.
Ampirik (68–95–99.7) kural
Bir veri kümesi yaklaşık olarak normal dağılıma sahip olduğunda (tanıdık simetrik çan biçimi), standart sapma \(\sigma\) verinin ortalama \(\bar{x}\) etrafındaki öngörülebilir oranlarını belirler:
- Değerlerin yaklaşık %68'i ortalamanın \(\pm 1\sigma\) sınırları içinde kalır — \(\bar{x} - \sigma\) ile \(\bar{x} + \sigma\) aralığı.
- Yaklaşık %95'i \(\pm 2\sigma\) içinde kalır.
- Yaklaşık %99.7'si \(\pm 3\sigma\) içinde kalır.
Örneğin, bir ölçüm kümesinin \(\bar{x} = 100\) ve \(\sigma = 15\) değerleri varsa, verinin kabaca %68'i 85 ile 115 arasında, yaklaşık %95'i 70 ile 130 arasında ve neredeyse tamamı 55 ile 145 arasında yer alır. Bu kural yalnızca kabaca çan biçimli veriler için geçerli olan bir yaklaşımdır — güçlü biçimde çarpık veya ağır kuyruklu dağılımlar için gerçek yüzdeler önemli ölçüde farklı olabilir.
Bir değerin tipik mi yoksa aykırı değer mi olduğuna karar verme
Tek bir değeri değerlendirmek için, onun ortalamadan kaç standart sapma uzakta durduğunu ölçün. Bu, standartlaştırılmış puandır ya da z-puanı:
$$z = \frac{x - \bar{x}}{\sigma}$$\(|z|\) değeri yaklaşık 1'den küçük olan bir değer çok sıradandır; \(|z|\) yaklaşık 2 civarında olan biraz alışılmadıktır (normal verinin yalnızca yaklaşık %5'i \(\pm 2\sigma\) dışında yer alır); ve \(|z|\) değeri 3 veya daha fazla olan nadirdir (normal verinin %0.3'ünün altında), bu yüzden \(\pm 2\sigma\) veya \(\pm 3\sigma\) olası aykırı değerleri işaretlemek için yaygın gayriresmî eşiklerdir. Bunlar veriyi incelemek için kullanılan geleneklerdir, kesin bir test değildir — büyük bir z-puanı incelenmeye değer bir noktaya işaret eder, otomatik olarak bir hataya değil.
Değişim katsayısı — göreli yayılım
Standart sapma birim taşıdığı için, farklı ölçekler veya birimlerdeki veri kümeleri arasında yayılımı karşılaştırmak yanıltıcı olabilir. Değişim katsayısı (CV) bunu ortalamanın bir kesri (ya da yüzdesi) olarak yeniden ölçeklendirir:
$$\text{DK} = \frac{\sigma}{\bar{x}}$$\(\bar{x} = 30\) ve \(\sigma \approx 15.81\) olan bir veri kümesinin \(\text{DK} \approx 15.81 / 30 \approx 0.527\), yani yaklaşık %52.7 değeri vardır — nispeten yüksek bir yayılım. %5'lik bir CV, değerlerin ortalama yakınında sıkıca gruplandığını gösterirken, %50 veya daha fazlası yüksek göreli değişkenliği gösterir. CV yalnızca pozitif ortalamalı bir oran ölçeğinde ölçülen veriler için anlamlıdır; ortalama sıfır veya sıfıra yakın olduğunda tanımsız veya kararsızdır ve negatif olabilen veriler için (örneğin Celsius cinsinden sıcaklıklar veya kâr-zarar rakamları) kullanılmamalıdır.
Sıkça sorulan sorular
Örneklem ile kütle arasındaki fark nedir? Verileriniz grubun her bir üyesini kapsıyorsa kütle standart sapmasını kullanın. Verileriniz yalnızca bir örneklemse, \(n-1\)'e bölen örneklem standart sapmasını kullanın; çünkü bu, gerçek dağılımın daha az yanlı bir tahminini verir.
Sapmaların karesi neden alınır? Kare almak her sapmayı pozitif yapar ve büyük hatalara daha fazla ağırlık verir; sonda karekök alındığında ise sonuç yeniden orijinal birimine döner.
Varyans bana ne anlatır? Varyans, sapmaların karelerinin ortalamasıdır ve standart sapmanın karesine eşittir. Birçok istatistik formülünde işe yarar; ancak birimin karesi cinsinden ifade edilir.