このツールでできること
平均・標準偏差 計算ツールは、入力した数値のリストから平均(アベレージ)、分散、標準偏差をまとめて算出します。平均はデータの中心を表し、標準偏差はその中心のまわりに値がどれだけばらついているかを示す指標です。標準偏差が小さいほど値は平均の近くに密集しており、大きいほど広く散らばっていることを意味します。
使い方
入力欄に数値を、カンマまたはスペースで区切って入力または貼り付けてください。データが大きな集団から抽出した一部であれば標本を、集団全体を表しているなら母集団を選びます。すると、平均・分散・標準偏差・データ数・合計が表示されます。
計算式の解説
まず平均 \(\bar{x}\) を求めます。ここで \(n\) はデータの個数、\(x_i\) は各値です。
$$\bar{x} = \frac{1}{n}\sum_{i=1}^{n} x_i$$次に、各値が平均からどれだけ離れているか(偏差)を求めて2乗し、その平均をとります。標本の場合は \(n-1\) で割り、母集団の場合は \(n\) で割ります。
$$s = \sqrt{\frac{1}{n-1}\sum_{i=1}^{n}(x_i - \bar{x})^2} \qquad \sigma = \sqrt{\frac{1}{n}\sum_{i=1}^{n}(x_i - \mu)^2}$$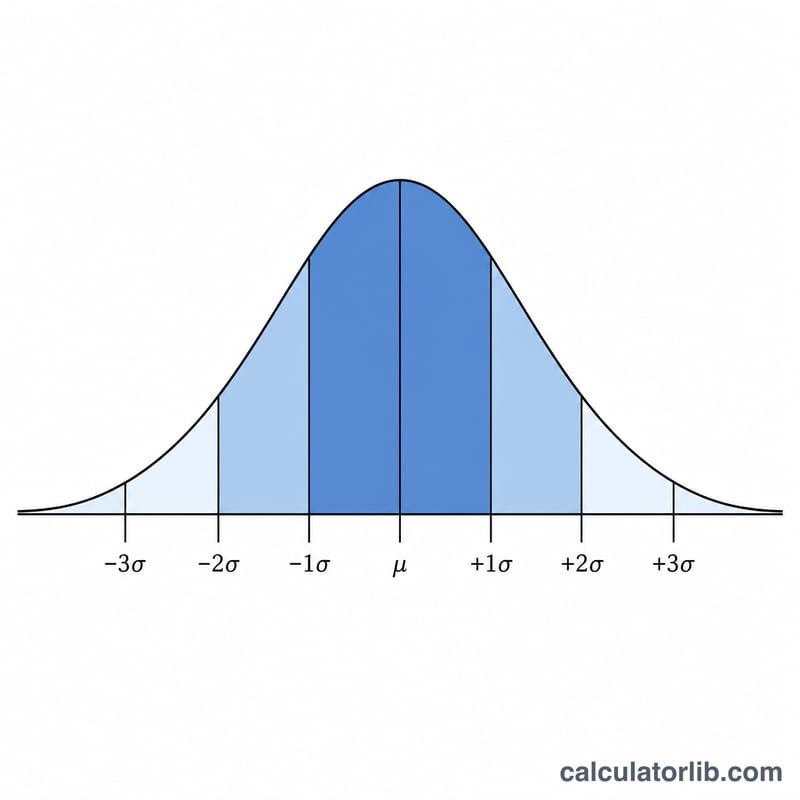
計算例
データセット 2, 4, 4, 4, 5, 5, 7, 9 を例にとります。値は \(n = 8\) 個あり、合計は 40 なので、平均は次のようになります。
$$\bar{x} = \frac{2+4+4+4+5+5+7+9}{8} = 5$$5 からの偏差を2乗した合計は 32 です。母集団の式を使うと次のようになります。
$$\sigma = \sqrt{\frac{32}{8}} = \sqrt{4} = 2$$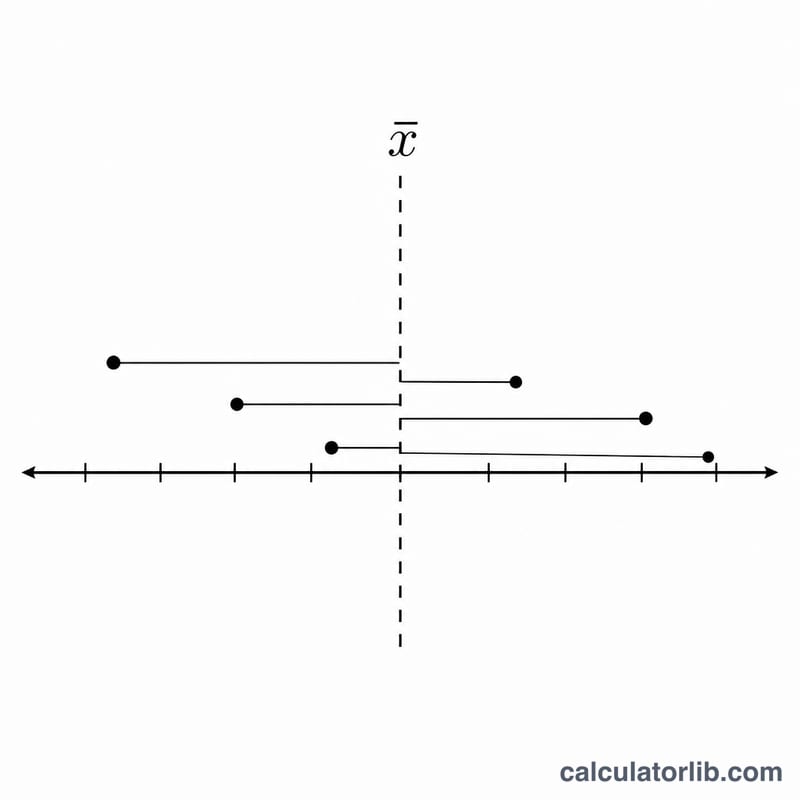
さらに詳しい計算例
これらの例では、毎回同じ手順を用います。平均 \(\bar{x}\) を求め、それを各値から引いて偏差を求め、その偏差を二乗し、それらを合計し、標本の場合は \(n-1\) で、母集団の場合は \(n\) で割り、最後に平方根をとります。標準偏差の2つの版の唯一の違いは、何で割るかだけです。
例1 — 同じデータでの標本と母集団の比較
データセット(8個の値): 2, 4, 4, 4, 5, 5, 7, 9。
ステップ1 — 平均:
$$\bar{x} = \frac{2+4+4+4+5+5+7+9}{8} = \frac{40}{8} = 5$$ステップ2 — 偏差の二乗:
| \(x_i\) | \(x_i - \bar{x}\) | \((x_i - \bar{x})^2\) |
|---|---|---|
| 2 | -3 | 9 |
| 4 | -1 | 1 |
| 4 | -1 | 1 |
| 4 | -1 | 1 |
| 5 | 0 | 0 |
| 5 | 0 | 0 |
| 7 | 2 | 4 |
| 9 | 4 | 16 |
ステップ3 — 二乗の合計:
$$\sum_{i=1}^{n}(x_i - \bar{x})^2 = 9+1+1+1+0+0+4+16 = 32$$ステップ4 — 分散と標準偏差。 \(n = 8\) の場合:
標本(\(n-1 = 7\) で割る):
$$s^2 = \frac{32}{7} \approx 4.5714 \qquad s = \sqrt{4.5714} \approx 2.1381$$母集団(\(n = 8\) で割る):
$$\sigma^2 = \frac{32}{8} = 4 \qquad \sigma = \sqrt{4} = 2$$したがって、同じデータから、標本標準偏差は 2.1381 となり、母集団標準偏差は 2 となります。標本の値がわずかに大きいのは、より小さい数 \(n-1\) で割ることで結果が大きくなるためです。これは、データがより大きな集団から抽出された標本にすぎない場合に用いられる標準的な補正です。
例2 — 小数と負の値
データセット(5個の値): -2, -1, 0, 3, 5。
平均:
$$\bar{x} = \frac{-2 + (-1) + 0 + 3 + 5}{5} = \frac{5}{5} = 1$$偏差の二乗:
| \(x_i\) | \(x_i - \bar{x}\) | \((x_i - \bar{x})^2\) |
|---|---|---|
| -2 | -3 | 9 |
| -1 | -2 | 4 |
| 0 | -1 | 1 |
| 3 | 2 | 4 |
| 5 | 4 | 16 |
二乗の合計:
$$\sum_{i=1}^{n}(x_i - \bar{x})^2 = 9+4+1+4+16 = 34$$分散と標準偏差(\(n = 5\) の場合):
$$s^2 = \frac{34}{4} = 8.5 \qquad s = \sqrt{8.5} \approx 2.9155$$$$\sigma^2 = \frac{34}{5} = 6.8 \qquad \sigma = \sqrt{6.8} \approx 2.6077$$負の値も正の値とまったく同じように扱われます。偏差を二乗すると符号がなくなるため、平均より下の値も、同じ距離だけ上にある値とまったく同じだけ散らばりに寄与します。
例3 — 等間隔の値
データセット(5個の値): 10, 20, 30, 40, 50。
平均:
$$\bar{x} = \frac{10+20+30+40+50}{5} = \frac{150}{5} = 30$$偏差の二乗: 偏差は -20, -10, 0, 10, 20 なので、その二乗は 400, 100, 0, 100, 400 です。
$$\sum_{i=1}^{n}(x_i - \bar{x})^2 = 400+100+0+100+400 = 1000$$分散と標準偏差(\(n = 5\) の場合):
$$s^2 = \frac{1000}{4} = 250 \qquad s = \sqrt{250} \approx 15.8114$$$$\sigma^2 = \frac{1000}{5} = 200 \qquad \sigma = \sqrt{200} \approx 14.1421$$値が完全に等間隔であっても、標準偏差はその間隔そのもの(10)ではありません。これは平均からの距離の二乗平均平方根による尺度であり、ここでは母集団全体でおよそ 14.14 となります。
結果の解釈
標準偏差は、データの値と平均との間の典型的な距離を、データと同じ単位で表したものです。標準偏差が小さいということは、値が平均の周りに密に集まっていることを意味し、大きいということは、値が広く散らばっていることを意味します。この数値単独では、平均と比較したり、同じ方法で測定された他のデータセットの散らばりと比較したりするときに最も役立ちます。
経験則(68–95–99.7 の法則)
データセットがおおよそ正規分布している(よく知られた左右対称の釣鐘型をしている)場合、標準偏差 \(\sigma\) は平均 \(\bar{x}\) の周りにあるデータの予測可能な割合を示します:
- 値の約 68% が平均から \(\pm 1\sigma\) の範囲、すなわち \(\bar{x} - \sigma\) から \(\bar{x} + \sigma\) の区間に収まります。
- 約 95% が \(\pm 2\sigma\) の範囲に収まります。
- 約 99.7% が \(\pm 3\sigma\) の範囲に収まります。
例えば、ある測定値の集合が \(\bar{x} = 100\)、\(\sigma = 15\) である場合、データのおよそ 68% が 85 から 115 の間に、約 95% が 70 から 130 の間に、そしてそのほとんどすべてが 55 から 145 の間にあります。この法則は、おおよそ釣鐘型のデータに対してのみ成り立つ近似であり、強く歪んでいたり、裾が重い分布の場合には、実際の割合が大きく異なることがあります。
値が典型的か外れ値かを判断する
単一の値を判断するには、それが平均から標準偏差いくつ分離れているかを測ります。これが標準化された得点、すなわち z 得点 です:
$$z = \frac{x - \bar{x}}{\sigma}$$\(|z|\) が約 1 未満の値はごく普通であり、\(|z|\) が 2 に近い値はやや珍しく(正規データのうち \(\pm 2\sigma\) を超えるものは約 5% だけ)、\(|z|\) が 3 以上の値はまれです(正規データの 0.3% 未満)。このため、\(\pm 2\sigma\) や \(\pm 3\sigma\) が、外れ値の可能性を検出するためのよく使われる非公式のしきい値となっています。これらはデータを吟味するための慣例であって、決定的な検定ではありません。大きな z 得点は、調べる価値のある点を示すものであり、自動的に誤りを意味するわけではありません。
変動係数 — 相対的な散らばり
標準偏差は単位を持つため、スケールや単位の異なるデータセット間で散らばりを比較すると誤解を招くことがあります。変動係数(CV) は、それを平均に対する割合(またはパーセント)として尺度を調整し直します:
$$\text{CV} = \frac{\sigma}{\bar{x}}$$\(\bar{x} = 30\)、\(\sigma \approx 15.81\) のデータセットでは \(\text{CV} \approx 15.81 / 30 \approx 0.527\)、すなわち約 52.7% となり、比較的大きな散らばりを示します。CV が 5% であれば値が平均の近くに密に集まっていることを示し、50% 以上であれば相対的な変動が大きいことを示します。CV は、正の平均を持つ比率尺度で測定されたデータに対してのみ意味を持ちます。平均がゼロまたはゼロに近い場合には未定義または不安定になり、負の値をとりうるデータ(摂氏温度や損益の数値など)には使用すべきではありません。
よくある質問
標本と母集団の違いは? データが集団のすべての要素を含んでいる場合は母標準偏差を使います。データが集団の一部(標本)にすぎない場合は、\(n-1\) で割る標本標準偏差を使います。こちらの方が、真のばらつきをより偏りなく推定できるためです。
なぜ偏差を2乗するの? 2乗することですべての偏差が正の値になり、大きな誤差ほど強く反映されます。最後に平方根をとることで、結果を元の単位に戻すことができます。
分散は何を表すの? 分散は偏差の2乗の平均で、標準偏差の2乗に等しい値です。多くの統計計算で役立ちますが、単位が2乗されている点に注意が必要です。