プールされた標準偏差とは?
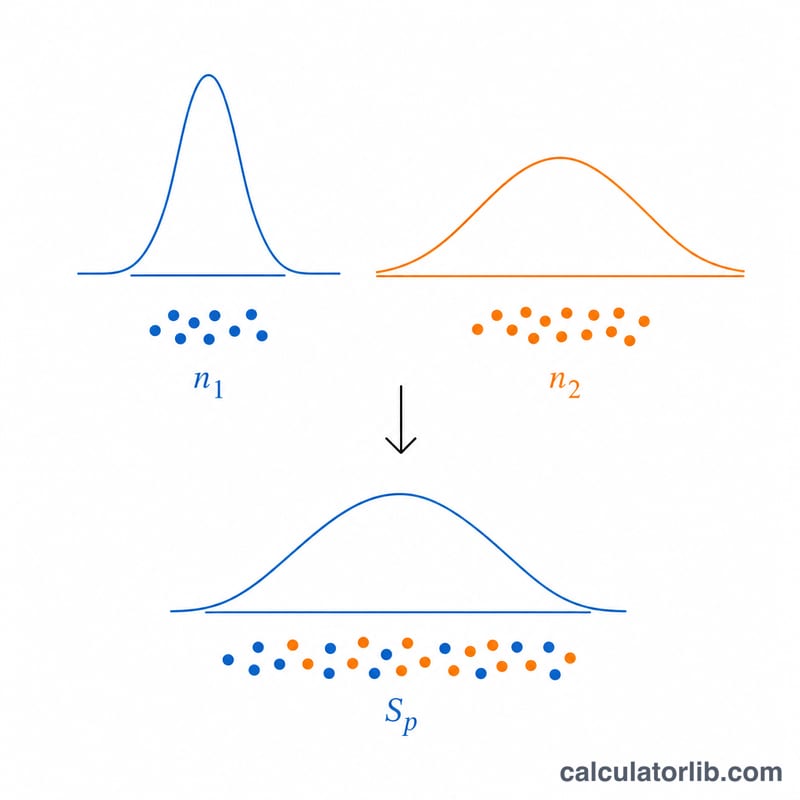
プールされた標準偏差(Sp)とは、2つの標本標準偏差を加重平均し、共通する母標準偏差の推定値として1つにまとめたものです。独立した2つの標本が「同じ分散をもつ母集団」から得られたと仮定できる場合に用います。この推定値は、2標本のt検定、効果量を表すCohenのd、そして2つの平均値の差に関する信頼区間の計算において中心的な役割を果たします。
このツールの使い方
各標本のサンプルサイズ(\(n_1\) と \(n_2\))と、それぞれの標準偏差(\(s_1\) と \(s_2\))を入力してください。プールされた標準偏差に加えて、プール分散(\(S_p^2\))と自由度(\(n_1 + n_2 - 2\))が算出されます。自由度を正の値に保つため、各標本には少なくとも2つ以上の観測値が必要です。
計算式の解説
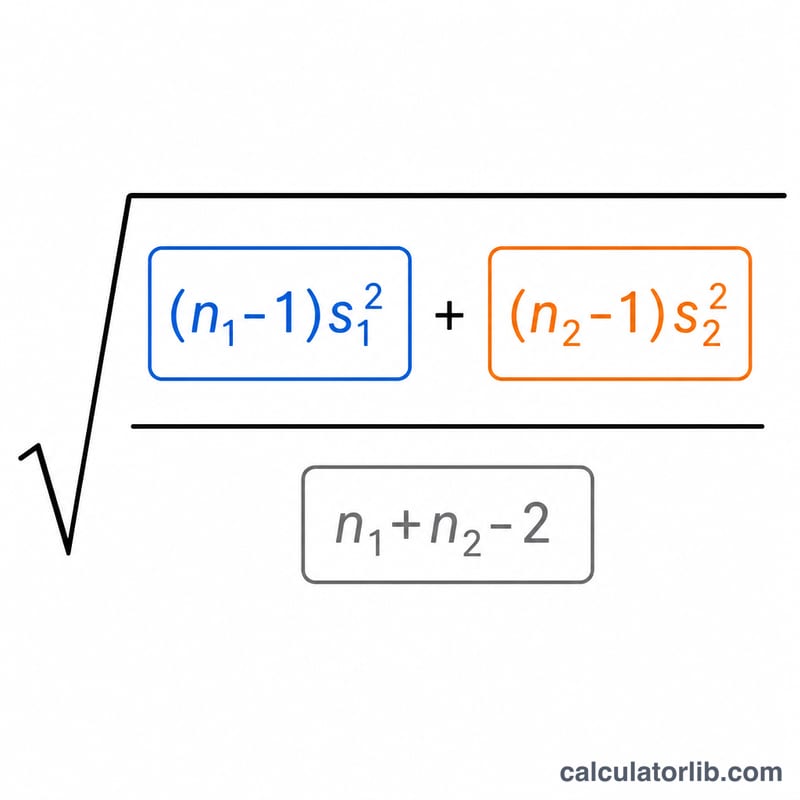
プール分散は、各標本の分散をその自由度(\(n - 1\))で重み付けして求めます。
$$S_p^2 = \frac{(n_1-1)\cdot s_1^2 + (n_2-1)\cdot s_2^2}{n_1 + n_2 - 2}$$
この値の平方根をとると、プールされた標準偏差 \(S_p\) が得られます。サンプルサイズが大きい標本ほど推定値への寄与が大きくなります。これが、単純な平均ではなく加重平均を用いる理由です。
計算例
標本1が \(n_1 = 10\)、\(s_1 = 5\)、標本2が \(n_2 = 12\)、\(s_2 = 6\) だとします。このとき \((10-1)\cdot 25 = 225\)、\((12-1)\cdot 36 = 396\) となり、合計は 621 です。自由度は \(10 + 12 - 2 = 20\) なので、$$S_p^2 = \frac{621}{20} = 31.05, \quad S_p = \sqrt{31.05} \approx 5.5722$$ となります。
シナリオごとの併合標準偏差の変化
併合分散は、2つの標本分散の加重平均であり、重みは各標本の自由度に等しくなります: \(S_p^2 = \dfrac{(n_1-1)s_1^2 + (n_2-1)s_2^2}{n_1+n_2-2}\)。表はこの式を4つのシナリオに適用しています。
| シナリオ | n₁ | s₁ | n₂ | s₂ | 併合分散 | Sp | 自由度 |
|---|---|---|---|---|---|---|---|
| A. 標本サイズが等しく、標準偏差が異なる | 20 | 4 | 20 | 8 | (19·16 + 19·64)/38 = 40 | 6.3246 | 38 |
| B. 標本サイズが不等しく、大きい標本が支配的 | 10 | 5 | 40 | 10 | (9·25 + 39·100)/48 = 85.9375 | 9.2702 | 48 |
| C. 標準偏差が同一 | 12 | 6 | 30 | 6 | (11·36 + 29·36)/40 = 36 | 6 | 40 |
| D. 標準偏差が大きい小標本 | 8 | 12 | 50 | 4 | (7·144 + 49·16)/56 = 32 | 5.6569 | 56 |
- シナリオA: 標本サイズが等しい場合、Spは2つの標準偏差の二乗平均平方根になります: \(\sqrt{(4^2+8^2)/2} = \sqrt{40} \approx 6.3246\)。これは単純平均の6よりも大きくなります。
- シナリオB: 2つ目の標本は観測数が4倍あるため、Sp(9.27)はs₁ = 5よりもs₂ = 10にはるかに近い値になります。
- シナリオC: s₁ = s₂ の場合、重みは関係なく、標本サイズに関係なくSpはその共通の標準偏差に等しくなります。
- シナリオD: 50観測の標本の標準偏差の方が小さいため、小標本の標準偏差12がはるかに大きいにもかかわらず、Sp(5.66)は4の方へ引き寄せられます。
併合標準偏差の解釈
- 常にs₁とs₂の間にある: Sp²は正の重みを持つs₁²とs₂²の加重平均であるため、\(\min(s_1, s_2) \le S_p \le \max(s_1, s_2)\)。s₁ = s₂ の場合にのみ両者に等しくなります。
- 共通の標準偏差の推定値: 両母集団の分散が同じσ²であるという仮定の下では、Sp²はσ²の統合推定値です。両標本の情報を用いるため、どちらか一方のsだけよりも安定しています。
- 平均の差の標準誤差: $$SE = S_p\sqrt{\frac{1}{n_1}+\frac{1}{n_2}}$$ シナリオAでは、\(SE = \sqrt{40}\cdot\sqrt{0.1} = \sqrt{4} = 2\)。
- コーエンのd: $$d = \frac{\bar{x}_1 - \bar{x}_2}{S_p}$$ シナリオAでは、平均の差が5の場合、\(d = 5/6.3246 \approx 0.79\)。
- 自由度: \(df = n_1 + n_2 - 2\) は、併合(スチューデント)の2標本t検定におけるt分布の自由度です。シナリオAの自由度は38、シナリオBの自由度は48です。
- 等分散の仮定の確認: 経験則として、大きい方の標準偏差が小さい方の約2倍を超える場合(分散比が約4を超える場合)、併合は疑問視されます。標本サイズが異なる場合は特にそうです。その場合、分散を併合しないWelchのt検定が一般に代わりに用いられます。シナリオAの標準偏差比はちょうど2で、シナリオDの比は3です。
計算の約束事と境界ケース
以下の各ケースは実際にこの計算ツールで計算したもので、結果欄はツールが返す値そのものです。
| ケース | 入力 | 結果 |
|---|---|---|
| 10人と12人の群 (標準偏差5と6) | 10, 5, 12, 6 | 5.5723 |
| 各群に値が1つ | 1, 5, 1, 6 | プールした標準偏差には、各群に2つ以上の値が必要です。 |
2026-11-08に確認
よくある質問
どんなときに標準偏差をプールすべきですか? 2つのグループの母分散が等しいと仮定できる場合にプールします。分散が大きく異なる場合は、代わりにウェルチのt検定を使いましょう。
なぜ n ではなく n − 1 を使うのですか? \(n - 1\)(ベッセルの補正)を用いることで、標本から母分散の不偏推定量が得られるためです。
標本の順番は結果に影響しますか? いいえ。2つの標本を入れ替えても、プールされた標準偏差は同じ値になります。