Qu'est-ce que l'écart-type combiné ?
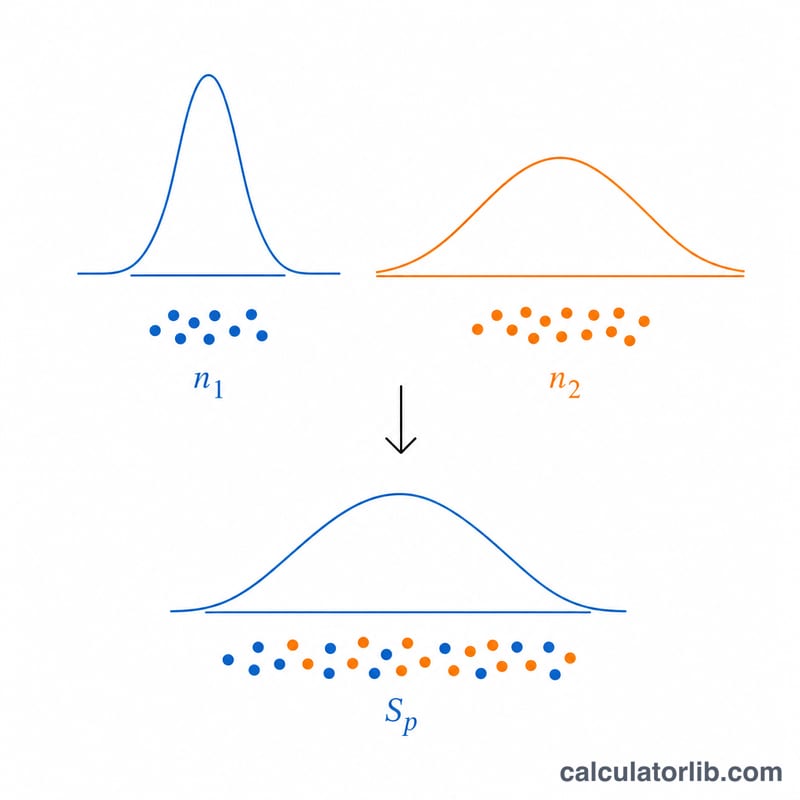
L'écart-type combiné (Sp), parfois appelé écart-type groupé ou poolé, est une moyenne pondérée des écarts-types de deux échantillons, réunis en une seule estimation de l'écart-type commun de la population. On l'utilise lorsqu'on suppose que deux échantillons indépendants proviennent de populations partageant la même variance. Cette estimation combinée est au cœur du test t à deux échantillons, de la taille d'effet d de Cohen et des intervalles de confiance portant sur la différence entre deux moyennes.
Comment utiliser ce calculateur
Saisissez l'effectif de chaque échantillon (\(n_1\) et \(n_2\)) ainsi que l'écart-type de chacun (\(s_1\) et \(s_2\)). Le calculateur renvoie l'écart-type combiné, la variance combinée (\(S_p^2\)) et le nombre de degrés de liberté (\(n_1 + n_2 - 2\)). Chaque échantillon doit compter au moins deux observations afin que les degrés de liberté restent positifs.
La formule expliquée
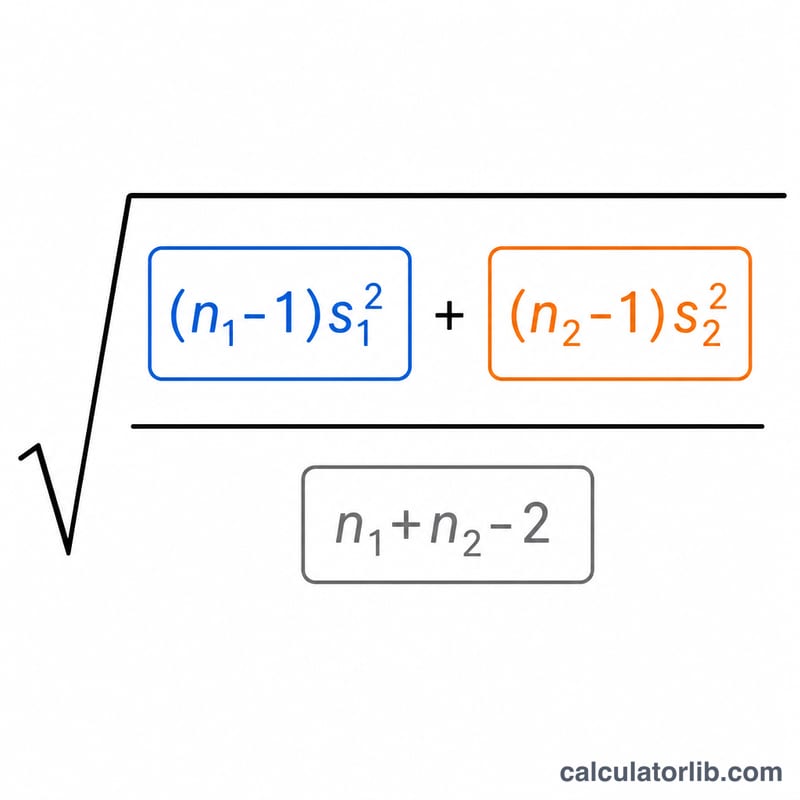
La variance combinée pondère la variance de chaque échantillon par son nombre de degrés de liberté (\(n - 1\)) :
$$S_p^2 = \frac{(n_1 - 1)\,s_1^{2} + (n_2 - 1)\,s_2^{2}}{n_1 + n_2 - 2}$$
En extrayant la racine carrée, on obtient l'écart-type combiné, \(S_p\). Les échantillons de grande taille pèsent davantage dans l'estimation combinée : c'est pourquoi les variances sont pondérées plutôt que simplement moyennées.
Exemple résolu
Supposons que l'échantillon 1 ait \(n_1 = 10\) et \(s_1 = 5\), et que l'échantillon 2 ait \(n_2 = 12\) et \(s_2 = 6\). On obtient alors \((10-1)\cdot 25 = 225\) et \((12-1)\cdot 36 = 396\), soit une somme de \(621\). Les degrés de liberté valent \(10 + 12 - 2 = 20\), d'où $$S_p^2 = \frac{621}{20} = 31{,}05 \quad\text{et}\quad S_p = \sqrt{31{,}05} \approx 5{,}5722.$$
Comment l'écart-type poolé évolue selon les scénarios
La variance poolée est une moyenne pondérée des deux variances d'échantillon, avec pour poids le nombre de degrés de liberté de chaque échantillon : \(S_p^2 = \dfrac{(n_1-1)s_1^2 + (n_2-1)s_2^2}{n_1+n_2-2}\). Le tableau l'applique à quatre scénarios.
| Scénario | n₁ | s₁ | n₂ | s₂ | Variance poolée | Sp | ddl |
|---|---|---|---|---|---|---|---|
| A. n égaux, écarts-types différents | 20 | 4 | 20 | 8 | (19·16 + 19·64)/38 = 40 | 6.3246 | 38 |
| B. n inégaux, le plus grand échantillon domine | 10 | 5 | 40 | 10 | (9·25 + 39·100)/48 = 85.9375 | 9.2702 | 48 |
| C. Écarts-types identiques | 12 | 6 | 30 | 6 | (11·36 + 29·36)/40 = 36 | 6 | 40 |
| D. Petit échantillon à écart-type plus grand | 8 | 12 | 50 | 4 | (7·144 + 49·16)/56 = 32 | 5.6569 | 56 |
- Scénario A : avec des tailles d'échantillon égales, Sp est la moyenne quadratique des deux écarts-types : \(\sqrt{(4^2+8^2)/2} = \sqrt{40} \approx 6.3246\). Cette valeur est supérieure à la moyenne simple de 6.
- Scénario B : le second échantillon compte quatre fois plus d'observations, donc Sp (9,27) se situe beaucoup plus près de s₂ = 10 que de s₁ = 5.
- Scénario C : lorsque s₁ = s₂, les poids n'ont pas d'importance et Sp est égal à cet écart-type commun, quelles que soient les tailles d'échantillon.
- Scénario D : l'échantillon de 50 observations a l'écart-type le plus faible, donc Sp (5,66) est tiré vers 4, bien que le petit échantillon ait un écart-type beaucoup plus grand, égal à 12.
Interpréter l'écart-type poolé
- Toujours compris entre s₁ et s₂ : puisque Sp² est une moyenne pondérée de s₁² et s₂² avec des poids positifs, \(\min(s_1, s_2) \le S_p \le \max(s_1, s_2)\). Il est égal à chacun des deux uniquement lorsque s₁ = s₂.
- Estimation d'un écart-type commun : sous l'hypothèse que les deux populations ont la même variance σ², Sp² est l'estimation combinée de σ². Elle utilise l'information des deux échantillons, elle est donc plus stable que l'un ou l'autre s pris isolément.
- Erreur standard de la différence des moyennes : $$SE = S_p\sqrt{\frac{1}{n_1}+\frac{1}{n_2}}$$ Dans le scénario A, \(SE = \sqrt{40}\cdot\sqrt{0.1} = \sqrt{4} = 2\).
- d de Cohen : $$d = \frac{\bar{x}_1 - \bar{x}_2}{S_p}$$ Dans le scénario A, une différence de moyennes de 5 donne \(d = 5/6.3246 \approx 0.79\).
- Degrés de liberté : \(df = n_1 + n_2 - 2\) est le nombre de degrés de liberté de la distribution t dans le test t de Student à deux échantillons avec variances poolées. Le scénario A a df = 38 et le scénario B a df = 48.
- Vérifier l'hypothèse d'égalité des variances : une règle empirique courante veut que si le plus grand écart-type dépasse d'environ 2 fois le plus petit (un rapport de variances supérieur à environ 4), le regroupement soit discutable. Cela est particulièrement vrai lorsque les tailles d'échantillon diffèrent. Dans ce cas, on utilise généralement le test t de Welch, qui ne regroupe pas les variances. Le scénario A a un rapport d'écarts-types exactement égal à 2, et le scénario D a un rapport de 3.
Conventions et cas limites
Chaque cas ci-dessous a été passé dans ce calculateur ; la colonne résultat indique ce qu’il renvoie réellement.
| Cas | Entrée | Résultat |
|---|---|---|
| Groupes de 10 et 12 (écart-type 5 et 6) | 10, 5, 12, 6 | 5,5723 |
| Une valeur par groupe | 1, 5, 1, 6 | L’écart type combiné nécessite au moins 2 valeurs dans chaque groupe. |
Vérifié le 2026-11-08
FAQ
Quand faut-il combiner les écarts-types ? Combinez-les lorsque l'on suppose que les deux groupes ont des variances de population égales. Si les variances diffèrent fortement, préférez le test t de Welch.
Pourquoi utiliser \(n - 1\) plutôt que \(n\) ? L'emploi de \(n - 1\) (correction de Bessel) fournit une estimation sans biais de la variance à partir d'un échantillon.
L'ordre des échantillons a-t-il une importance ? Non. Intervertir les deux échantillons donne exactement le même écart-type combiné.